LightNav-0: 激发 VLM 空间智能实现通用具身导航
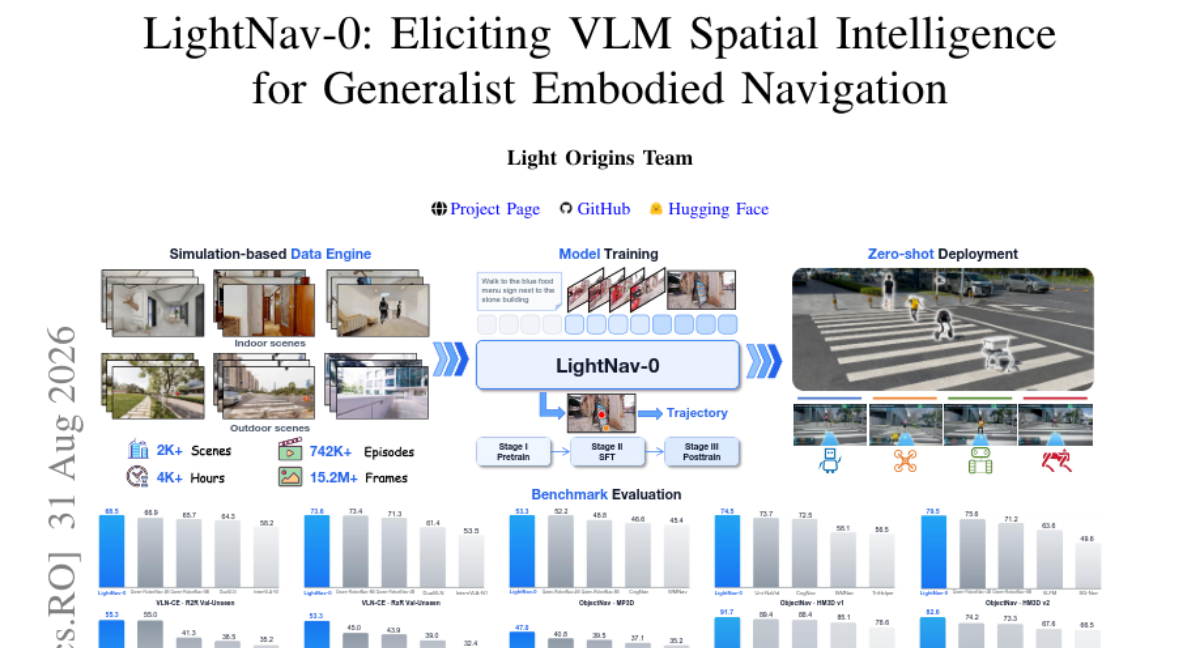
具身导航要求智能体将异质目标和视觉观察转化为跨任务、环境和机器人形态的行动。现代视觉语言模型(VLM)虽已编码用于视觉定位、空间推理和指向的空间先验,但这些能力很少被直接激发用于机器人控制。现有导航系统反而依赖任务或形态特定组件,割裂感知、推理与行动,泛化能力有限。 本文提出 LightNav-0,一种紧凑的通用具身导航模型,通过激发预训练 VLM 的空间智能并将其与导航对齐,无需任务特定预测头。LightNav-0 通过统一 token 接口表征多样导航任务:双通道指向 表达任务、场景和形态无关的空间意图,残差矢量量化动作分词器 将该意图映射为精确的形态特定轨迹。结合 时间感知视觉历史压缩、ER 中训练、监督微调与强化学习,该方案支持指令跟随、开放词汇目标导航和视觉追踪于单一模型。 训练语料涵盖 2000+ 场景 和 4000+ 小时 具身导航数据。用于初始化 LightNav-0 的具身推理检查点 LightNav-ER 在 8 个具身推理基准上取得最高完整集平均分,而 LightNav-0 在全部 10 个公开导航仿真设置中达到最先进的单目成功率。真实世界评估进一步展示了跨机器人形态、多样场景及静态/动态目标的零样本泛化能力。 这些结果确立了紧凑 VLM 作为通用具身导航统一且可迁移骨干的可行性。
论文精读
TL;DR LightNav-0 用统一 token 接口激发预训练 VLM 的空间推理,通过双通道 pointing 与残差 VQ 动作分词,在单模型内实现指令跟随、开放词汇目标导航与视觉跟踪,10 项仿真基准全部 SOTA,零样本跨机器人泛化。
问题
具身导航领域正聚焦于如何利用大规模预训练视觉语言模型(VLM)的空间推理能力,打造跨任务、跨场景、跨机器人形态的通用导航模型,减少每个新机器人或新任务需要重新采集数据和设计专用模块的成本。
现有方法局限: 传统导航方案通常拆分为感知(检测/建图)、推理(规划/匹配)、动作(控制器)等模块,各模块独立且依赖任务定制:
- 指令跟随、目标导航、视觉跟踪等任务使用不同架构或预测头,难以共享知识;
- 对环境的显式几何建图或目标检测在未见场景中鲁棒性差,且无法自然利用自然语言空间指代;
- VLM中蕴含的指向能力(grounding/pointing)虽被认为可用于空间意图表达,却很少被直接解码成机器人控制信号。
为什么难/重要: 挑战在于目标与动作空间的异构性:自然语言指令或目标图像是高维语义信号,机器人运动轨迹是连续的、形态相关的低维控制序列;同时模型需处理长程时序视觉信息,计算预算受限(尤其移动机器人)。业界对统一具身智能骨干的需求强烈,因为它能降低碎片化工程、提高数据复用和跨形态迁移。LightNav-0 提出的双通道指向 token + 残差 VQ 动作 tokenizer 试图弥合语义与动作的鸿沟,是当前具身大模型方向的关键探索。
行业类比: 可比作“大模型”将多种 NLP 任务统一到单一生成接口,LightNav-0 尝试将异构导航任务统一到通用 token 接口,有望产生类似规模化红利。
核心洞察
- LightNav-0 的核心在于用 dual-channel pointing 与 residual vector-quantized action tokenizer 将导航任务统一为从 VLM 预训练空间先验直接产生的 token 序列,从而摆脱了任务特定的预测头。与常见导航系统中感知、推理、动作模块分离且各自针对特定任务或机器人设计不同,该方法让 VLM 直接输出空间意图的隐式指向 token,再经过量化映射为可执行的轨迹,实现了真正的端到端统一。这种设计既保留了 VLM 的通用空间智能,又避免引入额外可学习参数破坏预训练表示,为跨任务和跨机器人泛化提供了结构基础。
- 在训练流程上,LightNav-0 引入了 ER mid-training(具身推理中间训练)作为一个独立阶段,先用大规模多模态具身推理数据激活 VLM 中已有的空间推理、视觉 grounding 和 pointing 能力,再初始化导航模型进行 SFT 和 RL。与直接对 VLM 做导航任务微调的常见做法相比,该中间阶段能有效减少灾难性遗忘,并将抽象的空间推理显式连接到具身动作决策,最终使 LightNav-ER 在 8 个具身推理基准上取得最高完整集平均分,为后续导航提供了更强的认知先验。
- LightNav-0 证明了紧凑型 VLM 可以作为通用具身导航的统一骨干,在单目视觉输入和有限参数规模下,于 10 个公开导航仿真基准中取得 SOTA 成功率,并在真实世界跨机器人、跨场景及静态/动态目标追踪中实现 zero-shot 泛化。这与当前依赖大模型或专用模块的趋势形成对比,表明只要在 token 接口、训练数据和训练阶段上进行针对性设计,轻量模型也能达到甚至超越大型模型的导航性能,同时具备更低的部署成本和更实时的推理效率,对实际工程落地有直接意义。
方法
输入与总体流程
LightNav-0 接收异构导航目标(指令 / 物体类别 / 跟踪目标)与连续视觉观测,统一为多模态 token 序列。模型不设任务专用预测头,直接从 token 分布生成动作,实现单模型覆盖指令跟随、开放词表物体导航与视觉跟踪。
关键模块
- 双通道指向(Dual-Channel Pointing):作为潜在空间推理层,输出两条相互补充的指向通道(如路径点与朝向),表达任务、场景、机器人形态无关的空间意图。该设计将 VLM 预训练中已有的视觉定位与空间推理能力显式牵引到导航任务,避免重新学习空间表征。
- 残差向量量化动作 tokenizer(Residual Vector-Quantized Action Tokenizer):将双通道指向生成的抽象意图映射为具体机器人动作轨迹。采用残差量化逐步细化动作 token,可适应不同底盘运动学与执行器约束,实现 embodiment 特定的精确控制。
- 时间感知视觉历史压缩(Temporally Aware Visual History Compression):对历史观测进行有损但时间敏感的压缩,降低序列长度与计算成本,同时保留时序信息以支持长程导航决策。
训练与输出
训练分三阶段:Embodied-Reasoning (ER) mid-training 在多样化具身推理数据上激活 VLM 空间智能;随后 监督微调(SFT) 对齐导航格式;最后 在线强化学习(RL) 使用组相对优势优化导航成功率与效率。输出为逐 token 生成的动作序列,直接驱动机器人。
与同类方法差异
现有导航系统通常拆分感知、推理、行动并针对特定任务/机器人定制组件,LightNav-0 仅用一个紧凑 VLM 通过统一 token 接口完成全链路,显著减少组件碎片化并提升跨任务、跨 embodiment 的泛化能力。
实验
实验设计
LightNav-0 在 10 个公共导航模拟环境 上评估,涵盖 VLN、ObjectNav、Embodied Visual Tracking 等任务;同时以 LightNav-ER 模型在 8 个 embodied-reasoning 基准 上测试推理能力。训练数据覆盖 2K+ 场景、4K+ 小时具身导航轨迹,采用 ER mid-training → SFT → RL 三阶段流程,并引入 INSIGHT-Bench 进行诊断性评估。
关键发现
- LightNav-0 在全部 10 个导航模拟基准 上取得 最先进的单目成功率。
- LightNav-ER 在 8 个 embodied-reasoning 基准 上取得 最高 complete-set average。
- 真实世界实验展示 零样本跨形态泛化(不同机器人、静态/动态目标、多样场景)。
与基线对比解读
传统导航系统依赖任务或形态特定组件,感知、推理与动作割裂。LightNav-0 通过 dual-channel pointing 和 residual VQ action tokenizer 统一空间意图与动作输出,消除了专用预测头,使紧凑 VLM 的空间先验直接转化为控制信号。对比基线,其优势并非堆砌数据或模型规模,而是 将预训练空间智能高效对齐到导航,从而在多个基准上同时超越各任务专用方法,验证了通用骨干的可行性。
行业影响
落地场景
LightNav-0 以 compact VLM 统一支持指令跟随、开放词汇目标导航和视觉跟踪,可直接用于:
- 仓储物流机器人:在动态仓库中执行“去第三排货架取红色周转箱”等开放词汇指令,无需预设地图或限定物体类别。
- 服务机器人:商场 / 医院 / 办公楼内跟随特定人员或引导访客到指定房间,适配不同机器人底盘。
- AR 导航辅助:为头显设备提供基于自然语言的空间指引,实时跟踪移动目标并规划路径。
商业价值
核心价值在于降低多任务、多机器人平台的开发与维护成本:
- 无需为每个导航任务单独训练感知、规划、控制模块,减少工程团队投入。
- 模型一次训练可跨仿真与真实环境泛化,显著缩短从研发到部署的周期。
- 开放词汇能力让机器人适应长尾目标,避免频繁重训练,提升服务可靠性与用户体验。
与现有工作流集成
- 模型层:LightNav-0 输出统一的
pointing token和residual VQ action token,可直接替换现有导航栈中的 Perception + Policy 部分,保留底层电机控制与安全模块。 - 训练管线:提供 mid-training、SFT、RL 三阶段配方,企业可基于 GitHub / Hugging Face 权重在自有数据上继续微调,适应不同机器人形态。
- 推理部署:模型为 compact VLM,单目输入,算力要求低,可部署在边缘设备(如 Jetson)上。
具体落地 case
电商仓储分拣机器人:在大型电商履约中心,机器人接收“把刚卸货的蓝色包裹放到 B 区 12 号格口”的自然语言指令,通过开放词汇目标导航找到包裹并执行跟踪搬运,不同厂商的 AGV 均可通过统一 token 接口快速接入,无需修改底层运动控制。
智能楼宇引导机器人:在办公楼 / 医院提供访客引导与跟随服务,支持“跟着穿红色外套的人”等动态目标指令,同一模型可部署在轮式或四足机器人上,通过 RL 后训练适应不同动力学。
局限
- **对预训练 VLM 空间先验的依赖**:模型核心依赖预训练 VLM 的空间智能,但底模视觉编码器和语言模型可能缺乏对 metric 深度、运动规划等底层空间表示的精细建模。尽管 ER mid-training 和双通道 pointing 显式引导,但 dual-channel pointing 作为潜在空间推理的可解释性不足,训练数据覆盖不足时可能出现指向与动作不匹配。与显式构建 3D 地图或占用网格的方法相比,LightNav-0 在需要长期记忆或精确几何导航的任务中可能存在劣势,需进一步验证在复杂建筑、极端光照等分布外场景的鲁棒性。
- **训练数据域外泛化与动作量化误差**:训练语料虽达到 2K+ 场景和 4K+ 小时,但主要来自仿真,真实世界 zero-shot 仅在少量条件下展示,跨 embodiment 泛化声明缺乏大规模真实基准支撑。此外,RVQ 动作分词器将连续控制信号离散化,可能引入量化误差,尤其对高动态、需要精细速度控制的任务(如动态目标跟踪)造成性能瓶颈。论文未充分分析量化误差与导航精度之间的关系,也未与连续动作空间模型在相同基准上做系统对比。
- **评估指标与模态限制**:评估以成功率为主,未详细报告碰撞率、SPL 等效率指标,可能掩盖“低效成功”现象(如绕远路或频繁碰撞)。另外,模型仅使用单目视觉输入,与利用 RGB-D 或激光雷达的导航系统相比天然缺失深度,虽然该方法在单目设定下达到 SOTA,但实际机器人往往配备深度传感器,论文未提供多模态融合的扩展路径,限制了在工业级系统中的直接应用。