DICS: 探索数据内在一致性用于视觉指令选择
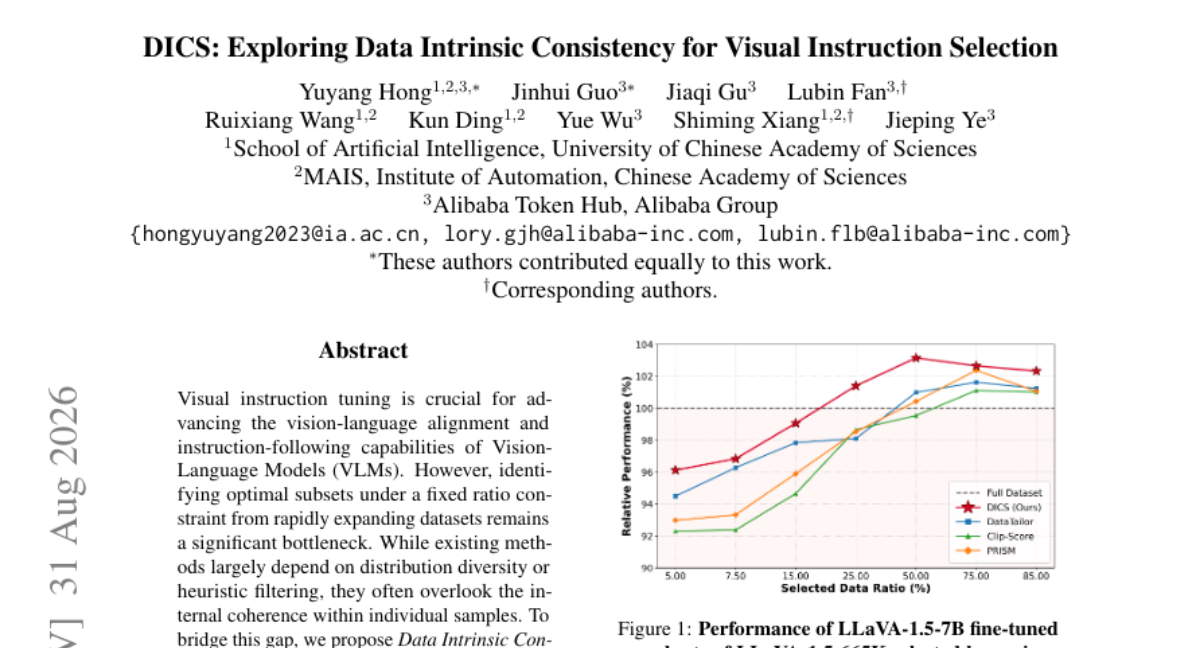
视觉指令微调对于提升视觉语言模型(VLM)的视觉-语言对齐和指令跟随能力至关重要。然而,在快速扩展的数据集上,于固定比例约束下识别最优子集仍是重大瓶颈。现有方法多依赖分布多样性或启发式过滤,却常忽视单个样本内部的连贯性。为填补这一空白,我们提出数据内在一致性(DIC),一种用于量化样本级组件间一致性的自评分指标。DIC 包含两个模块:视觉信息一致性(VIC),评估视觉内容与指令之间的对齐;响应信息一致性(RIC),评估响应相对指令的连贯性。基于 DIC,我们提出数据内在一致性选择(DICS),一种自适应数据选择方法,在不同数据预算下优化高样本内一致性与全局分布多样性之间的权衡。大量实验表明,DICS 在不同数据集规模和模型架构上均持续优于最先进方法,仅使用 LLaVA-1.5-665K 数据的 25% 即超越全量微调。我们进一步整理了 DICS-6M,一个包含 600 万样本的多模态指令语料库,实现了迄今最大规模的视觉指令选择研究;值得注意的是,DICS 仅使用不到官方 InternVL3-8B-Instruct 所报告训练数据的 25%,即达到其 94.52% 的性能。代码见 https://github.com/cqu-student/DICS。
论文精读
TL;DR DICS 通过衡量视觉指令样本的内部一致性(视觉-指令对齐与响应-指令连贯)自动筛选高质量子集,仅用 25% 数据即超越 LLaVA-1.5 全量微调,大幅降低 VLM 指令调优成本。
问题
问题背景
视觉指令微调(visual instruction tuning)是提升 VLM 对齐能力的关键,但如何从海量多模态指令数据中筛选高质量子集,仍是数据工程的核心瓶颈。
现有方法局限
当前主流视觉指令选择方法主要基于两类思路:
- 分布多样性驱动:如利用 CLIP 特征聚类或贪心去重,保证子集覆盖全局分布,但忽略了单条样本内部跨模态语义是否一致;
- 启发式过滤:基于图像质量、指令长度或回答长度等浅层统计指标,无法捕捉指令与视觉内容之间的细粒度对齐关系。 这些方法容易保留“看起来多样但内部矛盾”的样本,如图像内容与指令描述不匹配、响应偏离指令意图,导致模型学习到噪声监督信号。
为什么这个问题难/重要
难点在于需要高效、低成本地评估样本级内部一致性:
- 视觉-指令一致性(VIC)要求判断视觉内容是否真正支撑指令描述;
- 响应-指令一致性(RIC)要求判断响应是否真正回答指令,而非简单重复或偏移。 在大规模数据集(数十万至数百万样本)上,逐样本人工标注不可行,而模型打分又面临偏差与泛化问题。业界高度关注固定算力预算下的数据效率,优良的数据选择可显著降低训练成本并提升模型表现。
行业类比
类似推荐系统中的精排阶段:从海量候选物料中筛选出与用户意图高度匹配且自身信息完整的 item,而非仅保证候选池的多样性。
核心洞察
- Data Intrinsic Consistency (DIC) 是一种样本级自评分指标,直接量化视觉指令数据中图像-指令-响应三者的内部一致性,而不依赖数据集整体分布或人工过滤规则。现有方法多从全局多样性或启发式噪声剔除入手,容易忽略单个样本内视觉内容与文本指令、指令与响应之间的错位。DIC 将评估粒度下沉到样本内部,为筛选提供更细粒度的信号,尤其适用于快速膨胀的多模态指令数据中自动识别低质量或矛盾样本。
- DICS 在固定数据比例约束下动态平衡样本一致性得分与全局分布多样性,突破了传统固定权重或单独优化某一方面的局限。它能够根据不同的选择预算自适应调整权衡策略,因此在 25% 的 LLaVA-1.5-665K 数据上微调即可超过全量数据效果,并在 DICS-6M 语料上以不到 25% 的 InternVL3-8B 训练数据达到 94.52% 的官方性能。这一结果表明,针对不同规模数据与模型架构,内部一致性优先的筛选策略具有显著的可扩展性和鲁棒性。
方法
输入与整体流程
DICS 以多模态指令数据集为输入,每个样本包含图像、指令文本与响应文本。筛选目标是给定数据预算比例下,选出最优训练子集。
关键模块:DIC 自评分指标
DIC 由两个子模块构成,分别衡量样本内部不同组件的一致性。
- Visual Information Consistency (VIC):通过对比视觉内容与指令描述,量化图像区域与指令语义的对齐程度。实现中采用 content words 与 functional words 的分层 token 加权策略,让语义关键词获得更高权重,减少填充词对一致性评分的干扰。
- Response Information Consistency (RIC):评估响应文本与指令之间的连贯性,例如回答是否直接回应指令意图、是否存在无关内容。同样利用 token 加权,聚焦指令中的关键意图表达。
两个子分数融合得到 DIC 分数,作为样本级自评分,无需额外人工标注即可反映样本内部质量。
选择策略 DICS
在获得 DIC 分数后,DICS 不是简单取 top-k,而是在不同数据预算下自适应平衡 高样本内一致性 与 全局分布多样性。具体而言,根据预算比例动态调整筛选阈值与多样性约束,避免过度集中到单一类别或风格。
输出
输出筛选后的视觉指令子集,可用于 VLM 微调。论文在 LLaVA-1.5-665K 上仅用 25% 数据超越全量微调,并构建 DICS-6M 语料,在 InternVL3-8B 上以不到 25% 数据达到官方性能的 94.52%。
与同类方法的差异点:不同于依赖分布多样性或启发式过滤的方法,DICS 首次将样本级内部一致性作为核心度量,实现自评分的细粒度数据质量筛选。
实验
实验设计
作者在 LLaVA-1.5-665K 数据集上验证 DICS 的数据选择效果,并与基于分布多样性或启发式过滤的现有方法对比。同时构建 DICS-6M(6M 多模态指令样本)进行更大规模实验,覆盖不同模型架构。
关键发现
- 使用 LLaVA-1.5-665K 仅 25% 的数据,DICS 训练模型即超越全量数据微调,证明其数据选择的有效性。
- 在 InternVL3-8B-Instruct 上,DICS-6M 用不到 25% 的训练数据达到官方全量性能的 94.52%,展示出强泛化能力。
对比解读
与侧重全局多样性的方法不同,DICS 引入样本内部一致性(VIC 与 RIC)作为自评分指标,在数据预算受限时能更精准地识别高质量样本。实验表明,这种“内在一致性”视角优于仅依赖分布统计的启发式过滤,为视觉指令数据选择提供了新思路。
行业影响
落地场景:适合任何需要视觉指令微调(Visual Instruction Tuning)的多模态模型团队,特别是从大规模图文数据中构建指令数据集。例如电商平台训练商品问答助手、内容平台的内容审核与推荐、教育领域的图像解题助手、医疗影像报告生成等。DICS 可作为数据预筛选器,在训练前自动标注样本一致性分数,帮助团队用更少数据达到更好效果。
商业价值:降本方面,DICS 在 LLaVA-1.5 上仅用 25% 数据超越全量微调,InternVL3-8B 用不到 25% 数据达到官方 94.52% 性能,直接减少 GPU 训练小时数和存储成本。体验提升方面,去除不一致样本可降低模型幻觉,提升指令遵循可靠性,从而减少线上 badcase。增收方面,更轻量的模型训练流程可加速迭代,更快推出多模态功能。
与现有工作流接口:DICS 计算基于预训练视觉编码器和语言模型,无需额外训练,可作为插件接入现有数据管理 pipeline(如 HuggingFace Datasets、自定义 DataLoader)。在数据入库或训练前,对每个样本计算 VIC 和 RIC 分数,然后按预算比例选择。可与现有 diversity 采样方法(如 CLIP 去重)叠加,形成“一致性 + 多样性”双过滤。
具体用例:
- 电商平台构建商品视觉问答模型时,用 DICS 从数十亿商品图文描述中筛选指令样本,减少训练数据量 75% 以上,同时提升属性识别和尺寸判断准确率。
- 内容平台训练图像/视频理解模型(如自动生成 alt text、违规检测),用 DICS 滤除图文不一致样本,提升模型对图像语义的忠实度。
局限
- - **DIC** 依赖预先训练的视觉-语言模型或 CLIP 等编码器来评估样本一致性,这会让打分过程引入外部模型的领域偏差与计算开销。论文并未详细对比不同打分模型对 DICS 选择结果的影响;若基础模型对某些视觉概念或指令风格不敏感,**VIC** 与 **RIC** 分数可能失真,导致高一致性数据集中在模型偏好的分布上,从而降低子集对真实多模态场景的覆盖度。
- - **DICS** 的核心是样本内一致性(图像-指令-回答),但对样本间全局多样性的建模仍依赖后续的分布多样性约束,二者之间的 trade-off 通过自适应权重调节。这种设计可能在数据预算极低时过度倾向高一致性样本,忽视长尾、罕见但重要的安全/常识样本;文中并未在极端低预算(如 5% 或 1%)下报告选择的性能退化,因此该方法的鲁棒性边界尚不明确。
- - 论文虽在 LLaVA-1.5-665K 上验证了超越全量微调的效果,并策展 DICS-6M,但实验主要覆盖通用多模态指令跟随与 VQA 基准,对细粒度视觉理解、文档/OCR、医学影像、多语言等垂直场景缺乏专门评估。此外,**DICS-6M** 是从现有数据集中筛选得到,并非新采集数据,其数据源本身可能已由既有过滤器去噪,因此 DICS 在更原始、噪声更高的指令数据上的表现仍需进一步验证。