EvoGenUI-Bench: 评估 LLM 作为多轮生成式 UI 助手
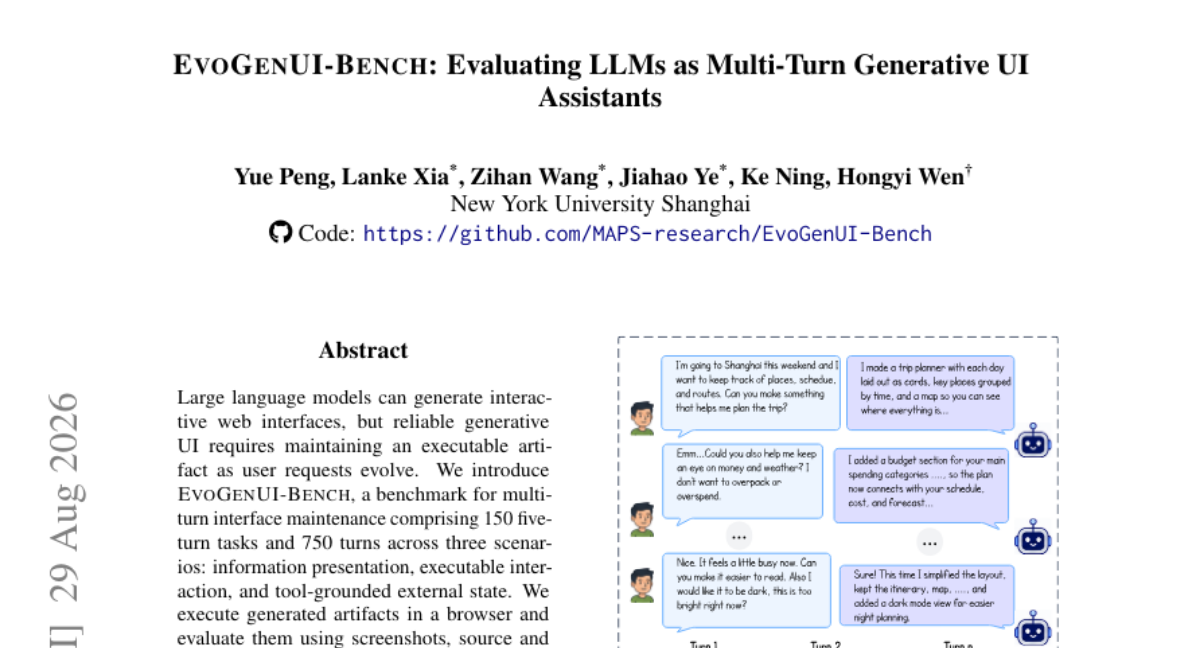
大语言模型能生成交互式网页界面,但可靠生成式 UI 要求随用户需求变化维护可执行工件。我们引入 EvoGenUI-Bench,一个多轮界面维护基准,包含 150 个五轮任务共 750 轮,覆盖信息呈现、可执行交互、工具锚定外部状态三类场景。我们在浏览器中执行生成工件,利用截图、源代码和 DOM 证据、actor 轨迹、运行时日志进行评估。除轮次级和会话级成功率外,我们用 相邻轮次保留率 (Adjacent Pass Retention, APR) 衡量跨轮保留能力。 在八种模型上,最强模型 Turn Pass 仅达 74.9%,完整完成五轮会话的仅 37.3%;工具锚定任务上 APR 更降至 52.4%。诊断分析显示:呈现类失败集中在信息架构,交互类失败源于派生状态传播和控件绑定,工具锚定类失败还涉及外部状态锚定和需求分解。这些结果将生成式 UI 评估从判断孤立输出,转向测试界面行为、派生状态、外部状态和助手声明在工件演化过程中是否保持同步。
论文精读
TL;DR EvoGenUI-Bench 用 150 个五轮任务评估 LLM 维护可执行 UI 的能力,发现最强模型也仅完成 37.3% 五轮 episode,揭示生成 UI 的核心挑战在于跨轮状态同步而非单轮生成。
问题
问题背景
生成式 AI 在 交互式 Web 界面生成 领域取得进展,模型不仅能输出静态 HTML/CSS,还能产生包含事件处理与状态管理的可执行前端代码。
现有方法局限
当前生成 UI 的评估范式主要针对单轮输出:采用静态截图相似度、代码质量启发式或一次性浏览器执行结果。这些方法忽略了多轮交互中用户需求不断演化时,模型需要持续维护一个可执行 artifact 的关键能力。具体局限包括:
- 无法捕获跨轮次的状态一致性(如派生状态未随输入更新)
- 不评估外部工具状态与界面显示之间的绑定关系
- 缺乏运行时日志、DOM 证据和 actor trace 等多模态证据,导致评分偏向表面相似而非行为正确
为什么这个问题难/重要
多轮生成 UI 的可靠性要求界面行为、派生状态、外部状态和助手声明在 artifact 演化过程中保持同步。一旦用户修改需求,模型可能只更新部分组件,破坏原有可执行性;而传统单轮指标会高估这种场景下的成功率。业界对 agentic coding 助手(如 GitHub Copilot Workspace)在真实项目中的迭代开发能力愈发关注,需要能区分“生成得像”和“持续可用”的评测基准。
行业类比
这类似于评价一个自动驾驶系统:只看单帧感知结果是不够的,必须测试连续驾驶过程中车辆对动态环境的长期稳定响应。
核心洞察
- 多轮生成 UI 的可靠性本质是跨轮状态同步,而非单轮输出质量;EvoGenUI-Bench 通过 Adjacent Pass Retention (APR) 将 turn-level 成功率与 episode 级可靠性解耦,揭示单轮指标严重高估实际可用性。现有 UI 生成基准(如 WebArena、Design2Code)多聚焦静态或单步任务,无法暴露用户需求演变时界面行为、派生状态和外部状态异步的问题。该基准执行五个连续 turns,发现最强模型 Turn Pass 74.9% 但仅完成 37.3% 的五轮 episode,证明维护可执行 artifact 的持续一致性是生成 UI 助手的核心挑战。
- 工具接地(tool-grounded external state)场景与证据驱动的失败分类揭示 LLM 在外部状态接地、需求分解、派生状态传播和 affordance 绑定上的独立短板,为工程优化提供直接信号。与仅关注 DOM 操作或截图相似度的传统评测不同,EvoGenUI-Bench 在浏览器中执行 artifact,组合 screenshots、source/DOM、actor traces 和 runtime logs 进行归因;即使模型上一轮通过,APR 在工具接地任务上骤降至 52.4%,失败分布可映射到状态管理、事件绑定或工具调用时机等架构决策,使基准结果成为可操作的调试信息而非单纯分数。
方法
输入
EvoGenUI-Bench 包含 150 个五轮任务,共 750 个 turn,覆盖三类场景:信息展示、可执行交互、工具接地的外部状态。每个任务从初始 UI 生成请求开始,后续四轮为增量修改请求,要求 LLM 维护可执行的网页 artifact。
关键模块
任务设计与证据收集
LLM 在每个 turn 生成或修改 UI artifact,并在真实浏览器中执行。系统自动收集五类证据:截图、源代码、DOM 证据、actor traces、运行时日志,用于后续判定。评估维度与 rubric
依据 presentation、execution、alignment 三类 rubrics 对每个 turn 做通过 / 失败判定。presentation 评估视觉结构与信息架构,execution 评估交互行为与派生状态更新,alignment 评估外部状态接地与助手声明一致性。可靠性指标
- Turn Pass:单轮是否满足要求。
- Episode Pass:五轮全部通过才算成功。
- Adjacent Pass Retention (APR):新增的跨轮保持指标,衡量在上一轮通过的前提下,当前轮依然通过的概率,用于捕捉状态丢失或回归。
诊断分析
对失败 turn 做分类,定位到信息架构、派生状态传播、affordance 绑定、外部状态接地或需求分解等具体原因。
输出
模型得到 turn-level、episode-level 和 APR 三个层次的性能分数,以及按场景和轮次细分的失败类型分布。
与同类方法的差异点
不同于以往只评估单轮生成 UI 静态截图相似度的方法,EvoGenUI-Bench 通过浏览器真实执行 artifact,并用 APR 显式量化多轮维护中的跨轮一致性,将生成式 UI 评估从孤立输出判定转向行为、派生状态、外部状态与助手声明同步演进的测试。
实验
实验设计
EvoGenUI-Bench 包含 150 个五回合任务(共 750 个回合),覆盖三种场景:信息呈现、可执行交互、工具接地外部状态。生成产物在浏览器中实际执行,评估采用截图、源码与 DOM 证据、actor traces 和 runtime logs。除回合级 / 回合组级成功率外,引入 Adjacent Pass Retention (APR) 衡量跨回合保持能力。
关键发现
在八个模型中,最强模型仅达到 74.9% 的 Turn Pass,只有 37.3% 的五回合 episode 完全通过;在工具接地任务上 APR 进一步下降至 52.4%。诊断显示:信息呈现类失败集中于信息架构;可执行交互类失败集中于派生状态传播与 affordance 绑定;工具接地类还涉及外部状态接地与需求分解。
基线对比解读
这些结果表明,当前 LLMs 生成 UI 的可靠性在回合间严重衰减,单回合评判掩盖了多回合维护的困难。工具接地任务即使在前一回合通过的情况下,后续回合保留率依然很低,说明模型难以维持外部状态同步。这挑战了仅评估孤立输出的传统范式,提示需要持续追踪工件行为、派生状态与外部状态的一致性。
行业影响
落地场景
EvoGenUI-Bench 评测的多轮生成 UI 能力可落地于低代码/无代码平台、AI 设计工具与内部工具生成器。具体用例:
- 电商场景:商家通过多轮对话搭建活动落地页,持续修改商品卡片、倒计时组件与库存筛选,助手需保持页面可执行且状态一致。
- 企业服务场景:SaaS 产品让客户用自然语言定制 dashboard,连接外部 CRM/数据库字段,自动维护图表联动与筛选器绑定。
商业价值
核心价值在降本与体验提升:减少前端人力投入,让非技术人员自助产出可运行界面,加速迭代周期;同时提升平台生态活跃与用户留存,因为可定制化能力直接带来粘性。对 AI 生成 UI 产品而言,该 benchmark 提供的证据化评估(screenshots、DOM、actor traces)可以转化为自动化质检环节,降低线上故障与返工成本。
跟现有产品/工作流的接口
集成路径清晰:将生成 UI 助手嵌入低代码平台或设计系统,输出 artifact 通过浏览器自动化(如 Playwright)执行,收集 DOM/screenshot/runtime logs 作为回归测试证据。可与现有 CI/CD 流水线对接,把 Turn Pass / APR 指标作为发布门禁;再结合人工 review 处理信息架构等长尾问题。这使生成 UI 从一次性 demo 走向可维护的工程组件。
局限
- 论文构建的 **EvoGenUI-Bench** 包含 150 个五轮任务,覆盖三个场景,但任务均为人工设计,场景相对封闭。例如,工具接地任务中的外部状态模拟可能简化真实世界的异步变化、故障和并发更新,导致评估不能完全反映生产环境中的界面维护难度。此外,五轮交互的固定长度可能不足以捕捉长期对话中的状态漂移和用户意图的渐进复杂化,限制了基准对真实用户会话长度的代表性。
- 评估框架依赖浏览器执行与 LLM 评估器生成证据,但截图对比、DOM 检查和源码分析存在主观性和噪声。例如,视觉布局的细微差异可能被误判为失败,而功能等价但实现不同的代码可能被低估。论文中的人类验证规模有限,难以充分标定自动评估指标的可靠性和阈值,APR 指标仅衡量相邻轮次保留,未考虑跨多轮的累积状态一致性。
- 与已有 UI 生成或交互基准如 **WebArena**、**Mind2Web** 相比,该基准强调多轮维护,但在交互类型和真实用户反馈方面仍显不足。没有接入真实用户对生成界面的主观质量评估,也没有覆盖移动端、桌面端以外的复杂环境(如多设备协同、语音交互)。此外,测评的 8 个模型可能未全面平衡开源与闭源、指令微调与基础模型,结论的普适性有待更大规模验证。