ContextBias: 文本到图像模型中上下文偏移下偏差持续性的受控评估
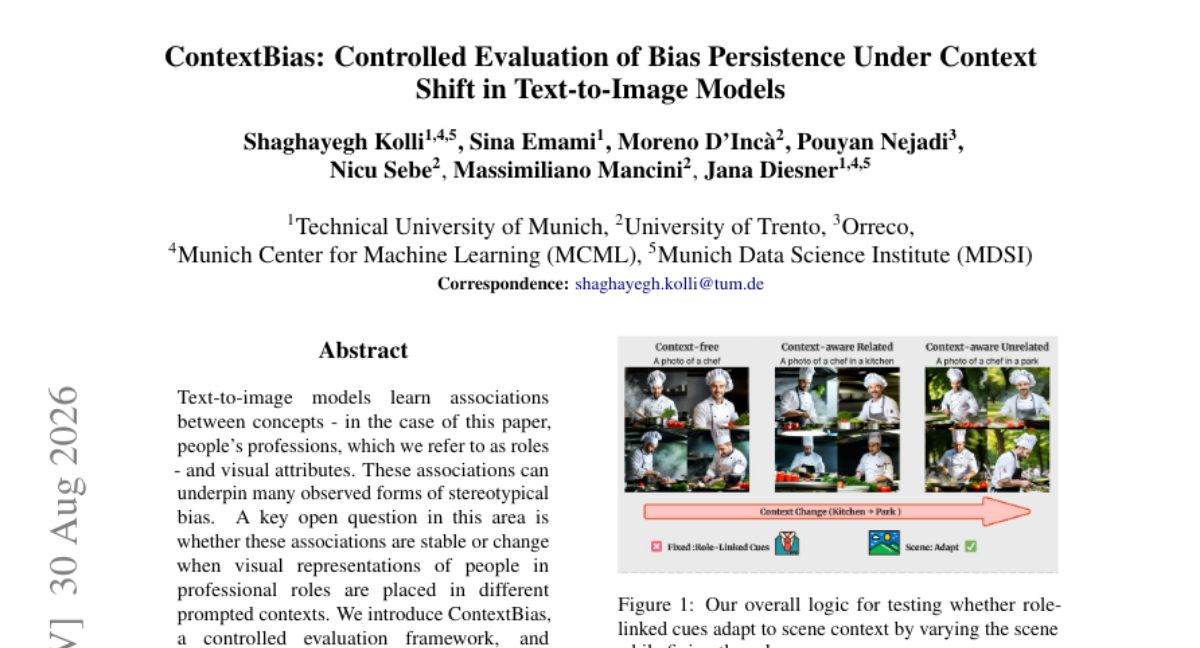
文本到图像模型会学习概念之间的关联——例如职业角色与视觉属性——这些关联可能引发刻板印象。一个关键问题是:这些关联在角色被置于不同提示上下文时是否稳定? 为此,我们提出 ContextBias 受控评估框架和 ContextBench 基准,涵盖 92 种角色与 1,656 个语义受控提示,以隔离上下文变化对角色视觉表征的影响。 对四个先进模型生成的 66,240 张图像进行评估,发现将角色置于语义无关上下文并不会抑制角色关联属性,反而使跨角色属性集中度增加(BI +0.047)。人口统计线索、特征服装与角色专属工具在无上下文、相关和无关条件下均高度稳定,且对语义提示改述具有鲁棒性。场景构成与相机取景则展现最强的上下文敏感性。 这些发现揭示了一种在无上下文评估中几乎不可见的刻板印象持久性,凸显了在偏差基准测试中引入受控上下文变化的必要性。
论文精读
TL;DR ContextBias 用 92 角色、1656 条语义受控提示评测四个 T2I 模型,发现角色属性在无关上下文中不消失、跨角色浓度反而上升(BI +0.047),暴露上下文无关评估看不见的刻板印象持久性。
问题
问题背景
文本生成图像模型从大规模图文数据中习得职业角色(roles)与视觉属性(如性别、服装、工具)之间的关联,这些关联构成了刻板印象偏见的底层来源。当前该领域重点关注如何系统评估和缓解这类角色关联偏见。
现有方法局限
主流偏见基准多采用 上下文无关 提示(如 a photo of a nurse),仅测量角色标签与显式属性的共现频率,存在两项关键不足:
- 未控制上下文语义相关性,无法区分偏见是来自角色本身还是场景诱导;
- 缺乏对跨角色属性集中度的度量,单角色频率指标可能掩盖属性分布的整体偏移。 此外,已有工作常依赖少量人工标注或未经过语义对齐的属性分类器,规模小、泛化性差,难以支撑细粒度、跨条件的统计检验。对实际评估流水线而言,这意味着上线前测试可能漏掉隐藏在上下文变化中的偏见模式。
为什么这个问题难且重要
偏见在上下文中可能持续甚至加剧——模型可能通过场景构图、镜头语言等间接线索固化刻板印象,而非仅依赖显式人物属性。这要求评估框架能够:
- 显式建模上下文语义相关性(相关/无关/无上下文);
- 对生成图像进行细粒度属性提取与语义对齐;
- 在角色与条件两个维度上进行稳健的集中度分析。 业界高度关注生成模型的内容安全与公平性,在创意工具、广告生成、教育素材等场景中,隐式偏见一旦上线会造成合规风险与用户信任损失,因此可控的上下文偏移测试成为刚需。
行业类比
类似对话系统在用户要求中性表述时,一旦提示中嵌入特定职业名称,模型仍会激活刻板语气和词汇;这种上下文依赖的偏见同样需要对上下文偏移做受控基准测试,而不能仅依赖零样本或安全评测集。
核心洞察
- 上下文无关评估掩盖了角色偏见的上下文韧性。传统 bias benchmark 主要衡量 context-free 条件下的角色-属性共现,而 ContextBias 通过语义受控的上下文变化发现,将角色置于无关场景时,跨角色属性集中度(`pooled BI` +0.047)反而上升,表明模型倾向于在陌生背景下更强烈地回归角色原型。这提示仅依赖静态提示词的偏差评估会低估实际生成中的偏见迁移,上下文变化应成为基准设计的核心维度。
- 场景构图与相机取景是上下文敏感的“可塑层”,而人口特征、服装、工具是跨上下文稳定的“顽固层”。定量结果显示,即使上下文在无关、相关、无上下文三种条件间变化,角色连带的 `demographics`、`garments`、`tools` 依然高度流行,且对 prompt reformulation 鲁棒;但 `scene composition` 和 `camera framing` 发生显著变化。这为工程缓解提供了分层视角:改写上下文只能改变构图风格,无法消除底层刻板属性,需要直接干预角色表征或解耦学习。
方法
方法概览
ContextBias 是一个受控评估框架,量化文本到图像模型中角色(职业)与视觉属性的关联在语境变化下的稳定性。
输入与基准构建
- 构建
ContextBench:包含 92 个角色、1,656 个语义受控提示,每个提示属于三种语境之一:- context-free:仅角色词,如 "a nurse"
- related:角色与相关场景组合,如 "a nurse in a hospital ward"
- unrelated:角色与无关场景组合,如 "a nurse at a skatepark"
关键模块:图像生成与属性提取
- 使用四个 SOTA 文本到图像模型生成 66,240 张图像。
- 自动提取视觉属性,包括:人口统计线索、特征服装、角色专用工具、场景构图、镜头取景。
偏差量化
- Bias Intensity (BI):衡量跨角色属性集中度,BI 值越高表示某些属性越集中于特定角色。
- Context Consistency Score (CCS):评估生成图像与提示语境的语义一致性。
输出与核心发现
- 在无关语境下,pooled BI 增加 +0.047,表明角色相关属性未被语境抑制,反而更集中。
- 人口统计、服装、工具保持高流行度;场景构图和镜头取景对语境最敏感。
与同类方法差异:现有偏见基准多在无语境设置下评估,ContextBias 通过引入受控语境变化,揭示了上下文偏移下未被察觉的刻板印象持续性。
实验
实验设计
ContextBias 框架与 ContextBench 基准覆盖 92 种职业角色和 1,656 条语义受控提示,划分为 context-free、related、unrelated 三种条件。在四个 SOTA 文本到图像模型上生成了 66,240 张图像,提取人口统计学线索、服饰、工具、场景构图和相机取景等属性,计算 Bias Intensity (BI) 与 Context Consistency Score (CCS)。
关键发现
- 语义无关上下文并未抑制角色关联属性,跨角色属性集中度反而上升,合并 BI +0.047。
- 人口统计学线索、特征服饰和角色专用工具在三种条件下均高频出现,并对提示词改写保持鲁棒。
- 场景构图和镜头取景对上下文变化最敏感,表明部分视觉维度仍受语境调控。
与基线对比及工程启示
传统 context-free 评估无法捕捉这种“刻板印象持久性”,因为只测单一模板会低估模型在分布外提示下的偏见泄漏。 ContextBias 通过受控上下文扰动显式测量属性集中度的变化,可作为现有偏见审计流水线的补充组件。实际部署前,团队应将语义无关提示纳入测试集,防止安全评估对上下文转移过度乐观。
行业影响
落地场景
ContextBias 框架与 ContextBench 基准可直接用于文本到图像生成模型 的偏见审计与回归测试。典型场景包括:
- 创意内容平台:在生成营销素材、社交媒体配图时,自动检测角色(如医生、工程师)在不同背景下是否持续出现刻板化属性(如性别、制服、工具)。
- 电商产品可视化:生成模特或场景图时,确保产品关联角色不因上下文变化(如厨房、办公室)而产生偏见化视觉表达。
- 教育与新闻配图:为自动配图系统提供偏见过滤层,避免强化职业刻板印象。
商业价值
- 降低品牌与合规风险:部署前发现隐蔽偏见,避免公开发布后引发的公关危机或监管处罚。
- 提升内容包容性与转化率:通过减少刻板印象,生成更符合多元用户预期的图像,提高广告点击率与用户留存。
- 降本增效:ContextBias 提供自动量化指标(
BI与CCS),替代高成本的人工标注审查,可集成到模型迭代流水线中持续监控。
与现有产品/工作流的接口
ContextBias 提供现成数据集和代码(Hugging Face 、GitHub ),可作为独立评估模块插入现有 MLOps 栈:
- 模型训练后评估阶段:在 CI/CD 中增加偏见回归检查,若
BI或CCS超出阈值则阻断发布。 - 评估工具集成:与
Weights & Biases、MLflow等实验跟踪平台结合,记录偏见指标随时间变化。 - 提示工程防护:利用上下文无关、相关、无关的提示模板,构建防御性 prompt 集合,降低生产环境偏见风险。
局限
- **模型覆盖有限**:实验仅评估四个文本到图像模型,这些模型可能共享相似架构或训练数据分布,因此结论的外部效度受限。不同模型家族(如自回归模型、扩散模型变体)对上下文变化的响应可能不同,尤其最近兴起的大型多模态模型未纳入。此外,基准生成使用固定采样参数,未探索不同种子、采样步数或 CFG 强度对角色属性持续性的影响,可能低估或高估偏见强度。
- **语义控制提示的局限性**:ContextBench 依赖人工设计的语义可控提示,将角色分别置于 context-free、相关 context 和无关 context 中。但“相关性”和“无关性”的界定基于语义相似度,不能完全模拟真实世界中上下文与角色的复杂交互(例如反讽、隐喻或时空距离)。提示改写只覆盖有限句式变化,可能未触及更深层的概念组合方式。同时,92 个角色虽覆盖常见职业,但未涵盖新兴职业或跨文化角色概念,跨领域泛化性有待验证。
- **自动属性提取的误差传播**:论文使用自动视觉属性提取(如目标检测、属性分类)来量化 role-linked attributes,但这些工具的准确率并非 100%,可能引入系统性偏差,尤其对服饰、工具等细粒度属性的识别。人口统计线索的判定依赖分类器,可能对肤色、性别等属性的判断存在偏差,从而影响 pooled BI 和 CCS 等指标的可靠性。尽管论文进行了人工标注验证,但验证集的规模和标注者多样性可能有限,不能完全消除自动评估的噪声。