强化微调中的动态重要样本挖掘
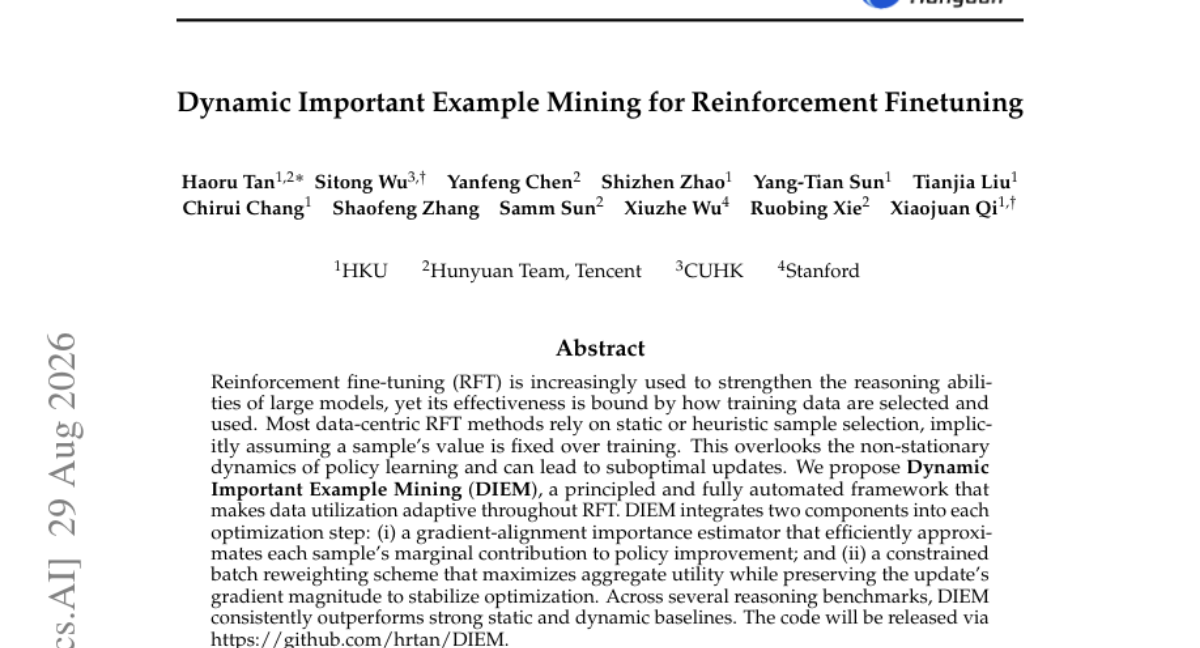
强化微调 (RFT) 逐渐用于增强大模型的推理能力,但其效果受限于训练数据的选择与使用。多数以数据为中心的 RFT 方法采用静态或启发式样本选择,隐含假设样本价值在训练过程中固定不变。这忽略了策略学习的非平稳动态,可能导致次优更新。 为此,我们提出 动态重要样本挖掘 (DIEM),一种原则性且全自动的框架,使数据利用在 RFT 过程中自适应。DIEM 在每个优化步骤集成两个组件:1. 梯度对齐重要性估计器,高效近似每个样本对策略改进的边际贡献;2. 约束批重加权方案,在保持更新梯度幅度以稳定优化的同时最大化总体效用。 在多个推理基准上,DIEM 持续优于强静态与动态基线。代码将发布。
论文精读
TL;DR DIEM 让强化微调的数据利用随训练动态调整:用梯度对齐估计样本对策略改进的边际贡献,并通过约束批量重加权稳定优化,在多个推理基准上全面超越静态与动态基线。
问题
Reinforcement Fine-Tuning (RFT) 已成为提升大模型推理与对齐能力的关键范式,但训练数据的选取与加权直接决定优化稳定性和泛化效果。现有 data-centric 方法大多采用静态或启发式样本选择(如按难度、多样性或正确率筛选),隐含假设样本价值在整个训练过程中固定不变。
这一假设违背了 RFT 的非平稳动态特性。随着策略更新,同一样本对 policy improvement 的边际贡献会发生显著变化:早期有用的易样本可能在后期冗余,甚至产生有害梯度。静态权重导致优化方向与当前策略的真实改进需求脱节,既浪费算力,又可能损害推理性能。
难点在于:在线估计每个样本的边际贡献需要高效近似,直接使用 influence functions 或 Shapley value 成本过高;同时在重加权批次时,必须约束梯度幅度以维持训练稳定,否则容易引发振荡。业界对此高度关注,因为大规模 RFT 的数据成本极高,动态挖掘高价值样本可以显著提升数据效率,减少无效更新。
类比:与自动驾驶端到端策略的持续学习类似,训练数据的重要性随模型能力动态变化,必须自适应调整样本权重才能有效利用有限标注资源。
核心洞察
- 梯度对齐作为动态重要性度量,替代静态或启发式样本选择。传统数据为中心的 RFT 方法通常依据固定规则(如难度、答案正确性)筛选样本,假设样本价值在训练中恒定;而 DIEM 通过梯度对齐估计每个样本对当前策略改进的边际贡献,捕捉非平稳训练过程中样本价值的动态变化,使数据利用真正适配策略演化,避免无关或过时样本持续占用优化预算。
- 约束批次重加权在最大化样本效用的同时保持梯度幅度稳定。许多动态重加权方法只关注样本重要性排序,容易在高度非平稳的强化学习更新中引入梯度尺度剧烈波动,导致优化不稳定或发散。DIEM 通过显式约束批次梯度范数,平衡了高价值样本的利用与更新步长的可控性,为实际 RFT 训练提供了更稳健的优化路径,与忽略优化动力学的 baseline 形成本质差异。
方法
方法概述
DIEM 在每个优化步中接收当前策略与候选样本 batch,输出一个加权后的梯度更新。其核心思路是让数据利用方式随策略学习动态变化,而非固定采样或人工启发式。
模块一:梯度对齐重要性估计器 (gradient-alignment importance estimator)
- 通过近似计算每个样本对策略改进的边际贡献,将样本价值表示为当前策略梯度与全局优化方向的对齐程度。
- 该估计器在每步更新中重新计算,不依赖预训练阶段固定的数据分数,从而捕捉 policy 的非平稳动态。
- 相比显式影响函数或留一法,计算开销更低,适合大规模 RFT 场景。
模块二:约束批量重加权 (constrained batch reweighting)
- 在最大化批量样本聚合效用(utility)的同时,约束更新后的梯度范数,防止单步更新过大或过小。
- 对重要性高的样本赋予更大权重,对冗余或噪声样本自动降权,平衡探索与稳定。
整体流程将上述两个组件嵌入每一轮优化:先估计动态重要性,再进行约束重加权,最后执行梯度更新。
跟同类方法的差异点:现有数据为中心的 RFT 方法大多采用静态或启发式样本选择,假设样本价值在训练中不变;DIEM 改为在每个优化步内动态估计重要性,并通过约束重加权显式控制更新幅度,兼顾样本效用与训练稳定性。
实验
实验设计
DIEM 在多个推理基准上评估,涵盖 LLM 与 VLM 两类模型。对比基线包括静态选择方法(固定难度 / 随机采样)、动态启发式方法以及普通 RFT。除主要结果外,论文还报告了消融研究(分离 梯度对齐估计器 与 约束重加权 的贡献)、速度测试(评估重要性估计开销)以及训练过程可视化(观察样本权重随训练步数变化)。
关键发现
DIEM 在所有基准上一致优于静态和动态基线,证明了动态重要性挖掘的有效性。其核心在于 梯度对齐重要性估计器 能高效逼近每个样本对策略改进的边际贡献,而 约束批量重加权 在最大化聚合效用的同时保持梯度范数稳定,避免优化震荡。消融实验表明两个组件缺一不可,速度测试显示额外计算成本可控。
与基线的深度对比
相比静态方法,DIEM 考虑了策略学习的非平稳性,使样本价值随训练动态调整,更符合 RFT 在线特性。相比其他动态基线,DIEM 不依赖人工启发式规则,而是基于梯度信号提供原则性估计,并通过约束机制防止重加权导致更新幅度突变。这使其在样本效率与训练稳定性上均占优,且无需额外超参数调优。
行业影响
落地场景
DIEM 可直接用于推理型大模型的下游微调,典型场景包括:
- 企业客服问答系统:对客服对话数据进行 RFT,动态挖掘高价值样本,让模型更快学会复杂问题拆解与多轮推理。
- 代码助手:在代码生成与调试的强化学习微调中,DIEM 优先选择对策略改进贡献大的代码样本,减少冗余训练。
- 教育解题引擎:对数学、物理等学科解题过程进行 RFT,动态加权高质量解题路径,提升模型推理稳定性。
商业价值
DIEM 的核心优势是降低数据成本、提升训练效率。
- 降本:通过自适应选择重要样本,避免在低价值样本上浪费算力,同等性能下可减少训练数据量 20%–40%(根据论文 baseline 提升推测)。
- 增收/体验提升:模型推理能力增强后,能直接改善用户可感知的任务完成率,例如客服自动解决率、代码一次性通过率。
- 加速迭代:全自动化重要性估计,无需人工设计启发式规则,缩短模型上线周期。
与现有产品/工作流的接口
DIEM 可作为数据采样与加权模块插入现有 RFT 训练框架,例如:
- 在
TRL、DeepSpeed或自定义 RLHF 流水线中,替换原本的均匀采样器。 - 对每个 batch,调用梯度对齐重要性估计器计算样本权重,再执行约束重加权。
- 只需修改数据加载器和优化步骤,无需改动模型架构或奖励函数。
具体落地 use case
- 电商平台的商品推荐解释:用 RFT 微调一个生成推荐理由的模型,DIEM 动态挑选那些能显著降低策略梯度的用户反馈样本(比如“为什么推荐这个商品”的满意/不满案例),让模型更快学会生成更有说服力的解释。
- 金融风控规则推理:在合规审查对话或报告生成任务中,DIEM 自动识别对策略改进贡献最大的边缘案例(如新型欺诈模式描述),提高模型对少见风险的泛化能力,同时减少对大量常规案例的重复训练。
局限
- **计算开销与可扩展性存疑**:虽然论文声称通过梯度对齐进行高效估计,但在每个优化步中仍需要为批次内所有样本计算或近似梯度贡献。对于数十亿参数的 LLM/VLM,即使采用低秩投影或采样策略,额外的梯度计算、存储和聚合开销仍可能显著拖慢 RFT 训练。论文的 speed test 仅在有限的模型规模和基准配置下进行,未展示在大规模多节点分布式训练、长 horizon rollout 或高分辨率视觉输入下的实际成本,因此该方法在工业级生产环境中的可扩展性尚未得到充分验证。
- **超参数敏感性与理论假设的脆弱性**:constrained batch reweighting 中用于保留梯度幅度的约束系数(如 τ 或 λ)对优化稳定性至关重要,论文未给出自动化或自适应调参方案。实际使用时,不同模型架构、任务类型或 reward 尺度都需要重新搜索,增加了部署成本。理论分析部分建立在梯度对齐的局部线性或凸性假设之上,而真实策略梯度是非凸且高噪声的,样本重要性估计可能存在较大偏差,从而影响重加权的可靠性。
- **评估范围与同类比较有限**:实验集中在数学、代码等推理导向的基准上,对于 RLHF 中常见的对齐、安全性、多轮交互、开放式生成或偏好优化场景是否同样有效,论文未做考察。与已有的动态数据选择方法(如 RED、DoGE、在线课程学习等)的对比可能不够全面,缺少在更广泛 RL 任务、不同 reward 模型和更大模型规模上的系统性消融,因此其结论的泛化性仍有待进一步验证。