LLMs 中的识别-拒绝错位:为什么模型会回答结构上无法回答的问题
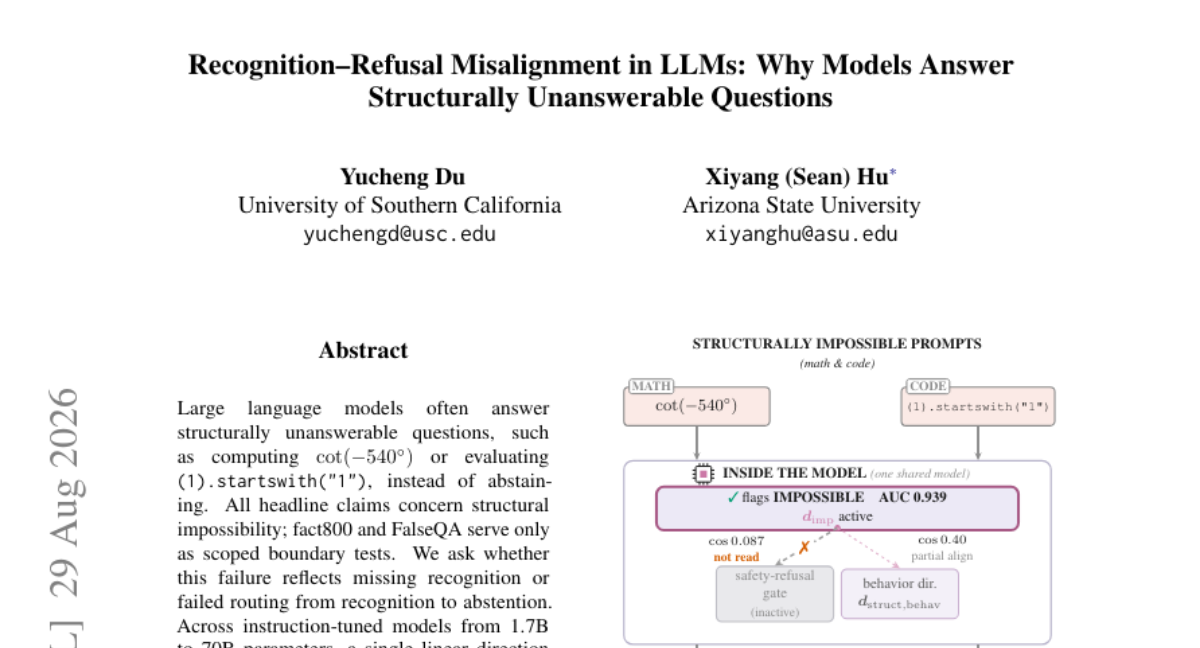
问题:大语言模型 (LLM) 常常回答结构上不可回答 的问题,例如计算 cot(-540°) 或求值 (1).startswith("1"),而不是选择弃答。作者追问:这种失败究竟是模型未能识别 不可回答性,还是从识别到弃答的路由 失败? 方法与发现:在 1.7B 至 70B 参数规模的指令微调模型 中,隐藏状态里的单个线性方向 即可区分可回答的数学/代码 prompt 与结构上不可能的 prompt,说明模型在生成前已表征「不可能性」。但该识别方向 与介导有害内容拒绝的规范安全拒绝方向 近乎正交。域内、由行为定义的无效性感知方向 更接近识别方向,却仅部分对齐,且仍与安全拒绝近正交。 实验与结论:生成时沿识别方向引导 (steering) 能在结构数学与代码单元上双向、剂量响应地改变无效性感知行为,随机方向则无此效果。Base/instruct 对比 进一步表明,这种低余弦几何在预训练终点便已存在。因此,对不可能输入的自信作答更应被解释为路由失败 而非编码失败:模型拥有可用的「无合法答案」信号,但安全拒绝通路并未与之对齐。
论文精读
TL;DR 大语言模型在隐藏状态中已编码‘问题无解’的线性方向,但该方向与安全拒绝路径几乎正交,导致模型对结构上不可回答的问题仍自信作答;论文证明这是路由失败而非识别失败,并可沿识别方向操控行为。
问题
问题背景
当前 LLM 可靠性研究关注模型是否会在不确定时正确拒绝。一个典型失败模式是:面对结构性不可回答问题(例如计算 cot(-540°) 或执行 (1).startswith("1")),指令微调模型经常给出自信但错误的答案,而不是说明“无有效答案”。
现有方法局限
已有安全对齐主要针对有害内容拒绝,通过训练一个安全拒绝方向(safety-refusal direction)来抑制有害输出。但对结构性无效输入(数学/代码中不存在合法解),模型缺乏明确的拒绝训练信号。常见做法包括:1) 直接微调模型对不可能问题输出“无法回答”,但无法保证泛化,且可能损害正常能力;2) 用线性探针检测不可能性,但仅证明表示存在,未验证该表示能否驱动行为改变。这些方法都默认:模型要么没学到“不可回答”信号,要么学到了但未正确路由到拒绝行为,但缺乏机制性分离证据。
为什么这个问题难/重要
论文发现模型内部确实存在一个线性方向能区分可回答与结构性不可能问题,但该方向与安全拒绝方向近乎正交。这意味着模型“知道”问题无解,却因路由失败而继续生成答案。这种识别-拒绝失配难以通过常规安全检查发现,因为安全基准往往只覆盖有害内容,不覆盖数学/代码的不可解情况。在真实部署中,模型对不可能查询自信作答会损害用户信任,尤其在自动化代码生成、数学推理等场景。
行业类比
这类似自动驾驶系统感知到了障碍物,但决策模块没有正确刹车——不是传感器没看到,而是信号未有效传递到执行器。
核心洞察
- 模型对结构性不可能问题的失败本质是路由故障而非编码故障:隐藏状态中已经存在可分离的 `recognition direction`,但该方向与 `safety-refusal direction` 几乎正交。与以往将错误归因于模型缺乏理解或知识边界的 baseline 不同,本文用线性探测和生成时 steering 证明该方向可因果控制无解感知行为,表明核心缺陷在于下游拒答决策没有接入已有信号。
- 这种识别–拒绝错位在基座模型阶段就已经存在,且对齐训练并未显著拉近两者的几何关系。这一发现区别于“对齐过程主要是学习何时拒绝”的常见假设,提示仅靠更多拒绝数据或 RLHF 可能不足以修复结构性不可能问题。实践中需要显式路由机制(如检测无解信号后强制触发 abstention 分支),或针对该几何方向设计干预。
方法
输入与数据构建
作者构造四类 prompt 集:math800、code800(均含结构可答与结构不可能样本)、fact800、falseqa(边界测试)。结构不可能样例包括实数域无解的 cot(-540°)、类型错误的 (1).startswith("1")。
关键模块
- 识别方向提取:对每个 prompt 取指定层最后一个 token 的隐藏状态,训练线性分类器区分可答/不可能,法向量作为 recognition direction,用 AUC 评估可分性。
- 安全拒绝方向对齐分析:获取已知 safety-refusal direction,计算与 recognition direction 的余弦相似度,发现接近正交(低余弦)。
- 行为定义无效感知方向:按模型实际行为(弃权/回答)拟合第二方向,与识别方向部分对齐,但与安全拒绝仍近正交。
- 生成时 steering:沿识别方向施加正/负扰动到隐藏状态,观察不可能问题上弃权概率的剂量响应变化,对照随机方向。
输出与结论
输出方向几何矩阵、AUC、 steering 行为曲线、base/instruct 对比。结论:模型已编码“无有效答案”信号,但安全拒绝通路未对齐使用,属路由失败而非编码失败。
与同类方法的差异点:将识别与拒绝解耦,通过方向几何和因果 steering 明确区分编码失败与路由失败,而非仅依赖行为指标。
实验
实验设计
作者构造了四类数据:math800 与 code800 为结构性不可回答的数学/代码提示(如 cot(-540°)、(1).startswith("1")),并配有可回答对照;fact800 与 FalseQA 作为边界测试,排除纯知识缺失或事实性错误。在 1.7B 到 70B 的指令微调模型上,通过线性探针寻找隐藏状态中区分可回答与结构不可能输入的方向,同时计算其与安全拒绝方向(基于拒绝有害内容训练得到)的余弦相似度。进一步做生成时干预(steering)实验,并对比 base 与 instruct 版本。
关键发现
- 单个线性方向可分离开可回答与结构不可能输入,表明模型在生成前已编码“无有效答案”信号。
- 该识别方向与典型安全拒绝方向近乎正交,余弦相似度极低。
- 行为定义的无效性感知方向与识别方向部分对齐,但与安全拒绝仍近乎正交。
- 沿识别方向进行生成时 steering,能双向且剂量依赖地改变模型对结构不可能问题的拒绝/回答行为,随机方向无此效果。
- base 与 instruct 对比显示,低余弦几何在预训练阶段已存在,对齐训练并未显著改变该结构。
与基线/同类工作对比
传统安全对齐假设拒绝行为与内容危险识别共享表示,但本文直接测量了结构无效性识别方向与安全拒绝方向的几何关系,发现二者几乎正交。这不同于一般安全研究聚焦有害内容,也区别于只做行为探测的工作。作者引入行为定义的 in-domain 方向作为更严格基线,证明其虽更接近识别方向,但仍无法被安全拒绝通路利用。这一对比强化了“路由失败”而非“编码失败”的结论:模型有可用的拒绝信号,但安全对齐机制未将其接入拒绝行为。对实际工程的启示是,针对结构不可回答类的幻觉或过度自信,需要专门设计路由模块或对齐目标,而非仅依赖通用安全训练。
行业影响
落地场景
- AI 编程助手(如 Copilot):检测代码补全中的结构性无解模式,阻止生成类似
(1).startswith("1")的无效代码。 - 数学 / 科学教育问答:对无定义表达式(如
cot(-540°))提示用户问题本身有误,而不是给出错误答案。
商业价值
- 降本:减少错误输出引发的人工复核、用户投诉及潜在法律风险。
- 体验提升:在医疗、金融等高风险场景中,模型能诚实拒绝不可回答,提升用户信任与合规性。
与现有工作流接口
- 在推理时提取隐藏状态,计算识别方向上的投影得分,作为输出前的可回答性门禁。
- 该信号可集成到 Guardrails / NeMo Guardrails 等安全层,但需单独设计路由:检测到不可回答后,可替换为澄清提问或预定义拒绝模板。
- 无需重新训练,可用 ONNX / vLLM 部署轻量分类头,作为插件嵌入现有服务。
具体 use case:电商智能客服面对“比较已下架商品的保修期”时,系统检测到结构性信息缺失,回复“当前商品信息不足,无法比较”,而非编造数据;企业知识库问答中,用户询问“2025 年财报中未披露的某指标”,模型识别问题超出可回答范围,引导用户补充上下文。
局限
- 实验聚焦于结构性不可能问题(数学与代码),虽然用 `fact800` 和 `FalseQA` 做了边界测试,但未覆盖自然语言中更常见的不可回答类型,如信息缺失、歧义、时间敏感性问题。结论是否能推广到这些场景仍需验证。此外,仅考察了指令微调模型,没有包含经过 RLHF 或其它对齐技术训练的最新模型,因此识别方向与安全拒绝方向的几何关系在不同对齐范式下是否稳定未知。
- 行为定义的 **invalidity-aware 方向** 需要针对具体任务收集不可回答样本,实际部署中难以高效获取匹配数据。方法假设单一线性方向能分离可回答与不可回答,但复杂推理或高阶逻辑任务中的不可回答性可能呈非线性分布,单一方向未必完整。另外,不同任务间提取的识别方向一致性未被系统评估,可能导致任务间泛化能力差。
- 因果操控只在 1.7B 到 70B 的稠密模型上执行,未验证更大规模(100B+)或 MoE 架构,也未系统分析操控不同层的影响差异。论文指出了识别信号与安全拒绝通路的错位,但没有提出具体对齐方案,例如如何修改安全拒绝通路以利用已有识别方向,这限制了工作的工程落地价值。相比已有的安全拒绝方向研究,本文主要贡献是诊断而非干预。