VoiceMem: 用于实时交互的流式双脑记忆
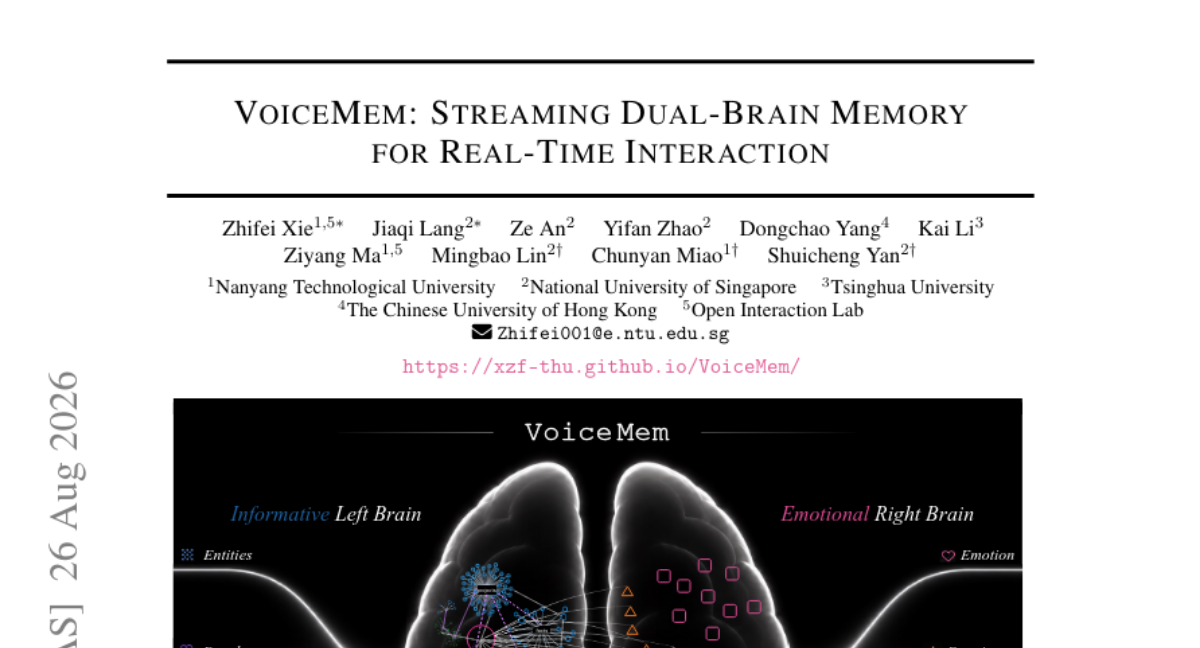
对话系统(如双工语音语言模型 SLM)仍缺乏一个流式、准确且富有同理心的记忆系统作为其灵魂。我们提出 VoiceMem,一种简单的记忆架构,包含并行的信息性左脑、情感性右脑以及流式记忆 I/O 机制。 我们进一步构建了完整的流水线,用于记忆感知的 SLM 训练、长时程评估以及可解耦部署(支持可互换的记忆后端)。实验与实际部署展示了三大优势: 1. 准确性:在 top-5 检索下,左脑比经典系统(如 Mem0 的 top-200)高出近 30 个点。 2. 情感与个性化:右脑通过短时与长时情感归因和双节点人格建模,在三个基准上达到最优性能,且相比前最佳系统综合得分提升 4.29 分。 3. 实时与低成本:VoiceMem 在 134 ms 内完成检索,远低于标准 VAD 延迟,不增加额外对话延迟,同时保持高准确率与低成本。 这些结果表明,VoiceMem 为实时、个性化、情感感知的语音交互提供了实用的记忆基础。
论文精读
TL;DR VoiceMem 为双工语音模型提供流式双脑记忆:左脑检索在 top-5 超越 Mem0 的 top-200 近 30 分,右脑建模情感与人格,134ms 延迟融入 VAD,实现实时个性化语音交互。
问题
问题背景
对话系统正从单轮问答向 双工语音语言模型 (duplex SLM) 演进,追求低延迟、可打断、能感知上下文的实时语音交互。记忆机制被视作这类系统的“灵魂”,决定了个性化与连续对话质量。
现有方法局限
当前主流的 Agent 记忆系统(如 Mem0)存在明显不足:
- 检索精度低:面向通用文本会话,对语音的多模态、口语化特征利用不足,需要极大量候选才能保证召回;
- 缺乏情感与人格建模:仅存储事实性信息,无法跟踪长期情绪倾向或人格画像,导致回复机械;
- 非流式设计:更新与检索通常为批量、离线流程,无法在 VAD 延迟窗口内完成,难以嵌入实时语音链路;
- 训练-推理割裂:记忆模块与 SLM 独立优化,无法通过端到端反馈提升记忆相关性。
为什么难/重要
- 实时性与精度的矛盾:语音交互要求毫秒级检索,而长时记忆规模庞大,传统向量索引在低延迟下精度骤降。
- 情感归因复杂:用户即时情绪由短期事件触发,而长期性格偏好需要跨会话建模,二者因果混淆会导致误判。
- 多模态流式处理:语音、文本、时间戳等多源信号需同步编码,模型必须在部分可观测状态下做增量更新。
业界对个性化语音助手、陪伴型 AI、实时客服等场景投入持续加大,准确且低延迟的记忆层已成为工程落地的关键瓶颈。
行业类比
类似 RAG 在文本 LLM 中从“能检索”进化到“高精度、低延迟、可增量更新”的过程,语音对话系统需要一种面向语音流的专用记忆范式,才能支撑真正的实时个性化交互。
核心洞察
- VoiceMem 的双脑分离架构将信息记忆与情感人格记忆解耦,分别优化,避免统一记忆在个性化与准确性间的权衡。与 Mem0 等传统单一记忆系统相比,左脑专注高效检索,右脑专注情感归因与人格建模,两者独立演进并通过流式 I/O 协调,提升整体性能。这种解耦使得情感个性化不需要牺牲检索精度,也便于分别调优和替换后端。
- 流式记忆 I/O 机制让 VoiceMem 在 134 ms 内完成检索,与 VAD 延迟对齐,不引入额外对话延迟。区别于先存储后检索的离线方案,流式 I/O 支持边听边更新、边检索,满足 duplex 语音模型的实时交互需求。同时解耦的上层路由-下层引擎架构允许替换记忆后端,降低部署成本,提高系统灵活性,对工程实践有直接价值。
- VoiceMem 构建了完整的记忆感知 SLM 训练与长时程评估流水线,弥补现有语音对话系统缺乏长期记忆评测的空白。现有工作多关注单轮或短程记忆,VoiceMem 提出 ChatMem-Bench 等长时程基准,并通过黑盒 OPD 训练将记忆能力注入 SLM,使得模型能利用外部记忆进行个性化回应,为后续研究提供可复用的方法论和基准。
方法
输入与总体流程
VoiceMem 接入 duplex speech language model (SLM) 的语音对话流。每次用户语音经 VAD 分段后,系统触发记忆读写:将当前对话上下文作为查询,同时并行走左脑信息检索与右脑情感/人格检索。
关键模块
- 左脑(Informational Left Brain):负责事实型记忆的高效存取。采用快速更新机制,检索阶段以 top-5 候选即达到高精度,优于 Mem0 在 top-200 的表现。实现细节上,摘要强调“Efficient Memory Access Retrieval. Fast Update.”,说明其索引与写入路径经过专门优化,能够在保持低时延的同时维持准确率。
- 右脑(Emotional Right Brain):包含 Persona Graph,对用户进行双节点人格建模(dual-node persona modeling)。其情感记忆通过短时程与长时程 affective attribution 进行归因,将情感信号附着到记忆条目上。检索时结合当前会话与历史人格图,输出与用户情感状态、偏好相关的记忆。
- 流式双脑检索(Streaming Dual-Brain Retrieval):左右脑并行执行,通过 memory I/O 机制统一调度,总检索延迟约 134 ms,低于常规 VAD 延迟,因此不会引入额外对话停顿。
训练与部署
提出 memory-aware SLM training,使语音模型在生成时能利用检索到的记忆。部署采用 Black-box OPD Training 与 Decoupled Upper-level Routing–Lower-level Engine Architecture:上层路由决定使用哪些记忆后端,下层执行具体检索,支持可互换的 memory backends(如向量库、图数据库)。
输出
检索得到的信息记忆与情感/人格记忆被注入 SLM 的上下文,最终生成个性化、情感一致且基于长期记忆的语音回复。
与同类方法(如 Mem0 仅做通用信息检索、缺乏情感建模与流式优化)相比,VoiceMem 通过双脑并行架构和 memory-aware 训练,在更低检索预算下同时达成信息准确率与情感个性化,并把延迟压缩到 VAD 窗口内。
实验
实验设计
VoiceMem 在 流式双脑架构 上构建了完整评估:左脑记忆采用 top-k 检索 评测,对比 Mem0 等经典系统;右脑在三个 人格基准 上评估情感归因与双节点人格建模;另提出 ChatMem-Bench 用于长时域语音助手记忆评测。部署层通过解耦上下层路由与底层引擎,支持可交换记忆后端。
关键发现
- 左脑:top-5 检索准确率较 Mem0 top-200 提升近 30 个百分点,说明信息性记忆的检索效率与精度同步提升。
- 右脑:在三个人格基准上取得 SOTA,综合得分较此前最佳系统提升 4.29 分,验证短时/长时情感归因与双节点人格建模的有效性。
- 实时性:检索延迟 134 ms,处于标准 VAD 时延窗口内,不增加额外对话延迟,且成本低。
基线对比解读
相较于 Mem0 等传统记忆系统依赖大规模召回后排序,VoiceMem 通过 并行双脑 与 流式 I/O 将精度与延迟解耦:左脑以更小 top-k 反超,右脑从 事实记忆 扩展到 情感与人格记忆。这为实时语音交互产品提供了低延迟、个性化响应的工程路径。
行业影响
落地场景
VoiceMem 适用于 实时语音助手、客服机器人、陪伴型虚拟人 及 车载语音交互 等产品。其 双脑架构 同时管理事实性信息与情感状态,特别适合需要长期用户画像和即时情感响应的场景。例如,电商语音客服 可记住用户历史订单、偏好与投诉情绪,在后续对话中主动推荐或安抚;教育语音辅导 可追踪学习者进度与情绪波动,动态调整讲解策略。
商业价值
- 降本:流式检索延迟仅
134ms,低于标准 VAD 延迟,无需额外后台计算,节省推理成本;左脑 top-5 检索精度超过 Mem0 top-200 近 30 点,显著减少召回补全与人工兜底。 - 增收 / 体验提升:情感右脑在 persona 基准上达到 SOTA,提升用户留存与付费转化;在陪伴类应用(如 AI 伴侣)中,连贯的个人化记忆可增强用户粘性,间接拉动订阅或增值服务收入。
与现有产品 / 工作流的接口
VoiceMem 提供 解耦部署,可替换记忆后端,容易接入现有语音管线:在 VAD → ASR → SLM → TTS 链路中,于 SLM 之前或之内插入 memory I/O 层。其 black-box OPD 训练允许无需修改底层模型即可注入记忆能力,适合已有语音模型快速升级。同时,项目提供完整训练、长时评估(ChatMem-Bench)与部署 pipeline,团队可按需替换向量库或图数据库。
局限
- 论文提出的 **左脑**(信息记忆)与 **右脑**(情感 persona 记忆)在架构上相互独立,通过 **流式检索** 合并输出,但缺乏跨脑联合推理或统一优化目标。在需要同时利用事实和情感线索的复杂对话场景中,两个模块的简单拼接可能丢失跨模态关联,导致回答不够连贯或缺乏情境敏感性。此外,左右脑各自维护独立的状态,长期交互下信息同步和一致性未得到明确保证,可能引发记忆漂移或矛盾。
- 实验主要基于三个 **persona benchmarks** 和特定的信息检索评测,真实开放域对话中的长期记忆一致性、对噪声语音输入的鲁棒性、以及跨会话记忆累积的效果尚未充分验证。同时,与 **Mem0** 的对比集中在检索准确率,未与 **MemGPT**、**Zep** 等更复杂的记忆管理框架进行公平比较,因此其在系统级功能(如记忆压缩、冲突消解)上的优势尚不明确。此外,论文未提供大规模用户研究或 A/B 测试数据,实际用户体验的改善程度有待进一步证明。
- **VoiceMem** 报告了 **134 ms** 的检索延迟,位于 **VAD** 延迟窗口内,但该指标仅覆盖记忆检索阶段,未包含 **SLM** 推理、记忆更新、跨模块通信等端到端开销。在实际部署中,解耦的 **upper-level routing** 与 **lower-level engine** 架构虽然提升了灵活性,但也引入了额外的网络通信和序列化成本,可能推高整体响应延迟。此外,论文未详细分析不同记忆后端(如向量数据库选择)对成本和延迟的影响,不利于工程团队评估资源预算。