TorchMorph: CUDA 加速的形态学变换
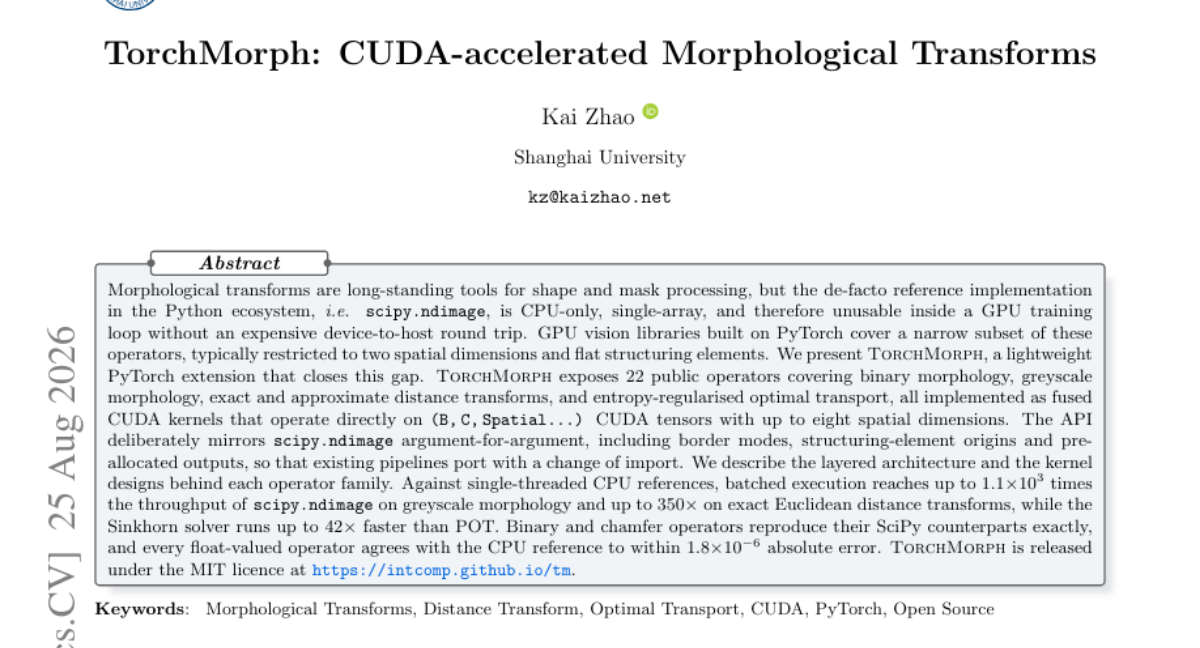
形态学变换是形状与掩膜处理中的经典工具。然而,Python 生态中事实上的参考实现 scipy.ndimage 仅支持 CPU、单数组处理,因此无法在 GPU 训练循环中直接使用,除非付出昂贵的设备到主机往返开销。基于 PyTorch 的 GPU 视觉库通常仅覆盖其中一小部分算子,且往往局限于二维空间与平坦结构元素。 本文提出 TorchMorph,一个轻量级 PyTorch 扩展,填补了这一空白。它提供 22 个公开算子,涵盖二值形态学、灰度形态学、精确与近似距离变换、熵正则化最优传输,全部实现为融合式 CUDA 内核,可直接操作最多 8 个空间维度的 (B, C, Spatial...) CUDA 张量。其 API 刻意逐参数对齐 scipy.ndimage,包括边界模式、结构元素原点与预分配输出,因此现有流程只需更改 import 即可移植。我们描述了各算子族背后的分层架构与内核设计。 实验表明,相较于单线程 CPU 参考实现,批量执行在灰度形态学上达到 scipy.ndimage 最高 1.1e3 倍吞吐,精确欧氏距离变换最高 350 倍;Sinkhorn 求解器比 POT 快 42 倍。二进制与 chamfer 算子与 SciPy 对应实现完全一致,所有浮点算子与 CPU 参考的绝对误差均在 1.8e-6 以内。TorchMorph 以 MIT 许可证发布,地址为 https://intcomp.github.io/tm。
论文精读
TL;DR TorchMorph 是一个 PyTorch 扩展,提供 22 个 CUDA 融合核实现的形态学与距离变换算子,支持高达 8 维张量,API 对齐 scipy.ndimage,GPU 批量执行比 CPU 快上千倍。
问题
问题背景
数学形态学是图像分析的基础算子,在分割后处理、边界感知损失、骨架化、Hausdorff 距离代理等任务中持续发挥作用。随着训练循环全面 GPU 化,业界需要能够在 GPU 张量上直接运行的形态学原语,以避免跨设备数据搬运。
现有方法局限
- scipy.ndimage 是 Python 生态的事实标准,但 CPU-only、单数组,无法直接用于 GPU 训练循环;调用时需
tensor.cpu().numpy()往返,代价高昂且打断异步流水线。 - PyTorch 生态的 GPU 视觉库(如 Kornia、torchvision)只覆盖少量形态学算子,通常限制在 2D 空间、平坦结构元素;缺少高维、非平坦、精确距离变换和熵正则 OT 求解。
- 现有库多不支持批处理
(B, C, Spatial…)、border_mode、结构元素origin、预分配输出等 SciPy 兼容参数,导致已有管线迁移成本高。
为什么难/重要
技术挑战在于:需要为每个算子族设计融合 CUDA kernel,减少 global memory 往返;支持最多 8 个空间维度、多种边界模式与结构元素原点;同时保证数值精度与 SciPy 参考实现对齐(本文中绝对误差 ≤ 1.8e-6)。
业界关注度来自高维数据(医学影像 3D 体积、点云、视频、卫星影像)的形态学需求,以及距离变换和 Sinkhorn 求解在分割损失、点云匹配、生成模型中的频繁使用。GPU 原生实现可实现 350x-1100x 吞吐提升,直接影响训练迭代效率。
行业类比
正如 Kornia 为 PyTorch 补齐 GPU 原生几何变换与图像滤波,TorchMorph 为形态学变换提供同等的 GPU 张量原生能力,可无缝嵌入自定义损失函数与数据增强管线。
核心洞察
- TorchMorph 提供与 scipy.ndimage 参数级兼容的 GPU 形态学算子 API,解决了深度学习训练循环中因 CPU 形态学操作导致的设备间数据搬运瓶颈。现有 GPU 视觉库如 Kornia 仅覆盖二维平坦结构元素,而 TorchMorph 支持批量、多通道、高达八维空间维度,并完整复刻边界模式、结构元素原点等语义,使现有代码仅需修改导入即可将形态学处理无缝移至 GPU,消除了 CPU-GPU 往返开销。
- TorchMorph 采用融合 CUDA kernel 设计,将形态学操作、距离变换和熵正则最优传输统一到同一批量计算框架中,并针对批量 tile 优化 Sinkhorn 求解器,实现了比 scipy.ndimage 最高 1100 倍、比 POT 最高 42 倍的吞吐量提升。这种跨算子族的统一架构不仅减少了内存访问次数,还保证了数值精确性(二进制和 chamfer 算子与 SciPy 完全一致,浮点算子绝对误差小于 1.8e-6),为需要可微或 GPU 原生形态学层的应用(如边界感知损失、骨架化)提供了可靠且高效的底层原语。
方法
输入与 API 层
TorchMorph 接受 (B, C, Spatial...) 形状的 CUDA 张量,空间维度最高支持八维。API 完全模仿 scipy.ndimage 的参数签名,包括边界模式、结构元素原点以及预分配输出,用户只需修改 import 即可迁移现有代码。
关键模块与内核设计
架构上分为三层:Python 绑定层、调度层和融合 CUDA 内核层。调度层根据输入维度与数据类型自动选择最优内核。
- 融合形态学内核:将腐蚀 / 膨胀的邻域聚合与比较操作融合到单个 kernel 中,避免中间张量写入,支持二值与灰度、平面与非平面结构元素。
- 距离变换内核:精确欧氏距离变换采用两遍扫描算法(类似 Felzenszwalb),近似距离变换使用 chamfer 距离(如 3-4-5 权重),均针对 GPU 线程块与共享内存优化。
- 批量平铺 Sinkhorn 求解器:将批量熵正则最优传输问题平铺到 GPU 线程块上,利用共享内存缓存代价矩阵,实现高吞吐求解。
输出与对齐验证
所有算子直接在 GPU 上输出结果张量,无需 device-to-host 拷贝。测试阶段与 scipy.ndimage 逐位对比:二进制和 chamfer 算子完全一致,浮点算子绝对误差不超过 1.8e-6。
与同类方法的差异点:相比 PyTorch 生态中仅支持二维、平面结构元素的 GPU 视觉库,TorchMorph 首次覆盖最高八维空间、任意结构元素的完整形态学算子集,并提供 SciPy 兼容 API,可作为训练循环内的 drop-in replacement。
实验
实验设计 论文未指定外部数据集,基准在算子级张量上对比 scipy.ndimage 单线程 CPU 参考与 POT 的 Sinkhorn 求解器。测试覆盖二值/灰度形态学、精确与近似距离变换,以及熵正则最优传输;张量形状为 (B, C, Spatial...),空间维度最高 8 维,参数完全对齐 scipy.ndimage(边界模式、结构元素原点、预分配输出)。数值一致性通过逐位比较(二值/chamfer)和最大绝对误差(浮点算子)评估。
关键发现 在批量执行下,灰度形态学吞吐最高达单线程 scipy.ndimage 的 1.1e3 倍;精确欧氏距离变换达 350×;Sinkhorn 求解器比 POT 快 42×。二值和 chamfer 算子与 SciPy 输出逐位一致,所有浮点算子与 CPU 参考的最大绝对误差不超过 1.8e-6。
与基线对比解读 scipy.ndimage 是事实标准但受限于 CPU 单数组,无法直接在 GPU 训练循环中使用;PyTorch 生态覆盖窄(通常仅 2D、平坦结构元素)。TorchMorph 通过 fused CUDA kernels 直接在批张量上计算,消除了 device-to-host 往返和逐算子启动开销,这是吞吐大幅领先的根本原因。对实际工程而言,这意味着现有管线只需改 import 即可迁移到 GPU,无需重写边界/原点逻辑,且预分配输出有助于降低显存碎片。
行业影响
落地场景
TorchMorph 直接将 scipy.ndimage 的形态学算子迁移到 GPU,覆盖 binary morphology、greyscale morphology、distance transform 与 Sinkhorn optimal transport,并支持最高 8 维张量。在以下产品/业务中可直接使用:
- 自动驾驶感知:对语义分割输出做连通组件标记、小区域去除、骨架化,或利用距离变换生成边界权重图用于损失函数。
- 医学影像分析:3D CT/MRI 分割后的孔洞填充、形态学平滑、肿瘤区域后处理,无需将体数据传回 CPU。
- 工业视觉检测:缺陷区域细化、背景抑制、基于距离变换的缺陷尺寸测量。
- 遥感影像处理:高维多光谱数据的批量形态学操作。
商业价值
主要收益来自 降本增效:
- 消除 CPU-GPU 数据往返,训练循环中形态学操作吞吐提升最高 1100 倍(greyscale morphology)和 350 倍(Euclidean distance transform),显著缩短迭代周期。
- 统一 API 与 scipy.ndimage 几乎一致,迁移成本极低,无需重写现有 pipeline,减少工程维护开销。
- MIT 许可证降低商业使用法律风险,适合作为内部基础库集成。
与现有产品/工作流的接口
TorchMorph 可直接替换 from scipy.ndimage import ... 为对应 PyTorch 调用,保持参数名、边界模式、结构元素原点等语义一致。集成方式:
- 在 PyTorch 数据加载或增强 pipeline 中调用,输出张量支持自动求导(如为可微算子)。
- 与现有 GPU 视觉库(如 Kornia、MONAI)互补,填补高维与完整形态学算子的空白。
- 支持预分配输出张量,便于在推理服务或实时系统中复用显存。
具体 use case:
- 自动驾驶车道线分割:训练时对分割 mask 做距离变换,生成车道边界附近的软权重图,指导损失函数聚焦边界区域,提升车道线连续性。
- 医学影像放疗规划:在 GPU 上对 3D 器官分割结果做形态学膨胀/腐蚀,快速生成肿瘤靶区与危及器官的安全边界,避免 CPU 瓶颈。
局限
- **平台依赖与覆盖范围**:TorchMorph 目前仅提供 CUDA 后端,依赖 NVIDIA GPU 生态,无法在 AMD、Apple Silicon 等加速器上运行,限制了跨平台部署。虽然 API 声称镜像 scipy.ndimage,但仅实现 22 个算子,并非完整覆盖(例如非平坦结构元素、灰度重建、标记控制等高级形态学操作缺失),依赖这些特性的现有管线仍需回退到 CPU 或自行实现。此外,最高支持八维空间维度,但高维场景下内存与计算复杂度急剧上升,论文未提供高维数据的性能评测,实际可用性存疑。
- **实验对比基准的局限**:性能加速倍数基于单线程 CPU 的 scipy.ndimage 参考实现,未与多线程 CPU 或已有的 GPU 形态学库(如 Kornia、CuPy)进行系统比较,可能导致加速比被高估。在实际工程中,用户常使用多线程 CPU 或其他 GPU 库,TorchMorph 的相对优势可能缩水。对于小批量或小尺寸输入,GPU 内核启动与调度开销可能抵消计算优势,论文未讨论此类场景的性能表现。
- **工程集成与维护风险**:作为独立 PyTorch 扩展,需要用户编译 CUDA 内核,增加了安装复杂度和与 PyTorch/CUDA 版本匹配的负担。项目 GitHub 星数仅 1,社区维护与长期支持存在不确定性。浮点算子绝对误差 1.8e-6 虽小,但对高精度任务(如医学图像分析中的精确距离)可能仍不可接受;二值算子虽与 SciPy 输出一致,但灰度算子仅为近似对齐,没有实现 bit-exact 复现,在需要严格一致性的场景下存在风险。