ReWorld: 具有长时记忆的交互式世界模型
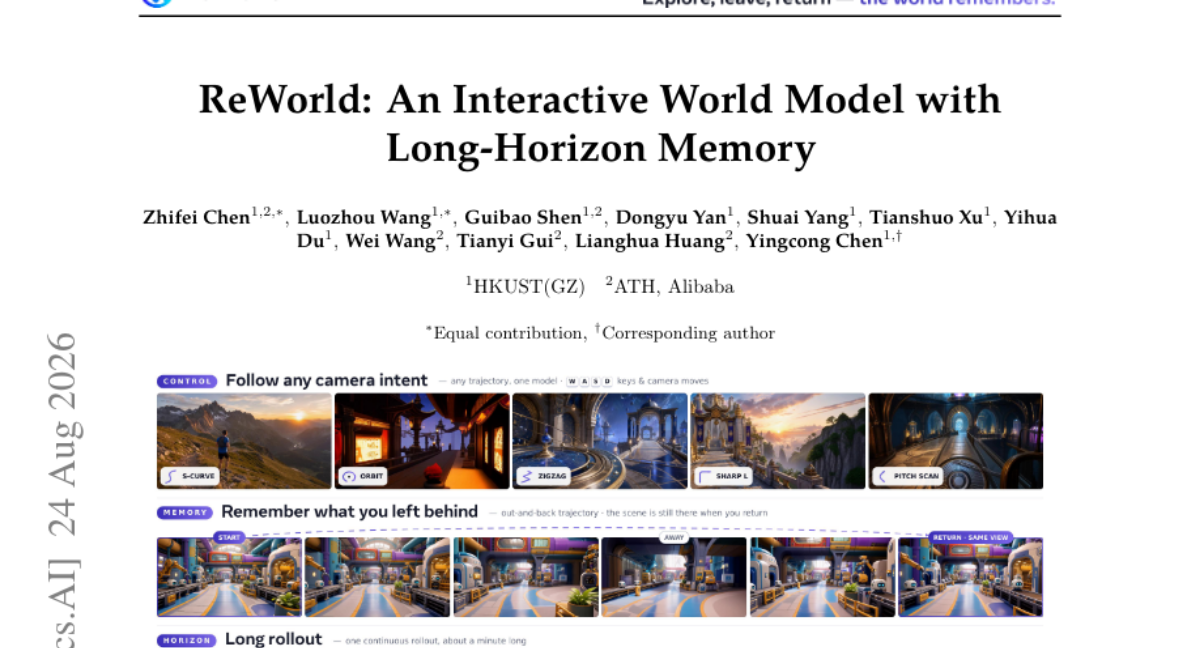
ReWorld 提出一种交互式世界模型,同时满足动作跟随(短时程控制)与长时程记忆(无界历史)的需求。训练时将两者解耦,推理时以固定预算限制。 方法上,混合逐头注意力窗口 将大多数头限制在近期,少数全局头关注全部历史;随机头路由 防止能力绑定到特定头;随机块丢弃 使稀疏历史在分布内。推理时,有界 KV 缓存由位姿索引地标库 支撑,检索最近地标。 数据引擎按度量尺度对齐 将八种来源(Unreal 渲染飞行、游戏漫游、真实视频)统一到同一动作尺度;回文轨迹 提供重访证据。分布匹配蒸馏 在 LoRA 适配器上把采样压缩到 4 步,统一骨干支持多步高质量与实时交互,流式输出 704x1280 视频。 实验:在动作跟随、长时召回、视频质量三轴协议上对比六个近期模型,ReWorld 取得最佳控制保真度(旋转误差 11.95°,相机运动一致性最佳)与最佳生成质量;在 64 秒、384 潜变量的往返 rollout 中,固定 12 块缓存仍能重建起点视图,而滑动窗口已遗忘证据、全 KV 注意力则内存不足。
论文精读
TL;DR ReWorld 通过混合注意力窗口分离短时控制与长时记忆,并以姿态索引地标库和有界 KV 缓存实现实时交互式世界模型,在操控精度和分钟级回访生成上超越现有方法。
问题
问题背景
交互式世界模型(Interactive World Models)正聚焦于在实时流式生成中同时满足 相机可控性 与 长期记忆一致性。
现有方法局限
现有模型通常采用滑动窗口注意力或 KV 缓存截断,动作控制与记忆检索耦合在同一机制中。滑动窗口会逐步丢弃早期帧证据,导致模型在 64 秒级往返 rollout 中无法重建起点视图;全 KV 注意力则内存随序列长度增长,难以保证实时推理。此外,训练数据来自不同尺度的渲染与真实视频源,缺乏统一的物理动作标定,跨数据集控制幅度不一致,模型难以泛化到新的动作尺度。
为什么这个问题难/重要
核心挑战在于结构性张力——控制需要短时注意力窗口以快速响应动作,记忆需要全局注意力覆盖完整历史,两者计算模式相互冲突。业界对高保真、可交互、长时世界模型的需求日益迫切,尤其在 VR/AR、具身智能仿真、游戏引擎等场景中,系统既要稳定跟随输入,又要保留环境状态,任何一方的缺失都会导致交互断裂。
行业类比
这类问题与自动驾驶仿真中同时处理实时方向盘指令和记住数月前的路口地标相似,现有交互模型常顾此失彼。
核心洞察
- ReWorld 的核心洞见是将短时控制与长时记忆解耦到不同的注意力头,并通过随机头路由避免能力固化。与以往世界模型使用统一全注意力或滑动窗口不同,该模型在训练时显式划分头功能:多数头只关注近期上下文以快速响应动作,少数全局头关注全历史以维护长期记忆。这种结构化分离让模型在推理时能独立优化两种能力,而随机路由保证任何头都不会退化为单一功能,增加了鲁棒性。
- 推理阶段采用姿态索引地标库实现有界 KV 缓存,将长期记忆重构为基于空间位置的检索,而非传统的时间顺序滑动窗口。这一设计利用世界模型固有的几何一致性,使模型在回访已见过的地点时,只需检索当前姿态附近的地标即可恢复历史信息,计算成本固定。相比之下,滑动窗口会随时间推移丢失早期证据,全 KV 缓存则因内存无界而无法长时间运行。该策略为长时交互生成提供了一种可扩展的记忆管理范式。
- 度量尺度对齐的数据引擎加回文轨迹,为训练具有空间一致性和重访证据的世界模型提供了关键支撑。八个来源的数据统一到同一物理动作尺度,确保相同按键移动相机相同距离,消除跨源动作映射的歧义;回文轨迹强制模型在往返中观察同一地点两次,为长期记忆训练提供直接监督。这种数据构造方法直接针对交互世界模型的两个常见失败模式:动作尺度漂移和回访记忆缺失,是超越模型架构的系统级创新。
方法
输入与输出线索
输入为用户动作(相机控制信号)与历史视频帧,输出为实时流式视频(分辨率 704x1280,支持 photorealistic / game-style / stylized 世界),同时保持动作跟随与长时记忆。
关键模块
- 训练期控制与记忆分离:采用 mixed per-head attention windows,将大多数注意力头限制在近期上下文,保留少量 global heads 关注完整历史;配合 random head routing 避免能力固化,以及 random chunk dropping 使稀疏历史成为训练分布内样本。
- 推理期有界 KV 缓存:使用固定 12-chunk 缓存,并引入 pose-indexed landmark bank,根据当前相机位姿检索最近的地标 token,将长时记忆压缩到固定预算。
- 度量尺度对齐的数据引擎:统一 8 个数据源(Unreal fly-throughs、游戏漫游、真实世界视频)的物理动作尺度,保证相同按键在不同源中移动相同距离;构造 palindrome trajectories 提供回访证据,强化记忆训练。
- 蒸馏与实时推理:通过 distribution-matching distillation 将采样步数压缩至 4 步,蒸馏更新仅限制在 LoRA adapter 中,使同一 backbone 同时支持高保真多步模式与实时交互模式。
与同类方法差异
ReWorld 在训练中结构化解耦控制与记忆,并在推理时用位姿索引记忆库替代滑动窗口或全 KV,从而在分钟级回放中保持起始视图重建,而滑动窗口会遗忘、全 KV 会耗尽内存。
实验
实验设计
ReWorld 在 8 个来源 的数据引擎上训练,包括 UE-rendered fly-throughs、游戏漫游视频与真实世界素材,通过 metric-scale alignment 将不同来源映射到同一物理动作尺度;palindrome trajectories 提供重访轨迹以训练长程记忆。评估采用三轴协议:camera controllability、long-horizon memory、video quality,与 6 个近期 interactive world models 对比。
关键发现
- 控制精度:旋转误差 11.95°,相机运动一致性最佳;
- 生成质量:在照片级、游戏级、风格化场景中均取得最佳结果;
- 长程回忆:64 秒 out-and-back 序列(384 latents)下,固定 12-chunk cache 仍能重建起始视图;此时滑动窗口已驱逐历史证据,full-KV 注意力显存溢出。
基线对比解读
训练期 mixed per-head attention windows + global heads 与推理期 pose-indexed landmark bank 的组合,在长程记忆上显著优于滑动窗口与 full-KV 基线,证明显式地标检索比无差别扩张上下文更高效。random head routing 与 random chunk dropping 让稀疏历史成为分布内样本,提升泛化。LoRA 蒸馏 将采样压缩到 4 步实现实时 704x1280 流式输出,验证了同一骨干同时支撑高保真多步与实时互动两种模式的可行性。
行业影响
落地场景
ReWorld 适用于需要实时可控世界生成的产品:
- 交互式虚拟空间(游戏、元宇宙、虚拟旅游):玩家自由操控视角,模型在长时回环后仍能恢复起始视图,避免漂移。
- 自动驾驶仿真:由真实行驶数据生成闭环仿真环境,测试感知与规划算法;长时记忆保证重访路线的一致性。
- 电商虚拟展厅 或 虚拟导购:顾客漫游时系统记住浏览路径与商品位置,增强沉浸式购物体验。
商业价值
- 降本:四步采样 + 有界
KV cache降低推理延迟与显存,单卡可服务多路实时流;一个骨干支持多步高保真与实时两种模式,减少部署成本。 - 提体验:度量尺度对齐使同一按键在不同数据源下移动相同物理距离,控制更直觉;动作保真度(11.95° 旋转误差)与长时一致性降低用户眩晕感,提升留存。
- 增收:高一致性世界模型可加速内容生产(如虚拟场景生成),缩短制作周期。
与现有产品/工作流的接口
- 作为可插拔世界模型后端:通过 LoRA 蒸馏出的轻量适配器,可直接挂载到现有多模态视频生成 backbone(如 DiT),无需全量重训。
- 缓存与检索模块独立:位姿索引地标库可作为推理服务中间件,替换现有滑动窗口或全 KV 缓存,提供固定显存下的长时记忆。
- 数据引擎复用:度量尺度对齐与 palindrome 轨迹增强可指导合成数据管道,提升现有 video world model 的控制能力。
项目主页: ReWorld 提供代码与演示。
局限
- 模型范围受限:ReWorld 主要解决相机可控的视觉流生成,其控制信号仅限于相机旋转/平移等度量尺度动作,未涉及物体交互、物理状态变化或自由文本指令。数据引擎也主要围绕导航/漫游轨迹构建,因此模型在处理更一般的具身智能任务时可能泛化不足。
- 实时模式的保真度折衷:作者通过分布匹配蒸馏将采样压缩到四步,并用 LoRA 适配器支持实时模式。但论文未充分展示实时模式与高保真多步模式之间的感知质量差距。LoRA 蒸馏可能引入细节丢失或时序伪影,尤其在高动态场景或长距离回忆中,实时模式的健壮性仍有待验证。
- 对姿态估计与尺度对齐的依赖:推理时地标库基于当前姿态检索,数据管线的度量尺度对齐要求所有来源在同一物理动作尺度上。如果实际部署中相机姿态噪声较大或缺乏精确的尺度标定,最近邻地标检索可能失效,影响长期记忆的准确性。此外,固定 KV cache 预算和 chunk 大小可能限制了模型在极端长序列或非平稳轨迹下的适应能力。