提问或回答:多轮健康错误信息干预的决策框架
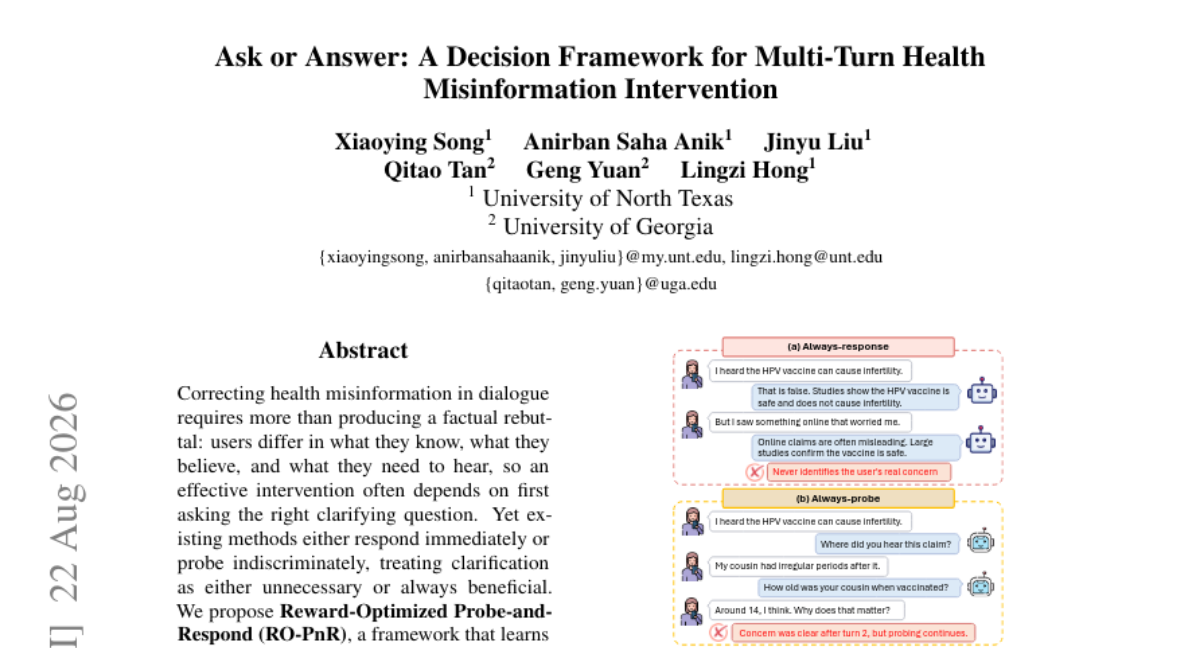
在对话中纠正健康错误信息,不能仅仅给出事实性反驳。用户的已知、所信与所需各不相同,有效的干预往往取决于先提出恰当的澄清问题。然而现有方法要么立即回应、要么无差别探查,将澄清视为不必要或总是有益。为此,我们提出 Reward-Optimized Probe-and-Respond (RO-PnR) 框架,学习何时提问是值得的。 在每个轮次,RO-PnR 在“探查更多信息”与“commit 最终纠正”之间做出选择,由轮次奖励驱动,该奖励权衡探查的预期收益与交互成本。为了刻画用户异质性对探查价值的影响,我们为每个模拟用户构建一个潜在状态,覆盖健康素养与信念承诺两个维度。 实验在三个健康错误信息数据集和三个基础模型上进行,结果表明 RO-PnR 达到了最高的成本调整效用,并以比 always-probe 基线少 30% 的轮次实现这一效果。
论文精读
TL;DR RO-PnR 框架在多轮健康纠错对话中动态决定何时提问澄清、何时直接给出纠正,用回合级奖励权衡信息增益与交互成本,较 always-probe 省 30% 轮次且成本调整效用最高。
问题
问题背景
健康错误信息对话式干预中,用户差异显著,有效策略需根据用户知识、信念动态调整。
现有方法局限
- 静态响应:要么立即给出事实纠正,忽略用户真实误解点;要么无差别持续追问,增加交互成本。
- 缺乏决策优化:未量化探询的预期信息增益与轮次开销,不能判断何时提问“值回票价”。
- 用户异质性未建模:健康素养和信念承诺不同的用户对澄清的接受度不同,现有方法未利用这一潜在状态。
为什么这个问题难/重要
- 用户状态不可直接观测,需从对话历史推断;单轮决策错误将导致后续纠正失败或用户流失。
- 探询与回应之间存在预算权衡:过度探询降低效率,过早回应可能无法纠正深层误解。
- 业界对对话系统的成本控制与用户体验要求严格,多轮澄清策略需在真实场景中验证。
行业类比
类似主动学习中的查询选择,但需在对话上下文中考虑用户心理状态与轮次预算,而非单纯样本不确定性。
核心洞察
- 该框架将澄清提问视为一项不确定性下的决策,而非固定流程步骤。RO-PnR 引入回合级奖励,在信息增益与交互成本之间权衡,使系统能够有选择地提问,而不是像 always-probe 基线那样浪费轮次并消耗用户耐心,也不是像 immediate-answer 基线那样忽略用户状态。这种决策论视角把对话干预从纯生成问题提升为策略优化问题。
- 通过用健康素养和信念承诺两个维度建模用户的潜在状态,RO-PnR 首次将用户异质性显式纳入探询决策。以往工作通常假设用户同质,或只做浅层个性化。该框架利用潜在状态预测探询后纠正效果的期望增益,让策略只在对特定用户探询能显著提升最终说服力时才提问,从而在同等的纠正质量下减少约 30% 的交互轮次。
方法
输入与任务定义
多轮对话中,系统接收用户关于健康错误信息的陈述及历史上下文,需在每轮决定是 提问澄清(probe)还是 给出最终纠正(respond)。
关键模块
潜在用户建模
每个用户由两个潜在维度刻画:健康素养(health literacy)与 信念承诺(belief commitment)。模拟器根据这两个维度生成不同用户的反应,从而体现“澄清价值因人而异”。Probe-or-Respond 策略
策略网络以当前对话状态为输入,输出离散动作:probe或respond。选择probe时会生成一个澄清问题以获取用户更多信息;选择respond时终止探测并输出最终纠正文本。Turn-level 奖励设计
每轮动作获得一个奖励,计算方式为:探测带来的期望信息增益 减去 交互成本(如额外轮次造成的用户耐心损耗)。如果探测不能显著改善最终纠正质量,成本会抑制不必要的提问。优化过程
通过强化学习优化策略,最大化累积折扣奖励。模拟用户提供的多样轨迹使策略学会“何时提问值得”,而非固定启发式。
输出
每轮输出一个动作及其对应的文本(问题或纠正),最终在合适时机结束对话并交付答案。
与同类方法的差异点
不同于 immediate-respond(从不提问)和 always-probe(总是先提问)的固定策略,RO-PnR 利用 turn-level reward 与用户潜在状态动态权衡提问成本与信息收益,在连续决策中学习最优提问时机。
实验
实验设计
RO-PnR 在三个健康错误信息数据集(名称未具体列出)上,分别基于三个基础模型进行评测,与立即回应和 always-probe 等基线对比。评价指标包括 cost-adjusted utility、Adaptation、Factual reliability、Dialogue quality。用户模拟建模为 health literacy 和 belief commitment 两个潜在维度,以覆盖异质性。
关键发现
- RO-PnR 在所有数据集和基础模型上取得最高 cost-adjusted utility。
- 相比 always-probe 基线,RO-PnR 使用约 30% 更少回合,表明其能动态判断探询是否值得。
- 在用户 profile 分析上,对不同 health literacy 和 belief commitment 的用户表现稳健。
- Human validation 显示模型决策与人类判断较高一致性。
基线对比解读
- vs always-probe:always-probe 无差别提问,浪费交互成本;RO-PnR 根据用户潜在状态决定是否探询,显著减少无效回合,同时保持或提升最终纠正效果。
- vs 立即回应:立即回应忽略用户认知差异,对高信念承诺用户可能失败;RO-PnR 通过探询获取关键信息,实现个性化干预。
- 结果验证了 turn-level reward 设计在权衡探询收益与成本上的有效性。
行业影响
落地场景
RO-PnR 的核心是学习“何时提问、何时直接回答”,可直接用于需要多轮澄清的 AI 对话产品。典型场景包括:
- 医疗健康咨询机器人:用户陈述健康误区(如疫苗误解),系统判断是否先追问其健康素养与信念强度,再给出个性化纠正。
- 内容平台谣言干预助手:在评论或私信中自动识别不实健康信息,决策是否追问更多上下文,以提高辟谣说服力。
- 企业客服 / 金融咨询:面对复杂政策或风险解释,系统权衡用户理解水平与时间成本,减少无效追问。
商业价值
- 降低成本:实验中 RO-PnR 比 always-probe 基线少用约 30% 轮次,直接降低 token 消耗与推理延迟,提升会话吞吐。
- 提升体验与转化:通过按需澄清避免机械式追问,减少用户不耐烦;同时更精准的个性化回答提高信任与采纳率,有利于健康建议、理财产品等转化。
- 可迁移性强:奖励函数同时考虑信息增益与交互成本,框架不局限于健康领域,适合任何关心对话效率的业务。
与现有产品/工作流接口
RO-PnR 可作为对话策略层附加在现有 LLM 生成模块之上,无需替换底层模型。具体集成方式:
- LLM 或检索模块生成候选的提问与最终回答;
- RO-PnR 的决策网络根据当前对话状态与用户隐状态估计,输出
probe或respond动作; - 通过用户模拟器或历史日志离线训练决策策略,再在线部署时用轻量级模型(如小型分类头)做实时决策。
这一模块化设计适合渐进式落地:先用于 A/B 测试比较固定策略,再逐步用真实日志微调奖励模型。
局限
- 模拟用户与真实场景存在差距。RO-PnR 的训练与评估均依赖基于健康素养和信念承诺构建的潜在状态模拟器,但真实健康对话中用户行为受情绪、社会背景、对话长度、信任关系等更多因素影响。论文虽然在第 7 节进行了 LLM 模拟器评估与人工判断一致性验证,但样本规模有限,无法充分证明策略在真实部署中的有效性。从工程角度看,若将 RO-PnR 用于生产系统,需要更广泛的真实用户测试和在线学习机制来校准模拟偏差。
- 探询动作与成本建模过度简化。论文将探询动作限制为预定义类别(附录 B 提及 Probe Action Constraints),成本建模采用简化方案,例如固定单次交互成本,未考虑不同探询方式的信息增益差异、用户耐心随时间衰减、以及错误信息严重程度对成本的影响。这可能导致学到的策略在用户状态快速变化或高度情绪化的对话中过早终止探询或过度追问,鲁棒性不足。与端到端语言模型对话系统相比,RO-PnR 未联合优化生成文本的自然度与说服力,可能影响最终干预效果。
- 评估范围与基线设置相对有限。实验仅在三个健康错误信息数据集上进行,领域集中,未覆盖其他类型错误信息(如政治、金融)或跨语言场景。基座模型只有三个,对比基线主要是“立即响应”和“总是探询”两种极端策略,缺少基于规则的混合策略或更细粒度的学习型决策基线。这使 RO-PnR 的成本调整效用优势可能部分源于基线过于简单,而非策略本身的优越性,其跨领域、跨模型泛化能力仍需进一步验证。