Repo0: 设计驱动的从零到全代码生成
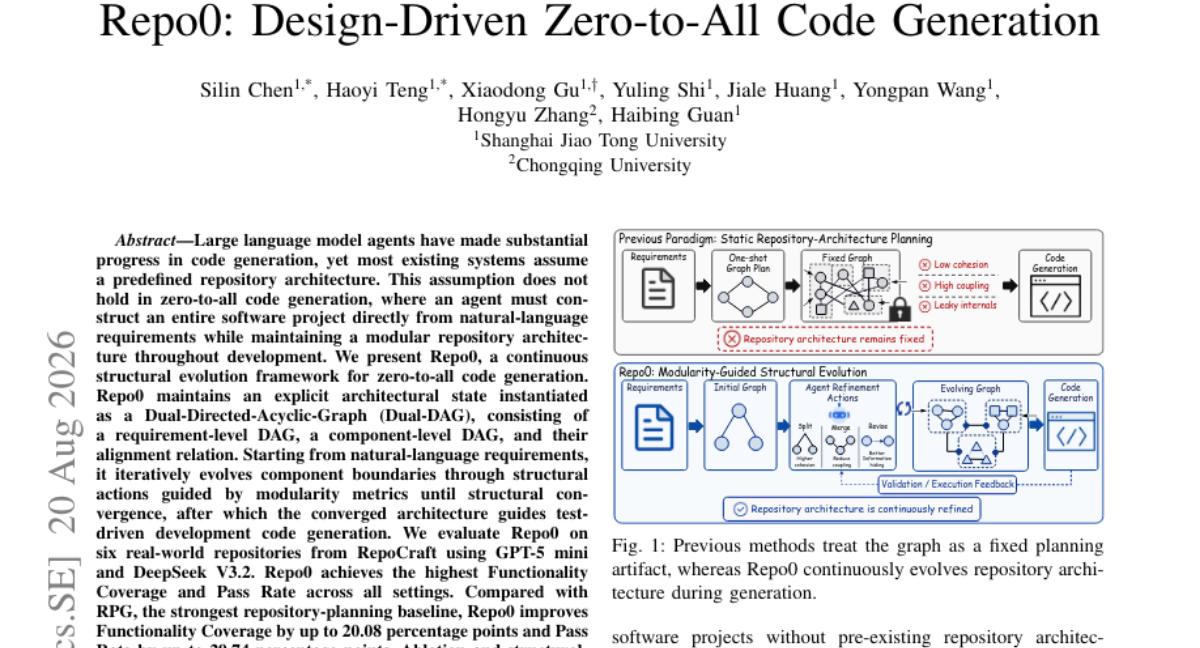
大语言模型智能体在代码生成上取得了显著进展,但多数现有系统预设了固定的仓库架构。这一假设在从零到全代码生成(zero-to-all code generation)场景中不成立——智能体必须直接从自然语言需求构建整个软件项目,并在开发过程中保持模块化的仓库架构。我们提出 Repo0,一个用于从零到全代码生成的连续结构演化框架。Repo0 维护一个显式的架构状态,实例化为双有向无环图(Dual-DAG),由需求级 DAG、组件级 DAG 及二者间的对齐关系组成。从自然语言需求出发,Repo0 通过受模块化度量引导的结构动作,迭代演化组件边界,直至结构收敛;随后,收敛的架构指导测试驱动开发的代码生成。 我们在 RepoCraft 的六个真实仓库上,使用 GPT-5 mini 和 DeepSeek V3.2 评估 Repo0。Repo0 在所有设置下均取得最高的功能覆盖率(Functionality Coverage)和通过率(Pass Rate)。与最强的仓库规划基线 RPG 相比,Repo0 的功能覆盖率提升最高达 20.08 个百分点,通过率提升最高达 29.74 个百分点。消融实验和结构演化分析进一步证明了 Dual-DAG 架构状态、模块化引导的结构演化以及显式结构收敛的重要性。
论文精读
TL;DR Repo0 用 Dual-DAG 显式建模需求与组件架构,通过模块化指标引导结构演化至收敛后再生成代码,在 RepoCraft 上功能覆盖率与通过率均大幅超越最强基线 RPG。
问题
问题背景
LLM 智能体在代码生成领域已能处理复杂代码片段和仓库级任务,如 issue 修复、测试生成等。然而,zero-to-all 代码生成——从自然语言需求直接构建完整软件仓库——成为新的挑战,要求智能体自主完成架构设计与模块划分。
现有方法局限
- 多数系统假设预定义仓库架构,即给定目录结构或组件边界后再填充实现,这无法适用于 zero-to-all 场景(初始只有需求文档)。
- 现有 repository planning 基线(如 RPG)虽能生成初始架构,但属于静态一次性规划,缺少后续的结构演化机制。
- 没有显式建模需求与组件的对齐关系,当模块划分不合理时无法自动调整,导致功能覆盖率与测试通过率受限。
为什么难/重要
- 技术挑战:需求分解与模块划分相互依赖,架构错误会在代码生成阶段被放大;需要持续评估模块化质量(如
responsibility cohesion、coupling、connectivity)并动态调整边界。 - 业界关注度:实现 zero-to-all 能显著缩短从需求到可运行软件原型的周期,对自动化软件开发、低代码平台和 AI 编程助手都有重要意义。
行业类比
类似于从产品需求文档自动生成微服务代码框架,若服务边界划分不当,后期集成将面临大量返工;Repo0 的持续结构演化思路相当于在编码前反复优化服务拆分方案。
核心洞察
- Repo0 将软件架构显式建模为需求级 DAG 与组件级 DAG 对齐的双图结构,并作为持续演化的状态。与大多数方法依赖隐式上下文或一次性规划不同,该双图明确分离需求分解与组件边界,允许在生成过程中连续调整架构直到结构收敛,从而应对 zero-to-all 场景中架构从无到有的不确定性。
- Repo0 通过模块化度量(内聚、耦合、连接性等)量化架构质量,并指导结构性动作。这让架构演化从依靠 LLM 启发式判断变为可度量、可优化的过程;相比 RPG 等 baseline 仅做一次性仓库规划,Repo0 的迭代演化确保最终架构具有高模块化,为后续测试驱动代码生成提供稳定边界,因此显著提升功能覆盖率与通过率。
方法
输入与需求分解
Repo0 接收自然语言需求作为唯一输入。Phase I 将需求分解为 requirement-level DAG:节点为原子化需求,边表示需求间的依赖与层次关系;同时生成初始 component-level DAG,以粗粒度划分模块,并通过 alignment relation 将需求节点映射到组件节点,形成 Dual-DAG 初始状态。
Dual-DAG 与结构演化循环
Dual-DAG 是显式架构状态,由 requirement-level DAG、component-level DAG 和二者对齐关系构成。Phase II 循环中,Repo0 计算多项模块化度量:Responsibility(单一职责)、Cohesion(高内聚)、Coupling(低耦合)、Connectivity(依赖连通性)。基于这些度量,LLM 执行结构化动作(如拆分组件、合并组件、移动需求-组件映射),迭代更新 component-level DAG 与对齐关系,直到结构收敛——连续多次迭代度量变化低于阈值。
代码生成与差异点
收敛后的 Dual-DAG 作为固定架构蓝图,进入 Phase III:采用 测试驱动开发(TDD)生成代码,先根据需求节点生成测试用例,再实现满足测试的组件代码,最后整合为完整仓库。
与 RPG 等仓库规划基线不同,Repo0 不依赖一次性架构规划,而是通过显式 Dual-DAG 状态和模块化度量驱动的持续结构演化实现设计驱动的零到全代码生成。
实验
实验设计
Repo0 在 RepoCraft 的六个真实仓库上评估,使用 GPT-5 mini 与 DeepSeek V3.2 作为 agent LLM。核心指标为 Functionality Coverage 和 Pass Rate,与 RPG 等仓库规划基线对比。消融分析验证 Dual-DAG 架构状态、模块度引导的结构演化及显式收敛的作用。
关键发现
Repo0 在所有设置中取得最高 Functionality Coverage 和 Pass Rate。相较最强基线 RPG,Functionality Coverage 最高提升 20.08 pp,Pass Rate 最高提升 29.74 pp。结构演化分析表明模块度指标能稳定引导组件边界收敛,避免过早编码导致架构劣化。这提示工程中显式维护架构状态并动态调整组件划分,比一次性规划更适配零到全代码生成。
与基线对比
RPG 等假设固定仓库结构,而 Repo0 采用 Dual-DAG 显式表示需求与组件两层图及对齐关系,并通过模块度驱动的结构动作迭代演化。差异在于:Repo0 在进入 TDD 编码前先实现结构收敛,降低后期重构成本。实际工程可借鉴这种“先收敛架构,再驱动测试”的流水线,减少 LLM 盲目生成造成的模块耦合。
行业影响
落地场景
Repo0 适用于需要从自然语言需求直接生成完整可维护代码仓库的场景,如低代码/无代码平台、企业内部工具自动生成、MVP 快速验证、遗留系统模块化重构。其 Dual-DAG 架构状态和模块化收敛机制,特别适合中大型、需长期演化的项目,而非一次性脚本。
商业价值
主要切入降本与提效线。通过自动化架构设计与测试驱动开发,大幅减少人工模块拆分、初始架构和代码编写的人力投入,缩短项目交付周期。生成代码附带测试用例,提高 Functionality Coverage 和 Pass Rate,降低后期缺陷修复成本,提升代码可维护性。对软件外包、企业数字化服务等业务,可直接扩大交付吞吐并改善客户验收体验。
与现有产品/工作流的接口
可将 Repo0 作为插件集成到 VS Code 等 IDE 或 AI 编程助手,从需求文档一键生成仓库骨架与测试。与 CI/CD 流水线 结合,在提交前自动运行模块化度量与结构收敛检查,作为质量门禁。输出架构可映射到 Spring Boot、FastAPI 等主流框架,便于人工接管后续开发。
具体落地 use case
- 电商平台:输入商品、订单、库存等业务需求,自动生成多个服务模块、接口契约及单元测试,快速搭建微服务基础架构。
- 金融合规系统:从监管规则文档生成规则引擎组件和对应测试用例,辅助合规审计流程自动化,减少人工规则梳理误差。
局限
- - **评估规模与多样性有限**:论文仅在 **RepoCraft** 的六个真实仓库上,使用 **GPT-5 mini** 和 **DeepSeek V3.2** 两个模型进行实验。样本量偏小,且未覆盖多语言、多编程范式或更大规模的工业级 monorepo,结论的统计稳健性与泛化边界有待在更多基准(如 **SWE-bench** 风格或企业级代码库)上进一步验证。
- - **对 LLM 结构决策的依赖与成本风险**:**Dual-DAG** 的构建与 **modularity-guided structural evolution** 需要 LLM 在每轮执行结构动作(拆分 / 合并 / 重连)并反复计算模块化指标,token 消耗与迭代轮数可能显著高于一次性规划方法。论文虽包含 **Cost Analysis**,但未与轻量级启发式结构生成做严格对比,在大规模仓库或多需求任务中可能面临较高推理成本与收敛不稳定。
- - **需求到架构对齐的脆弱性**:**requirement-level DAG** 与 **component-level DAG** 的对齐依赖初始需求分解质量,若需求含糊、存在隐含依赖或跨功能复用关系,LLM 可能错误划分组件边界,导致后续 **test-driven development** 生成偏离真实意图。此外,测试驱动的收敛仅验证测试通过率,可能掩盖架构合理性不足或可维护性问题,缺乏耦合、内聚、技术债务等更多软件工程指标的持续追踪。