GS-Voxel:面向大规模 3DGS 生成的无拟合结构化潜变量
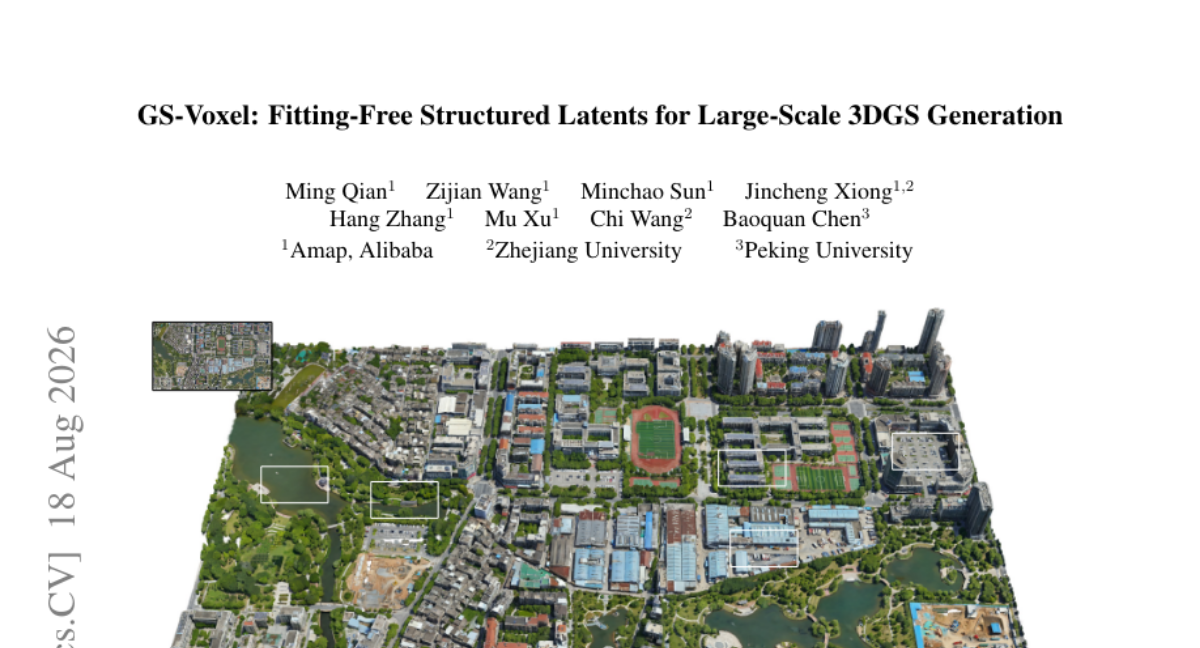
许多可扩展的潜在 3D 生成器基于结构化张量,而预优化的 3D Gaussian Splatting(3DGS) 重建结果则是无序、空间不规则且原始数量差异巨大的。为此,我们提出 GS-Voxel,一种无拟合的结构化潜变量框架,并针对大规模航拍 3D 高斯场景生成进行评估。 GS-Voxel 确定性地将兼容的预优化 3DGS 重建转换为稀疏激活体素,无需额外的逐场景优化,同时保留所选原始体的亚体素位置和渲染属性。一个 GS 专用因子分解 VAE 分别将体素几何和局部高斯属性编码为稀疏 3D 潜变量,其大小随占据体素数增长,而非受限于固定的场景级原始数量。我们在 GS-Voxel 潜空间中训练图像条件流模型,以生成航拍 3DGS 场景。 GS-Voxel 支持的关键应用是大面积场景生成:重叠感知的分块推理 可在单个训练裁剪之外扩展合成,并受卫星视图图像条件约束。实验结果表明,GS-Voxel 为预优化的航拍 3DGS 重建提供了结构化潜变量,其潜容量随占据体素数增长。
论文精读
TL;DR GS-Voxel 将预优化 3DGS 重建转为稀疏体素结构化潜在,无需额外拟合且保留子体素细节,潜在容量随占用体素自适应增长,使 flow 模型能生成大规模航空 3D 场景并支持重叠感知分块推理。
问题
问题背景
大规模室外 3D 场景生成是当前 3D 生成模型的重要方向,尤其面向航空视角的场景重建与合成,业界关注如何将可扩展的潜在生成范式从对象级扩展到真实世界大场景。
现有方法局限
现有可扩展的潜在 3D 生成器通常运行在结构化张量(如体素网格、三平面)上,但预优化的 3D Gaussian Splatting (3DGS) 重建结果是无序、空间不规则的,且不同场景的高斯图元数量差异很大。将 3DGS 强行对齐到固定大小的结构化张量需要额外的逐场景拟合步骤(例如优化或重参数化),这会引入信息损失或显著增加计算成本;或者采用固定最大图元数,限制了场景的表达能力。
为什么这个问题难/重要
3DGS 能保留逼真外观,但其非结构化特性与扩散/流模型所依赖的规则潜在空间不兼容。设计一种无需拟合 即可将任意预优化 3DGS 确定性映射到结构化潜在表示的方法,同时保持稀疏性和可扩展性,是核心技术挑战。在航空场景大区域生成中,还必须处理可变尺寸的输入以及重叠区域的拼接推理,这对潜在容量和推理机制提出更高要求。
行业类比
类似将变长序列映射到固定长度 embedding 时的对齐难题:传统方法需要截断或填充,而 GS-Voxel 提供了一种自适应稀疏表示,可按需扩展潜在容量,适用于自动驾驶仿真、数字孪生等需要大规模场景合成与扩展的应用。
核心洞察
- GS-Voxel 的核心是 fitting-free 结构化 latent 转换,将预优化 3DGS 重建确定性地转为 sparse active voxels,无需 per-scene optimization。这解决了 scalable latent 3D 生成器中结构化张量假设与原始 3DGS 无序、空间不规则、primitive count 差异大的矛盾。与固定场景级 primitive count 或需要额外 fitting 的方法相比,GS-Voxel 保留 sub-voxel 位置和渲染属性,latent 容量随 occupied voxels 增长,真正适配大规模场景生成。
- 因子化 VAE 将 voxel geometry 与 local Gaussian attributes 分开编码,产生 sparse 3D latents,尺寸与 occupied voxels 数量一致,而非受限于 fixed scene-wide primitive count。这种设计使表征能适应不同尺度与稀疏度,避免大场景中因固定 latent 容量导致的信息瓶颈,同时维持渲染保真度。配合 satellite-view 条件下的 overlap-aware tiled inference,生成可扩展至单一训练 crop 之外,实现 large-area aerial scene 合成,是 3DGS 生成从 object-level 走向 scene-level 的关键一步。
方法
输入与整体流程
GS-Voxel 接收两类输入:预优化 3DGS 重建(无序、空间不规则、原语数量变化大)与单张卫星视角图像作为生成条件。核心思路是将非结构化高斯原语转换为结构化的稀疏 3D latent,再用于可扩展的生成建模。
关键模块
- GS-Voxel 构建:对兼容的预优化 3DGS 进行确定性转换,将场景划分为稀疏激活体素,仅保留体素内选中的高斯原语及其亚体素位置与渲染属性。该过程无需 per-scene 优化或额外拟合,体素数随占用体素数量动态增长,而非受限于固定的场景级原语上限。
- 两阶段 Factorized VAE:将体素几何与局部高斯属性分开编码。
Geometry VAE编码体素占用/结构信息,Local Attribute VAE编码每个体素内局部高斯的属性(受超参K_out控制),两者输出合并为稀疏 3D latents。解耦设计使潜空间更紧凑且可扩展。 - 生成模型:在 GS-Voxel latent space 上训练 image-conditioned flow models,以卫星图为条件直接生成潜码,再解码为 3DGS 场景。
- 大区域生成:采用 overlap-aware tiled inference,在重叠区域进行 tile 遍历与接缝消减,将生成从单一训练 crop 扩展到更大地理范围。
与同类方法差异
相比需固定张量结构或迭代优化拟合 3DGS 的方法(如 XCube、SkyFall-GS),GS-Voxel 无需拟合,latent 容量随占用体素自适应增长,更适合大规模非均匀户外场景生成。
实验
实验设计
GS-Voxel 的实验围绕 fiting-free structured latents 展开,首先将预优化的 3DGS 重建转换为稀疏 active voxels,再通过 两阶段 factorized VAE 分别编码几何与局部 Gaussian 属性,最后训练 image-conditioned flow model 在 latent space 中生成 aerial 3DGS 场景。训练数据构造包含 tile 生成、voxel 过滤、虚拟相机设置与 VLM-based view filtering,并利用 overlap-aware tiled inference 扩展大规模场景生成。
关键发现
- GS-Voxel 无需额外逐场景优化,确定性转换保留子体素位置与渲染属性,潜在大小随占用体素数量增长,突破固定 primitive count 限制。
- 因子化 VAE 分离几何与属性编码,提升稀疏 3D latent 的表达效率。
- 在单一 satellite-view 图像条件下,flow model 能够生成可扩展的 aerial 3DGS 场景,并支持大区域拼合。
基线对比
相比表 1 中的代表性方法(如 Sat2Scene、Sat2City、Sat3DGen、SkyFall-GS、EarthCrafter 等),GS-Voxel 的核心差异在于:
- 表示模态:直接作用于预优化 3DGS,而非 mesh 或隐式场。
- 条件输入:仅需单张卫星视角图像,无需 LiDAR 或多视角。
- 生成范式:采用 3D generative latent 而非迭代优化或多阶段构建,fitting-free 特性使流程更简洁且具扩展性。
行业影响
落地场景
GS-Voxel 可直接服务于需要大规模 3D 场景生成的业务,例如自动驾驶仿真、游戏开放世界构建、影视预演与地理信息可视化。典型 use case:
- 自动驾驶仿真:基于卫星视图条件,生成大范围高保真 3DGS 场景,用于感知模型训练与 corner case 测试,替代昂贵的人工建模。
- 内容平台 / 游戏引擎:为沙盒游戏或虚拟地产提供从卫星图一键生成可交互城市场景的能力,加速 UGC 地图创作。
商业价值
核心价值在降本与可扩展性:
- 免拟合转换(fitting-free)消除了逐场景优化开销,使预优化 3DGS 资产可快速进入生成式工作流。
- 潜空间大小随占用体素数增长,支持任意规模场景,避免固定长度瓶颈;重叠感知 tiled inference 能将单块训练模型泛化到整个区域,降低大规模生成的硬件门槛。
- 对于自动驾驶数据提供商,合成场景可大幅降低实车数据采集与标注成本,同时提升数据多样性。
与现有产品 / 工作流的接口
- 与 3DGS 渲染管线:将预优化 3DGS 经
GS-Voxel编码为稀疏潜变量,生成模型输出潜在后解码并直接接入现有 Gaussian Splatting 渲染器,无需改动渲染层。 - 与 GIS / 地图平台:条件输入为卫星视图,天然兼容卫星影像 API,适合作为地理空间数据平台(如 ArcGIS、Cesium)的生成扩展模块。
- 分布式生成:重叠感知分块推理支持拆分到多个 GPU 节点并行生成,适合云渲染或在线内容生产服务。
局限
- - **重叠感知分块推理** 虽然在单瓦片生成基础上实现了大区域扩展,但论文没有提供全局一致性的定量指标,只展示了视觉结果。不同瓦片之间的接缝处理依赖重叠区域平均,可能引入模糊或几何错位,尤其当相邻瓦片内容差异较大或条件图像存在强烈光照变化时。此外,分块遍历顺序固定,无法根据内容动态调整,可能累计误差,在超大范围生成时出现漂移。
- - **GS-Voxel 转换的参数选择**(如 `K_in` 和 `R`)对最终表示有直接影响:体素分辨率过低会丢失细节,过高则增加稀疏性但降低学习效率。论文的消融实验只考察了有限组合,缺乏对不同场景密度、不同重建质量的系统性鲁棒性分析。而且转换过程依赖预优化 3DGS 重建,如果输入重建本身存在伪影或不完整,这些缺陷会被保留并被 VAE 编码,导致生成结果继承错误。
- - **方法只针对航拍大尺度室外场景** 进行了验证,使用的训练数据为卫星视图和对应 3DGS 重建,模型是否适用于室内场景、街景或动态物体尚未可知。分解式 VAE 将几何和外观属性分开编码,虽然提高了结构化程度,但也割裂了二者在渲染中的耦合关系,可能导致局部颜色与几何不匹配,尤其在复杂材质或反射表面上。与同时支持多类场景的通用 3D 生成模型相比,应用范围偏窄。