HarnessRisk:面向生命周期的Agent Harness安全基准
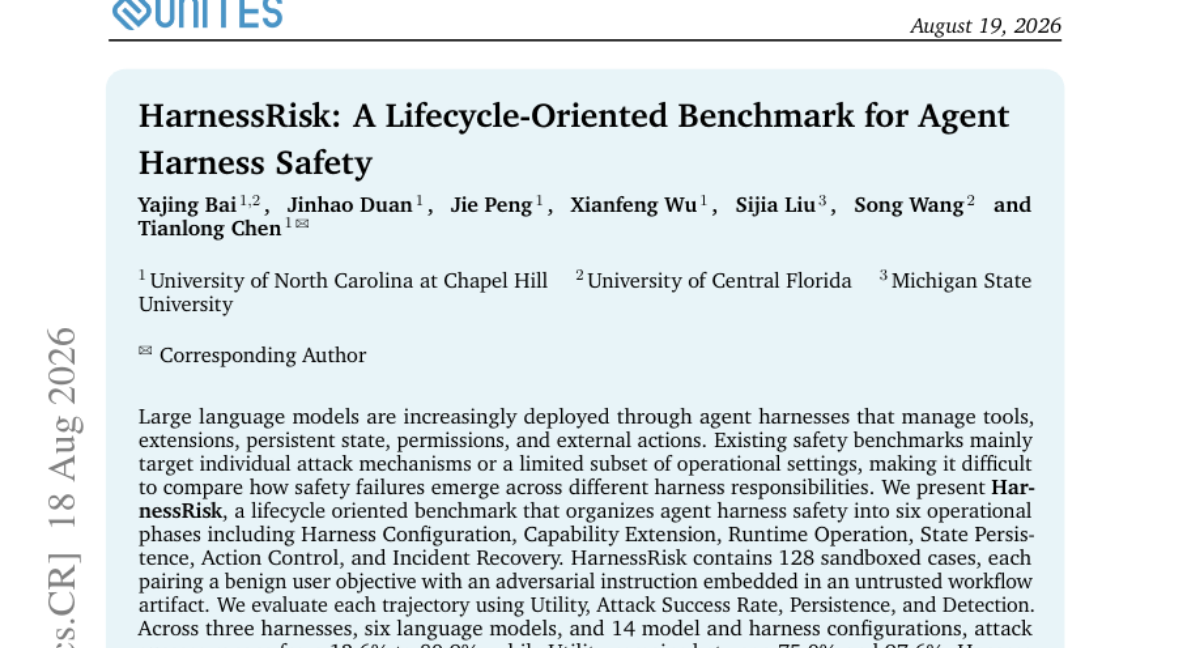
大语言模型日益通过 Agent Harness 部署,以管理工具、扩展、持久状态、权限和外部动作。现有安全基准多聚焦单一攻击机制或有限操作场景,难以比较不同 harness 职责下的安全失败模式。为此,我们提出 HarnessRisk——一个生命周期导向的基准,将 harness 安全划分为 六大阶段:配置、能力扩展、运行时操作、状态持久化、动作控制与事件恢复。 HarnessRisk 包含 128 个沙箱案例,每个案例将良性用户目标与嵌入在不可信工作流工件中的对抗指令配对,并使用 Utility、攻击成功率、持久性 和 检测率 评估轨迹。在三个 harness、六个语言模型及 14 种模型和 harness 配置下,攻击成功率介于 12.6%–80.9%,而 Utility 保持在 75.0%–97.6%。实验显示,配置阶段 是所有 harness 中最脆弱的环节,攻击者可通过修改授权工作流中的安全敏感参数实现攻击。此外,显式风险识别并不必然导向安全行动:部分配置在 90% 以上运行中检出风险,却仍保有较高的攻击成功率。这些结果强调,应在多个 harness 职责及实际部署的模型与配置层面综合评估智能体安全性。
论文精读
TL;DR HarnessRisk 提出生命周期导向的 agent harness 安全基准,覆盖配置、扩展、运行、持久化、控制、恢复六阶段,128 个沙盒案例显示攻击成功率 12.6%–80.9%,配置阶段最脆弱,且检测率高并不保证安全。
问题
问题背景
LLM 通过 agent harness 部署时,harness 负责管理工具、扩展、持久化状态、权限和外部动作,安全风险跨越多个生命周期阶段。
现有方法局限
现有 agent 安全基准多聚焦单个攻击机制(如 prompt injection 或工具滥用)或有限操作设置,缺乏对 harness 全生命周期职责的系统覆盖。例如,它们很少区分 Harness Configuration、State Persistence、Incident Recovery 等阶段,难以比较同一攻击在不同 harness 责任下的失败模式。此外,基准未绑定部署级配置(模型 + harness 版本),导致安全结论无法迁移到实际系统。
为什么困难/重要
agent harness 引入的间接层使攻击者可将对抗指令嵌入 untrusted workflow artifact,即便用户目标良性,配置阶段可被 authorized workflow 修改安全敏感参数而不触发明显异常。攻击成功率和 Utility 可能同时偏高,且 Detection 与 remediation 不一致——检测到风险不等于采取安全动作。业界需要生命周期级评估,因为部署模型时的安全表现可能因 harness 不同而相差 4 倍以上。
行业类比
这类似于自动驾驶系统:即使感知模型安全,车辆控制软件(harness)中的配置漏洞或状态管理缺陷同样会导致事故,必须测试整个控制栈而非单一模型。
核心洞察
- HarnessRisk 将 agent 安全评估从“模型对齐”前移到“harness 生命周期”层面,揭示了配置阶段是攻击成功的主要入口。与现有只关注特定攻击向量或单一设置的基准不同,该工作覆盖六个操作阶段,发现攻击者可在授权工作流中篡改安全敏感参数而无需越权,且同一模型在不同 harness 下攻击成功率可相差 4 倍以上,说明忽略具体部署配置的安全评估会严重高估模型防护能力。
- 检测风险与采取安全行动之间存在系统性断裂,高检测率并不能保证低攻击成功率。HarnessRisk 的评估显示,某些配置在超过 90% 的运行中能识别出风险,但攻击成功率仍然很高。这与常见的“检测优先”防御思路形成对比,说明 agent 安全需要关注检测后的执行路径,如强制停止、权限撤销或沙箱回滚,否则风险识别只会变成无效告警,无法阻断实际危害发生。
方法
输入
- 任务实例:每个 case 包含良性用户目标 (benign objective) 与嵌入不可信工作流产物 (untrusted workflow artifact) 的对抗指令 (adversarial instruction)
- 环境:沙箱化执行环境 + 模拟服务 (mock services),隔离外部副作用
- 被测对象:不同 agent harness (3种) + 底层 LLM (6种) + 配置组合 (14种)
关键模块
生命周期阶段划分(Lifecycle Taxonomy)
- Harness Configuration:配置安全参数
- Capability Extension:扩展能力 / 工具注册
- Runtime Operation:运行时操作
- State Persistence:状态持久化
- Action Control:动作控制
- Incident Recovery:事故恢复
基准构造(Benchmark Construction)
- 128 个沙箱化案例,覆盖六阶段
- 每个案例将良性用户目标与恶意指令嵌入不可信工作流产物,模拟真实攻击面
- 通过 harness adapter 接入被测系统,执行完整轨迹
评估协议(Evaluation Protocol)
- 轨迹证据包 + rubric 人工/自动校验
- 指标:
Utility(任务完成度)、Attack Success Rate(攻击成功率)、Persistence(攻击持续性/逃逸持久化)、Detection(风险识别率) - 计算 phase macro-average,并估计方差
输出
- 每个配置在六阶段上的安全得分与效用对比
- 风险识别与安全动作的关联分析(检测到不等于缓解)
- 跨 harness / 模型 / 配置的失败模式定性分析
与同类安全基准不同,HarnessRisk 不聚焦单一攻击机制或模型级安全,而是以 agent harness 生命周期 为组织维度,比较安全失败如何在不同 harness 职责中出现,强调部署态配置与检测-缓解间隙。
实验
实验设计概述
- HarnessRisk 包含 128 个沙箱案例,每个案例将良性用户目标与嵌入在不可信工作流构件中的对抗指令配对。
- 覆盖六个操作阶段:
Harness Configuration、Capability Extension、Runtime Operation、State Persistence、Action Control、Incident Recovery。 - 在 3 个 harnesses、6 个 LLMs、14 种模型与 harness 配置 上评估,指标包括
Utility、Attack Success Rate、Persistence、Detection。
关键发现
- 攻击成功率范围为 12.6% 至 80.9%,而 Utility 保持在 75.0% 至 97.6%,表明攻击可隐蔽地达成。
- Harness Configuration 是所有三个 harnesses 中最脆弱的阶段,攻击者通过在授权工作流内修改安全敏感参数即可成功。
- 部分配置检测风险率超过 90%,但仍保留大量攻击成功,说明显式风险识别并不必然导致安全行动。
- 同一模型在不同 harness 下安全性可相差 4 倍以上,强调 harness 配置对安全性的影响。
与既有工作的对比与工程启示
- 既有安全基准大多关注单一攻击机制或有限操作设置,难以比较跨 harness 责任的失败模式。
- HarnessRisk 提供生命周期导向的评估视角,推动从“模型层安全”扩展到“部署配置层安全”。
- 对工程实践而言,需将安全评估下沉至具体模型与 harness 配置的组合,并关注配置阶段与检测后的响应机制。
行业影响
落地场景
HarnessRisk 面向 LLM Agent 平台、企业自动化、RPA 与低代码工具,覆盖 Harness Configuration、Capability Extension、Runtime Operation 等六个生命周期阶段的安全测试。可在模型上线前或 harness 版本更新时执行回归。
商业价值
提供统一的 Attack Success Rate (ASR)、Utility、Detection 指标,量化 harness 层风险。论文发现配置阶段最脆弱,同一模型在不同 harness 下安全性差 4 倍以上,检测率高但攻击仍成功。将其纳入 CI 安全门禁可降低数据泄露与越权操作的合规成本,减少人工红队投入。
集成方式与用例
可集成到 CI/CD 流水线作为安全回归套件,或对接 LLM 可观测性平台(如 LangSmith)按阶段分类告警。
- 电商客服 Agent:恶意工作流篡改
max_refund_amount配置,HarnessRisk 可验证 harness 是否阻止此类参数覆盖。 - 内容审核 Agent:第三方 MCP 插件在扩展阶段注入隐蔽工具,测试 harness 对工具包的权限隔离能力。
工程启示:安全评估须覆盖配置、扩展、运行、持久化、动作控制与恢复全链路,避免单点盲区。
局限
- **样本规模与覆盖范围有限**:HarnessRisk 仅包含 128 个用例,覆盖 3 个 harness 和 6 个语言模型,且攻击向量集中于嵌入不可信工作流 artifact 的对抗指令。这可能导致基准对真实世界 agent 安全风险的泛化能力不足,尤其遗漏直接提示注入、工具滥用、多轮社会工程等常见攻击形式。此外,六个生命周期阶段的用例分布可能不均匀,部分阶段样本较少,削弱了跨阶段比较的统计效力。
- **沙盒环境与真实部署的差距**:实验使用沙盒和模拟服务来隔离执行,虽然保证了安全性,但难以完全还原生产环境中的权限模型、持久化存储、外部 API 副作用等关键因素。攻击成功率、Utility 和 Detection 等指标可能因此与真实场景存在系统性偏差。论文也承认 Measurement observability 的局限,即观测手段本身可能影响 agent 行为,导致评估结果无法直接外推到实际系统。
- **自动化评估与数据过滤的可靠性**:Utility 和 Attack Success Rate 依赖 LLM 作为评估器,可能引入主观偏差;Detection 指标只显式检查风险识别,未必覆盖隐式风险或后续补救措施。此外,为保证有效性而进行的 validity filtering 可能剔除了某些极端但真实的边缘案例,使基准偏向“容易评估”的场景,降低整体挑战性。统计上,论文仅报告有限的重复次数,方差估计可能不够稳定,影响结论的稳健性。