Agent Lightning v1.0: 迈向受控的智能体强化学习
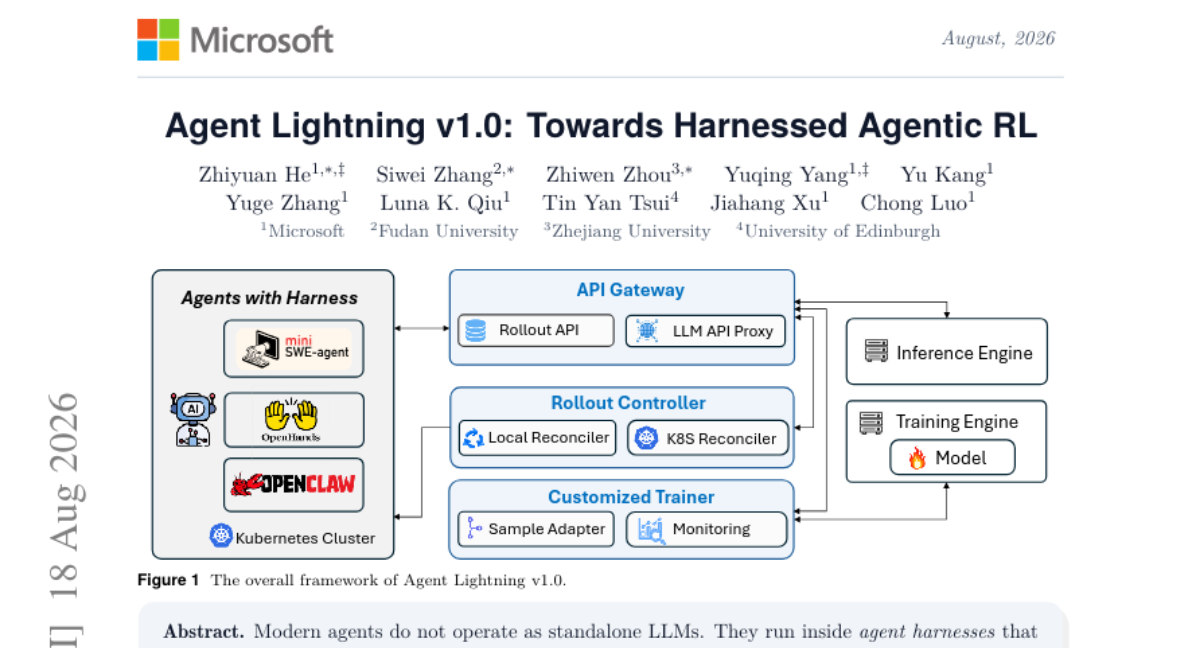
现代智能体运行在agent harness(智能体外壳)中,该外壳负责管理工具、上下文和控制流,因此外壳成为智能体系统的关键部分。我们最初的 Agent Lightning 提出了一种解耦架构,通过 LLM endpoint 代理将任意智能体连接到强化学习训练,这一方法后来被 verl Uni-Agent、AReaL 2.0、slime 和 Polar 等框架采用。我们将这种范式称为受控智能体强化学习(harnessed agentic RL),其中部署时的外壳直接参与模型后训练。 受控智能体强化学习与传统智能体强化学习有本质区别:外壳而非训练引擎拥有环境交互循环,而训练器仅观察 LLM 请求-响应对序列。这引入了重新分词、样本合并、优势计算、损失归一化和后端调度等挑战,可能显著影响训练稳定性和有效性。我们提出了 Agent Lightning v1.0,一个以约 3500 行代码实现的轻量级框架,支持任意智能体外壳,并作为研究这些挑战的实用测试平台。 我们在指令跟随、搜索和编码智能体上进行了评估,并提供了编码智能体强化学习的完整可复现流程。仅使用 6K 训练示例和适度的计算资源,强化学习将 Qwen3.5-9B 在 SWE-bench Verified 上的性能从 41.8% 提升至 56.4%,绝对提升 14.6 个百分点。我们发布了完整的工作流和训练脚本,以促进受控智能体强化学习的可复现研究。
论文精读
TL;DR Agent Lightning v1.0 提出 harnessed agentic RL 范式,通过 LLM 端点代理让任意 agent harness 直接参与 RL 训练,并解决重分词、优势计算等关键挑战;用 6K 样本将 Qwen3.5-9B 在 SWE-bench Verified 上从 41.8% 提升至 56.4%。
问题
问题背景
现代 agent 运行在 agent harness 中,由 harness 管理工具调用、上下文与控制流,模型性能与 harness 协同紧密。如何将 RL 训练直接接入真实部署 harness,成为 agentic RL 的核心议题。
现有方法局限
传统 agentic RL 中训练引擎拥有环境交互循环,需要把工具、环境、控制逻辑重新实现进训练器,无法直接复用生产 harness,造成训练-部署 gap。原始 Agent Lightning 及后续框架(如 verl Uni-Agent、AReaL 2.0、slime、Polar)采用 LLM endpoint proxy 架构,让任意 harness 参与 RL,但仅解决连接问题,未系统处理 harness 拥有循环后引发的训练挑战:retokenization、sample merging、advantage calculation、loss normalization、backend scheduling。若处理不当,训练会不稳定或完全失效。
为什么这个问题难/重要
在 harnessed agentic RL 中,训练引擎只能观测到乱序的 LLM request-response 序列,必须从序列重建轨迹、对齐 token 边界、归一化损失、计算优势,并调度异步后端。不同 harness 的调用模式、缓存与网络行为都会影响 token 连续性,进而干扰梯度估计。业界多个 RL 框架已转向 proxy 范式,说明该方向被广泛关注,但缺乏统一测试床与可复现 pipeline,尤其是小数据、低算力条件下的稳定训练方案。
行业类比
这类似于将生产环境的微服务编排直接用于模型训练,而非在训练沙箱中重写一套简化逻辑;关键挑战在于解决观测与控制的阻抗匹配,才能让 RL 在真实 agent 系统中稳定收敛。
核心洞察
- 将 deploy-time harness 直接纳入 RL 训练循环,使训练优化目标与真实部署环境一致,避免了传统 agentic RL 中训练环境与部署环境不一致导致的性能退化。与传统方法不同,训练引擎不再控制环境交互循环,而是通过 LLM endpoint proxy 观察请求-响应对,这种范式转变要求重新设计 token 化、样本组装和优势计算,是 harnessed agentic RL 的核心难点。该视角将训练与部署的对齐从模型层面扩展到系统层面,为 agent RL 的工程实践提供了新方向。
- 论文识别并解决了 harnessed agentic RL 中的 token-prefix continuity 问题:由于 harness 可能插入或删除 token,导致训练样本的 token 序列不连续,进而引发 loss 计算错误和梯度噪声。Agent Lightning v1.0 通过 retokenization 和 sample merging 恢复连续性,并针对不同 loss 归一化策略和优势计算方式进行了系统性实验,发现不恰当的处理会导致训练不稳定或无效。这为实践者提供了明确的工程指导,避免了在复杂 harness 下进行 RL 训练时的常见陷阱。
- 尽管 harnessed agentic RL 引入了额外的系统复杂性,但 Agent Lightning v1.0 用约 3500 行代码实现了与多种 agent harness 的兼容,并在仅 6K 训练样本和适度算力下将 Qwen3.5-9B 在 SWE-bench Verified 上的解决率从 41.8% 提升至 56.4%(+14.6 点),证明了这种范式在小规模数据下依然高效。该结果不仅展示了 harnessed agentic RL 的实用性,还提供了完整可复现的 pipeline 和训练脚本,为后续研究建立了可靠的 baseline。
方法
Agent Lightning v1.0 以 harnessed agentic RL 为核心范式:部署时 agent harness 拥有环境交互循环,训练引擎仅观察由 harness 发出的 LLM request-response 序列。其方法可分解为:
输入:任意 agent harness 产生的原始交互轨迹,包含工具调用、上下文管理与控制流切换。
关键模块:
- API Gateway:提供幂等端点与重复调用去重,解决网络重试引发的状态不一致。
- Rollout Controller:支持 Kubernetes 与本地 reconciler,保证 rollout 生命周期与状态同步。
- Customized Trainer:内置 sample adapter,对 request-response 序列执行 retokenization、sample merging、advantage calculation 与 loss normalization,从而将碎片化调用组装为可训练样本。
- Collocated Async RL:将 rollout 与训练进程同节点部署,降低通信成本并简化 backend scheduling。
输出:完成 RL 更新后的策略模型,可直接用于相同 harness 下的部署。
与同类 proxy-based 框架(如 verl Uni-Agent、AReaL 2.0、slime、Polar)相比,Agent Lightning v1.0 以约 3,500 行轻量实现聚焦于训练稳定性问题的系统研究,并提供了 coding-agent RL 的完整可复现流程。
实验
实验设计
Agent Lightning v1.0 在 harnessed agentic RL 框架下对三类代理进行评估:通用指令跟随、搜索与编码代理。其中编码代理提供了完整可复现流水线,使用 Qwen3.5-9B 模型,仅 6K 训练样本,在 SWE-bench Verified 上进行 RL 训练。训练通过 LLM endpoint proxy 连接部署期 harness 与训练引擎,重点处理重token化、样本合并、优势计算与损失归一化等挑战。
关键发现
RL 训练后,Qwen3.5-9B 在 SWE-bench Verified 上得分从 41.8% 提升至 56.4%,绝对提升 14.6 个百分点。仅 6K 样本和 modest compute 即带来显著提升,表明 harnessed agentic RL 能高效利用代理交互数据。论文同时指出,若未妥善处理重token化、优势计算与损失归一化,训练可能不稳定甚至失效。
与基线对比
基线为未 RL 的 Qwen3.5-9B,得分 41.8%。传统 agentic RL 由训练引擎主导环境交互,而 harnessed RL 让部署时的 harness 直接参与训练,缩小训练与真实使用差异,使提升更贴合实际场景。轻量实现(约 3500 行代码)及开源工作流进一步降低了复现门槛。
行业影响
落地场景
- 企业级编码助手:通过 harnessed RL 优化 agent 在代码库检索、单元测试、多轮修复等工具调用,直接提升 SWE-bench 类任务表现。
- 电商智能客服:客服 agent 需调用订单查询、退款、物流等多个 API,harnessed RL 让训练环境与部署完全一致,避免 sim-to-real gap。
商业价值
- 降本:仅需 6K 条训练样本,即可将 Qwen3.5-9B 在 SWE-bench Verified 上从 41.8% 提升至 56.4%,大幅降低数据采集与标注成本。
- 提效:轻量框架约 3,500 行代码,降低集成复杂度;训练即部署,缩短模型上线周期。
- 体验提升:针对复杂多步任务,RL 优化后的 agent 更稳定、更符合业务目标。
与现有工作流集成
- 通过 LLM endpoint proxy 将任意 agent harness 接入训练,无需重构 production 代码。
- 支持 Kubernetes 与本地环境,可方便嵌入现有 MLOps 流水线;提供 idempotent API gateway、deduplication 机制,保证训练可靠性。
- 可与 vLLM、SGLang 等推理引擎及 Ray 等分布式框架协同,复用已有基础设施。
局限
- 论文主要在一个中等规模模型(Qwen3.5-9B)和三个特定任务(指令跟随、搜索、编码)上验证,缺乏更大模型(如70B+)和更广泛 agent 环境(如计算机操作、多步工具调用等)的评估,因此 harnessed agentic RL 的泛化性和扩展性仍有待检验。
- 框架虽然轻量(约3500行),但功能上可能不如已有的强化学习训练框架(如 verl、OpenRLHF)成熟,对分布式训练、多智能体协作、复杂 rollout 管理等支持有限,可能限制其在生产环境中的直接应用。
- 论文重点在于系统设计和实践,对于 retokenization、advantage calculation 等挑战的理论分析相对不足,缺乏严格的数学证明或消融实验量化各部分对训练稳定性的贡献,使得方法的通用性说服力打折扣。