TRACE-Bench:多参考图像生成的分解与诊断
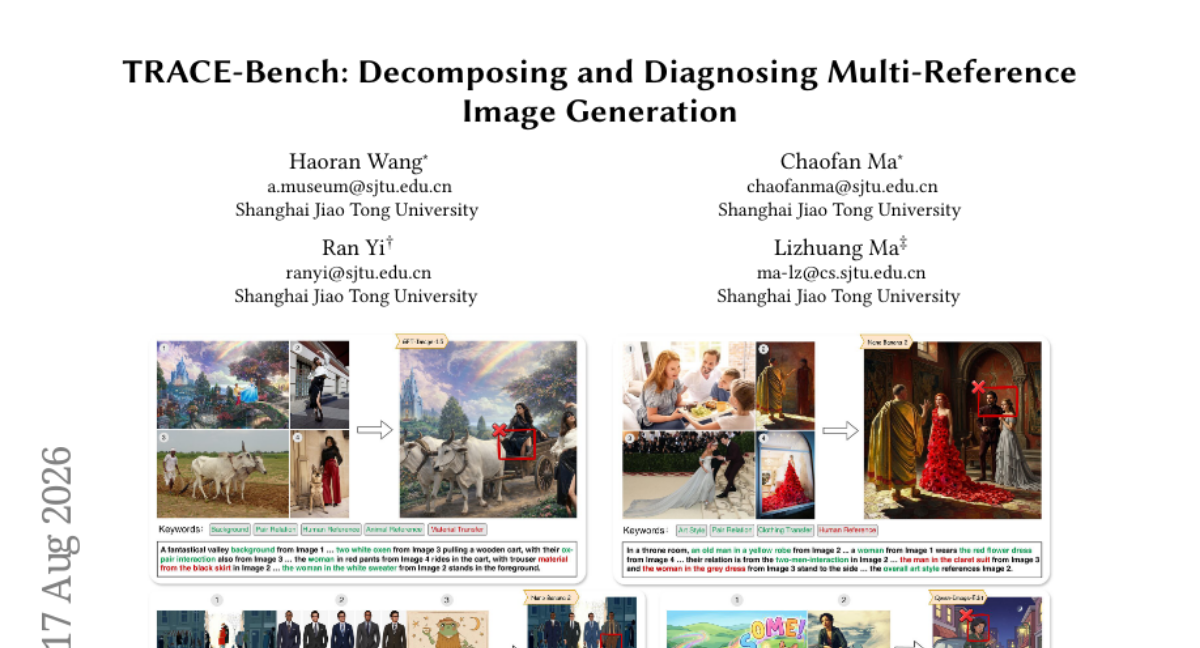
尽管多参考图像生成的多模态统一模型近期取得了进展,现有基准仍围绕预定义任务类型(如“主体组合”)组织,难以适应这一组合性场景,导致覆盖碎片化、复杂度不可控且诊断价值有限。 认识到多样化的多参考任务共享一组原子操作,我们采用能力导向视角,形式化四个算子:Anchor、Disentangle、Apply 和 Compose。任何多参考提示均可表示为这些算子上的组合公式,其结构复杂度由算子槽位数量量化。基于此,我们构建了 TRACE-Bench,包含约 1,600 个评估用例,槽位数 1–8,源自 631 个公式模板和约 4,000 张参考图像,覆盖多元艺术风格与现实主体。公式结构直接驱动算子对齐的评估协议,实现逐能力评分,并通过诊断树分析进行递归故障定位。 对 9 个领先模型的评估揭示了整体评分无法洞察的结论:主要瓶颈在于 Disentangle 和属性绑定(Apply),而非场景级组合(Compose);即使最佳模型在属性保真度上也仅得 0.74 分。项目页面:https://amuseum-whr.github.io/TraceBench
论文精读
TL;DR TRACE-Bench 将多参考图像生成拆解为四种原子算子,按算子评分并递归定位故障,显示瓶颈在解耦与属性绑定而非场景合成。
问题
多参考图像生成正成为统一多模态模型(如 GPT-4o、Gemini、Qwen-VL)的核心能力,研究者关注模型能否根据多个参考图完成风格迁移、主体合成、属性编辑等复杂任务。
现有方法局限
- 现有基准按预定义任务类型(如
subject composition、virtual try-on)组织,但真实场景中任务高度组合化,导致基准覆盖碎片化、样本复杂度不可控。 - 此类任务共享底层原子操作(解耦、绑定、合成),却因任务割裂而无法横向比较模型在单一能力上的表现。
- 整体指标(如 CLIP 相似度)无法定位失败发生在哪一步,诊断价值低,模型迭代缺乏精确信号。
为什么难且重要
多参考生成要求模型同时完成 Disentangle(解耦)、Apply(属性绑定)、Compose(场景合成) 等原子操作,任何一步出错都会导致最终结果偏离预期。尤其是解耦与属性绑定,需要模型在多个参考图之间建立精确对应关系,而不只是生成“看起来合理”的图像。业界亟需可分解、可递归定位失败的评测工具,否则只能依赖整体分数盲目调参、堆数据,难以突破能力瓶颈。
类似 LLM 评测从单一 BLEU/ROUGE 分数转向 BIG-bench、HELM 的能力维度分解,多参考图像生成也需要“单元测试”级别的诊断基准,而非只报一个总分。
核心洞察
- TRACE-Bench 首次以原子算子组合公式统一表征多参考图像生成任务,将任务复杂度量化为算子槽位数量。相较于现有 benchmark 按固定任务类型(如“主体合成”)组织,导致覆盖碎片化、复杂度不受控且缺乏诊断性,该框架把任意多参考提示拆解为 Anchor、Disentangle、Apply、Compose 四个基本操作的嵌套公式,使得评测可以跨任务类型横向比较能力,并支持递归失败定位。这一能力导向视角为后续构建可扩展、可诊断的生成评测提供了新范式。
- 诊断树分析揭示多参考生成的主要瓶颈在于解耦(Disentangle, g)与属性绑定(Apply, ⊕),而非场景级合成(Compose, C)。传统整体评分掩盖了失败的具体算子环节,而 TRACE-Bench 利用公式结构将评估结果沿算子树回溯,精确到细粒度能力缺陷。在 9 个主流模型上的实验显示,即使最优模型在属性保真度上仅得 0.74,说明属性-参考图像的准确绑定是当前最薄弱环节。这为模型优化指明了优先方向:加强对象属性解耦和跨参考绑定能力,而非盲目提升整体场景复杂度。
方法
方法核心:能力分解与组合公式
输入 为多参考图像生成任务,其中包含多个参考图像与文本指令。
关键模块 如下:
算子形式化:定义四个原子算子。
- Anchor (f):从参考图像中提取并稳定保持某一主体或风格。
- Disentangle (g):从单一参考中分离出多个独立属性,如身份、姿态、材质。
- Apply (⊕):将分离出的属性绑定到目标主体或场景。
- Compose (C):将多个已绑定结果在场景层面组合。
公式组合:任意多参考任务可表示为这些算子的组合公式,结构复杂度由算子槽位数量(1–8)量化。相比按任务类型划分,该表示更细粒度且可叠加。
基准构建:基于 631 个公式模板和约 4000 张参考图像(覆盖艺术风格与真实主体)生成约 1600 个评估案例,槽位数覆盖 1–8。
评估协议:公式结构直接驱动 算子对齐评估,分别计算 Anchor / Disentangle / Apply / Compose 的能力得分;并通过 诊断树分析 递归定位失败层级,判断瓶颈出现在哪个算子。
输出 为每个模型的总体分、各算子能力分及失败归因路径。对 9 个主流模型的评估显示,瓶颈集中在 Disentangle (g) 与 Apply (⊕),而非 Compose (C),最佳模型在属性保真上仅 0.74。
跟同类方法的差异点:TRACE-Bench 以原子算子组合公式替代预定义任务类型,使复杂度可控、覆盖系统化,并直接支撑细粒度诊断,而非仅提供总体分数。
实验
实验设计
TRACE-Bench 将多参考图生成分解为四个原子算子:Anchor (f)、Disentangle (g)、Apply (⊕)、Compose (C)。基于 631 个公式模板与约 4,000 张参考图像,构造约 1,600 个评估案例,覆盖 slot 1–8。评估 9 个主流多模态模型,采用算子对齐协议分项打分,并用诊断树递归定位失败来源。
关键发现
- 整体评分掩盖瓶颈:诊断显示主要瓶颈在 disentanglement (g) 与 attribute binding (⊕),而非场景级组合
C。 - 最佳模型 attribute fidelity 仅 0.74,表明属性解耦与绑定是当前短板。
对比解读
相比按任务类型组织的 benchmark,TRACE-Bench 的公式化结构避免碎片化覆盖与复杂度失控,能将跨模型差异定位到算子级能力。实际工程优化应优先提升特征解耦与属性绑定模块,而非盲目扩展场景合成规模。
行业影响
落地场景
TRACE-Bench 适用于需要组合多个参考图像生成新内容的业务,尤其适合电商商品图合成和内容平台个性化创作。例如,电商场景中给定一张服装版型参考、一张面料纹理参考和一张模特姿态参考,生成新的商品图;内容平台场景中根据用户上传的多张风格参考图自动生成海报或头像。基准的算子分解(Anchor / Disentangle / Apply / Compose)能覆盖从单参考到多参考的复杂组合,帮助团队明确模型在哪一步出错。
商业价值
多参考生成直接服务于降本:减少电商拍摄、人工修图与多轮设计返工,尤其将原先需设计师手动合成的多素材融合变为自动流程。同时提升体验:更准确地绑定属性可降低退货率、提高内容点击与转化。TRACE-Bench 的诊断树能定位瓶颈(当前最佳模型属性保真度仅 0.74),避免团队在场景合成上盲目优化,将资源聚焦于解耦和属性绑定等薄弱环节,缩短模型迭代周期。
与现有产品/工作流的接口
- 将 TRACE-Bench 作为 CI 评测环节,接入模型训练后回归或版本发布流程,输出每个算子得分与失败路径,替代传统单一整体指标。
- 可绑定 ComfyUI 或自研生成 pipeline,把评测用例转为自动化测试脚本,对生成图像做 checklist 校验。
- 与现有多模态评测框架(如
lm-evaluation-harness)平行运行,为多参考生成任务提供结构化诊断数据,反馈到数据配比或微调策略。
局限
- - **算子划分与公式模板的完备性有限**:基准依赖人工定义的 `Anchor` / `Disentangle` / `Apply` / `Compose` 四类原子算子,其粒度未必能覆盖所有真实多参考生成中的隐性依赖、空间关系约束或跨模态风格迁移。模板数量为 631 个,slot 数仅到 8,对深层嵌套或超长链式组合的覆盖不足;未来需要从真实用户提示中自动挖掘更复杂的公式分布,以减少人工设计的偏差。
- - **评测协议与人类感知存在差距**:目前采用规则化 checklist 和算子对齐的自动打分,虽然附录 C 报告了协议可靠性,但未与大规模人工评估或用户研究做系统对比。`attribute fidelity` 仅 0.74 的分数可能不能完全反映视觉合理性或风格一致性;诊断树对失败模式的定位受限于预定义的错误类型,多个算子联合失效或隐性语义冲突这类复合错误难以递归分解,可能导致错误归因。
- - **实验范围与下游指导性受限**:评测仅覆盖 9 个统一的 multimodal 模型,未纳入专门针对多参考生成微调的模型或最新闭源版本;基准本身不提供训练信号,诊断结果不能直接用于模型改进。同时,所有任务均为静态图像生成,未扩展至视频、3D 或多轮交互式生成场景,限制了其在更广泛生成任务中的诊断和通用性。