AnyTalk: 利用视频生成模型实现任意角色的语音动画
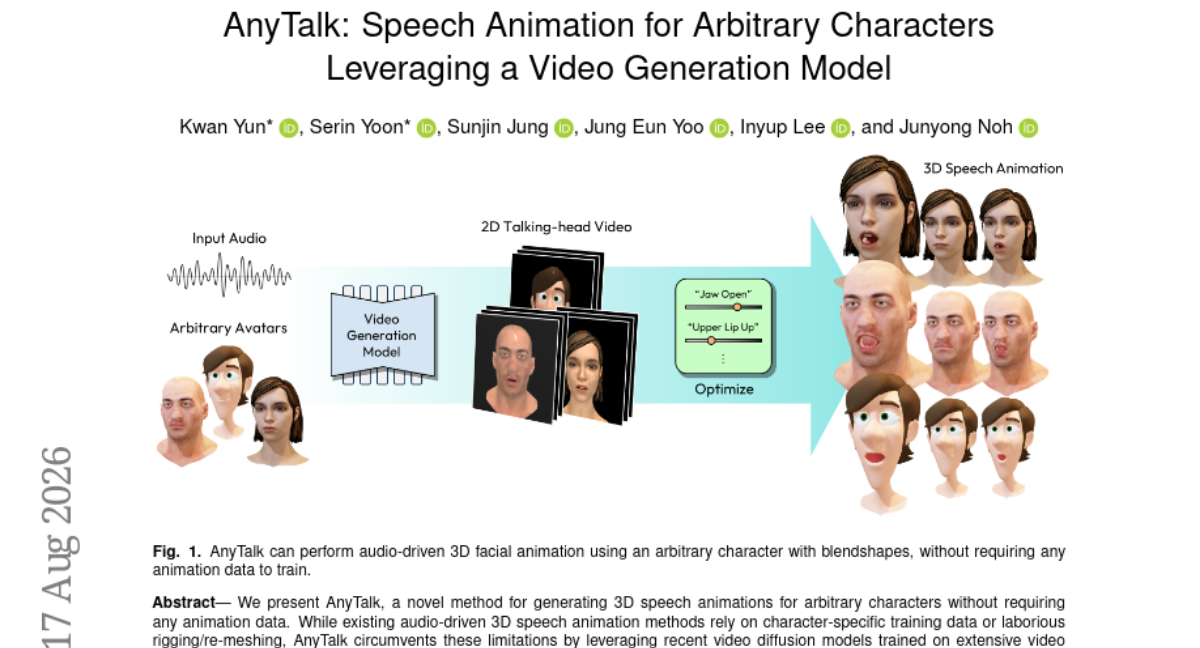
AnyTalk 提出了一种为任意角色生成 3D 语音动画的新方法,无需任何动画数据。现有音频驱动的 3D 语音动画方法依赖特定角色的训练数据或繁琐的绑定/重建,而 AnyTalk 通过利用在大型视频数据集上训练的 视频扩散模型 来规避这些限制。 首先,我们通过 角色专属微调 (CsF) 技术,将预训练的视频扩散模型适配到目标角色。通过对 3D 角色的渲染图像与零化音频嵌入(表示“无运动”)配对进行微调,我们在消除动画数据需求的同时,保留了大规模视频扩散模型的运动先验。然后,我们通过提出的优化过程估计 blendshape 参数,将生成的说话头视频提升为 3D 语音动画。 AnyTalk 能够在不同的面部网格和 blendshape 配置下实现唇形同步动画,显著减少手动工作和数据需求。我们进一步通过将 AnyTalk 蒸馏为精简网络 AnyTalkRT,增强了其实用性,从而支持实时性能。通过利用说话头视频生成,我们的方法拓宽了任意角色音频驱动语音动画技术的可及性。代码已开源。
论文精读
TL;DR AnyTalk 微调预训练视频扩散模型,无需任何动画数据即可为任意 3D 角色生成语音动画,并优化 blendshape 参数,还蒸馏出实时版本 AnyTalk_RT。
问题
问题背景
音频驱动的 3D 语音动画在虚拟数字人、游戏角色、影视预演等场景需求持续上升。业界希望任意带 blendshape 的角色都能低成本获得自然的口型动画。
现有方法局限
现有路线主要分两类:
- 角色专属监督训练:依赖大量 4D 面部扫描或动捕数据,如 VOCA、FaceFormer 等方法需要目标角色的成对音频-动画数据,新角色必须重新采集,成本高且不可扩展。
- 通用跨角色回归:通过共享拓扑或 FLAME 参数化模型实现一定泛化,但遇到 任意 mesh 拓扑 和 非标准 blendshape 配置 时,要么需要繁琐的 rigging/re-meshing,要么精度明显下降。 另一类基于 2D 说话人视频生成的方法虽能生成逼真口型,却只输出 RGB 帧,难以直接得到驱动 3D 角色的 blendshape 参数,后续拟合常受遮挡、光照影响,缺乏稳定约束。
为什么难且重要
挑战在于:不同角色的 blendshape 语义不一致、面部拓扑差异大,难以用单一模型统一建模;同时成对音频-动画数据稀缺,难以监督。视频扩散模型 从大规模视频中学到丰富运动先验,但直接迁移到 3D 角色会出现域差距,需要高质量适配且避免灾难性遗忘。业界关注点正从“单一高精度数字人”转向“低成本覆盖长尾角色”,因此无动画数据的任意角色语音动画成为关键工程需求。
行业类比
类似用大规模预训练文生图模型做个性化物体生成:只需少量该物体的无标注图片微调,即可让模型学会特定概念,无需收集成对标注数据。AnyTalk 借同样的思路把视频生成先验迁移到任意 3D 角色。
核心洞察
- **CsF 零音频嵌入微调** 将“无运动”作为约束,让预训练视频扩散模型仅通过渲染静帧学习角色身份,同时保留大规模视频中的运动先验,从而无需任何动画数据。传统方法依赖角色特定的4D扫描或费力rigging,而此方法把视频扩散模型视为通用运动先验,用零音频嵌入防止模型在微调时产生默认嘴部动作,使模型在推理阶段能正确响应真实音频。该策略巧妙地绕过了数据稀缺,对工程上快速适配新角色具有直接借鉴意义。
- **从视频到 blendshape 的逆向优化** 将 3D 语音动画问题重构为“生成 2D talking-head 视频 + 像素级优化 blendshape 参数”,而不是直接回归 3D 顶点或系数。这一间接路线让方法能够适配任意面部网格和 blendshape 配置,因为优化阶段只需渲染器与视频帧对齐,不要求固定拓扑。相比 Audio2Face、MeshTalk 等需要预绑定 rig 或特定拓扑的 baseline,AnyTalk 的通用性显著更高,也解释了为何能应用于不同风格角色。
方法
输入
- 目标 3D 角色的 mesh 与任意 blendshape 配置
- 驱动音频
- 不提供任何配对的动画数据
关键模块
Character-specific Fine-tuning (CsF)
先渲染该角色的中性/随机姿态图像,并将其与 zeroed-out audio embeddings(表示“无运动”)配对,对预训练视频扩散模型做微调。目标是保留大规模视频数据中的通用面部运动先验,同时让模型绑定到该角色的视觉身份,避免灾难性遗忘。Video Inference
微调后,输入真实音频 embedding,生成该角色的 talking-head 视频片段。此时音频驱动模型自然产生唇形与头部运动。Optimization
从生成视频中估计 blendshape 参数。通过光度优化(photometric optimization)等损失,令 3D 渲染结果逐帧逼近视频帧,最终得到 blendshape 权重序列。过程中还包含 landmark filtering 与 head pose stabilization 等后处理。Distillation (AnyTalk_RT)
将上述 pipeline 蒸馏为精简网络,省去视频生成与每帧优化,实现实时推理。
输出
- 任意角色 mesh 的音频驱动 3D speech animation(逐帧 blendshape 序列)
差异点
与依赖角色特定动画数据或复杂 rigging 的既有方法不同,AnyTalk 只需渲染图像与零音频嵌入即可适配新角色,将数据需求从动画标注降低为纯渲染图,并通过视频生成先验绕过动画数据获取瓶颈。
实验
实验设计
AnyTalk 在多种任意 3D 角色(不同面部网格与 blendshape 配置)上评估,无需任何动画数据。实验包括与现有音频驱动 3D 语音动画基线对比,消融研究验证 Character-specific Fine-tuning (CsF) 与优化策略(如 photometric optimization、head pose stabilization)的必要性,并进行用户研究评估感知质量。同时评估蒸馏后的 AnyTalk_RT 的实时性能。
关键发现
- CsF 仅使用零音频嵌入渲染图像微调后,仍保留视频扩散模型的运动先验,生成与音频同步的说话头视频。
- 通过优化 blendshape 参数可将 2D 视频提升为 3D 动画,适用于任意 blendshape 拓扑。
- AnyTalk_RT 实现实时推理,同时保持可接受的动画质量。
- 无需动画数据,大幅降低数据准备成本。
与基线对比
与依赖角色特定训练数据的方法相比,AnyTalk 避免大规模 3D 动画数据采集,仅需静态渲染图;与基于 rigging/re-meshing 的流程相比,自动估计 blendshape 权重,省去手工绑定,但可能引入优化误差;相比直接生成 2D 说话头视频,AnyTalk 得到 3D 参数化表示,可直接驱动任意角色模型,需权衡生成质量与优化效率。
行业影响
落地场景
- 游戏 NPC 口型同步:利用 AnyTalk 对任意 3D 角色进行零动画数据微调,自动生成与语音适配的 blendshape 权重,大幅减少美术资产准备。
- 虚拟主播与数字人客服:实时变体
AnyTalk_RT可直接接入语音流,驱动任意风格的面部网格,适合直播、在线客服、虚拟助手等场景。 - 教育 / 社交 AR 头像:为虚拟教师或用户自定义头像提供语音驱动表情,提升互动沉浸感。
商业价值
- 降本:传统语音动画需要逐角色采集或手工标注 blendshape 动画,AnyTalk 只需渲染图像即可适配,使中小团队能以更低成本实现口型同步。
- 增收:平台可为海量 UGC 角色提供自动语音动画服务,形成增值能力或订阅模式。
- 体验提升:实时推理能力让低延迟对话成为可能,改善用户参与度与留存。
与现有工作流接口
- 输入侧:开发者需准备目标角色的 3D 网格、标准 blendshape 集合和少量渲染图,通过
Character-specific Fine-tuning生成该角色的 talking-head 视频生成器。 - 运行时:音频送入生成器得到视频,再经优化过程反解 blendshape 参数,直接驱动现有动画蓝图或骨骼变形器;也可将
AnyTalk_RT封装为引擎插件(Unity / Unreal)或云端 API。 - 数据闭环:输出 blendshape 权重符合标准动画管线,可与现有 retargeting、IK、渲染后处理无缝衔接。
局限
- AnyTalk 高度依赖预训练视频扩散模型的运动先验,该先验主要来自真实人类说话视频。对于风格化、卡通、非人形或具有非常规口型特征的角色,微调后模型可能产生不自然的嘴部运动或无法处理复杂音频(如噪声、音乐、多人语音)。此外,“零音频嵌入对应无运动”这一假设在微调中可能不够精确,导致模型在推理时错误地将音频与运动关联,生成模糊或异常的视频帧,进而影响后续 blendshape 参数估计的准确性。
- 原始优化流程需要从生成视频中逐帧估计 blendshape 参数,通过迭代优化求解,计算开销较高,尤其对于高分辨率网格或大量 blendshape 配置,难以直接用于实时交互场景。虽然蒸馏出 AnyTalk_RT 实现实时性能,但蒸馏过程通常损失细节,且需要额外的训练数据和资源。在资源受限环境中,实时版本可能牺牲唇同步精度或表情丰富度,无法同时满足高保真与低延迟的要求。
- 方法假设角色具备预定义的 blendshape 集,且优化过程能够通过调整这些 blendshape 权重来匹配视频帧。但不同角色的 blendshape 数量和语义差异巨大,若 blendshape 集覆盖不全(例如缺少某些元音口型),优化可能无法准确匹配,导致动画僵硬或错误。对于使用骨骼驱动、形状键驱动或其他非 blendshape 面部动画系统的角色,需要额外的转换步骤或重新设计优化目标,增加了集成难度和工程成本。