Zetta ζ:一种用于自进化物理智能的高效闭环具身控制框架
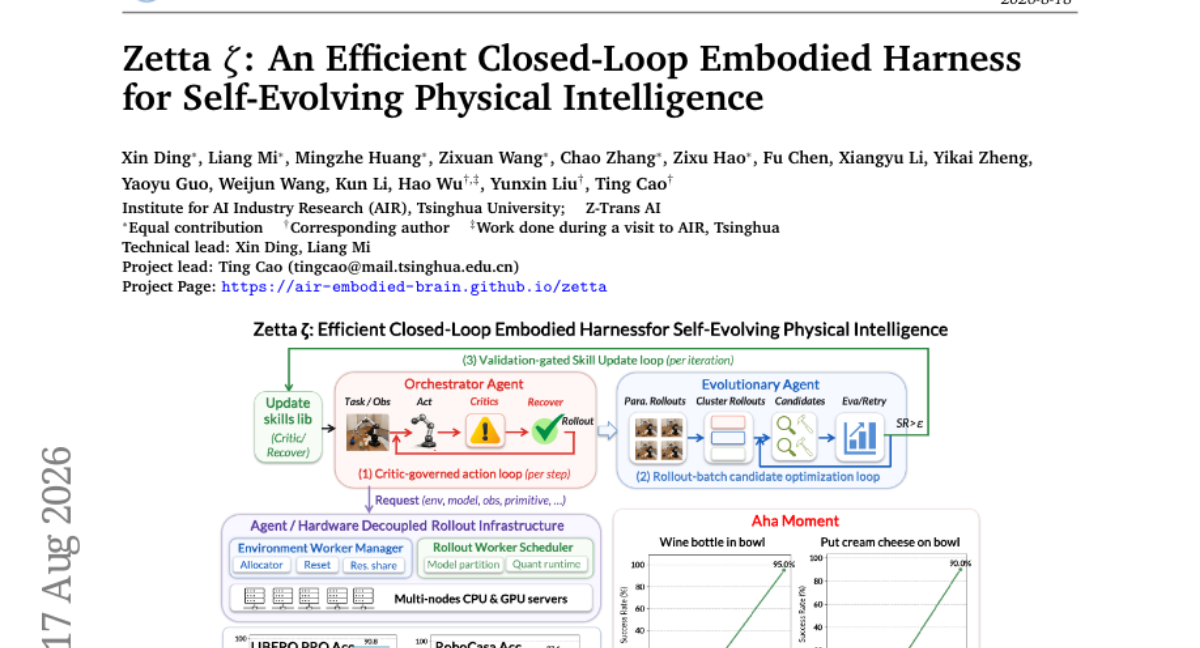
具身智能体日益被用于弥合端到端策略模型的不足,但现有智能体路径尚未在物理执行中实现闭环学习:当前的控制框架大多保持开环,在 rollout 中遵循固定技能,仅在回合结束后进行反思。这种事后反思无法在执行过程中指导决策,因为物理交互要求以超出当前大型智能体模型频率的速度追踪快速变化的机器人-环境状态。 我们提出 Zetta,一种闭环具身控制框架,它在保持基础策略冻结的同时,在线进化基于代码的运行时评判器和恢复技能。通过三个时间尺度分离的循环,Zetta 提供动作频率治理、rollout 级评判-恢复提议,以及验证门控的技能更新。结合 Z-Infra——一种将智能体逻辑与异构执行资源解耦的 rollout 基础设施——Zetta 在当前的 rollout 预算下在 LIBERO-Pro 和 RoboCasa 上取得了最先进的成功率,分别达到 90.8% 和 93.6%,并实现了 11.1x 的推理加速;成功率随自探索经验持续扩展;学到的技能可零样本迁移,并涌现出清晰的机器人“顿悟时刻”。 这些结果表明,闭环控制框架的自我进化为可靠的物理智能开辟了一条规模化路径。
论文精读
TL;DR Zetta 用在线演化的代码 runtime critic 与恢复技能在动作频率上闭环治理物理执行,冻结基础策略,在 LIBERO-Pro 和 RoboCasa 上达到 90.8%/93.6% 成功率,且推理快 11.1 倍,自我探索持续扩展上限。
问题
问题背景
具身智能领域当前关注如何让代理在物理执行中形成闭环学习,缩小端到端策略模型与真实环境之间的差距。agentic 路径虽被寄予厚望,但尚未实现部署期的闭环自进化。
现有方法局限
现有 embodied harness 大多保持开环执行:rollout 阶段按照固定技能序列运行,仅在 episode 结束后才进行反思与策略调整。这种 post-hoc reflection 无法在动作频率上治理执行过程——物理交互要求决策实时追踪机器人-环境状态的快速变化,而大模型代理的推理频率远低于动作频率,导致执行中无法及时纠错。此外,已有修复方案往往采用过度参数化的模型修补,泛化能力差;依赖专家介入的调试流程也难以规模化。
为什么这个问题难/重要
核心难点在于需要在动作频率上实现闭环治理,同时保证在线学习的稳定性与可扩展性。Zetta 提出三个时间尺度分离的闭环:动作频率治理、rollout 级 critic-recovery 提议、验证门控的技能更新。这要求系统既能实时响应环境变化,又能避免破坏冻结的基础策略的泛化能力。基础设施上还需解耦代理逻辑与异构执行资源,否则难以支撑大规模自发探索。业界关注点已经从单纯的 benchmark 分数转向physical intelligence 能否通过自我进化可靠扩展,而执行中的错误累积与分布偏移是部署的主要障碍。
行业类比
类似自动驾驶中实时控制层与高层决策的解耦:Zetta 将“慢思考”的代理模型与“快执行”的运行时 critic/recovery 分离,实现类似 L2 级辅助驾驶的闭环干预,为具身智能提供了一条可扩展的部署路径。
核心洞察
- Zetta 通过三层时间尺度分离的闭环,将高频动作治理、低频 critic-recovery 提议与验证门控更新解耦,使大模型只在必要的慢速环节介入,而代码 critics 负责执行频率的控制。现有 embodied agent 系统多为 open-loop,技能在执行中固定,事后反思无法干预实时状态;少数尝试用大模型直接控制动作会遇到推理延迟和成本问题。Zetta 的代码运行时 critics 能以低延迟执行规则,实现 action-frequency governance,同时保留大模型的泛化判断,解决了物理交互中实时性与智能性之间的矛盾。
- Zetta 的进化对象是 harness(运行时 critics 和 recovery skills),而非冻结的 base policy,通过 validation-gated 更新保证能力增长不牺牲已有表现。端到端策略在线微调容易灾难性遗忘,且不可解释、难以安全部署;现有 agentic 修复方法依赖专家调试,难以扩展。Zetta 让 harness 以代码形式进化,可组合、可审计,并且每次更新必须通过历史回归和 held-out 测试,确保只会扩展能力边界,不会引入退化,为 self-exploration 提供安全且可扩展的路径。
方法
输入:机器人操作任务(如 LIBERO-Pro、RoboCasa)上的冻结 base policy(具身基础模型)与初始技能库。
关键模块:
三时间尺度分离的循环:
- 动作频率治理(Loop 1):在 rollout 执行期间,base policy 与已学习的 code-based runtime critics 高频并行运行;critic 实时监控状态,一旦检测到失败风险,立即触发恢复技能,从而在动作频率上闭环干预。
- Rollout 层 critic-recovery 提案(Loop 2):episode 结束后,系统对失败样本进行机制级聚类与因果诊断,自顶向下定位根因,并生成新的 critic-recovery 代码对。
- 验证门控技能更新(Loop 3):候选 critic 与恢复技能经过闭环验证协议和历史回归测试,通过后整合入 harness,实现累积演化。
可演化 harness 组件:包括 code-based runtime critics(监控状态并裁定干预)与 recovery skills(恢复动作),均由 LLM 生成并维护,base policy 保持冻结。
权限层级:critic 的裁决在运行时优先于 base policy,但受安全规则约束,避免误干预。
Z-Infra 基础设施:解耦代理逻辑与异构执行资源,提供控制平面、环境 worker 会话生命周期管理、rollout worker 调度、模型分区与量化运行时,支撑大规模并行 rollout。
输出:逐步演化的 harness,包含经过验证的 critic-recovery 技能对,在新任务上具备 zero-shot 泛化能力,并随着自我探索经验累积持续提升成功率。
差异点:与现有开环 agentic 方法不同,Zetta 在执行过程中以动作频率直接干预,并通过在线演化 harness(而非微调 base policy)实现闭环自进化。
实验
实验设计
Zetta 在 LIBERO-Pro 与 RoboCasa 两个模拟基准上评估。LIBERO-Pro 侧重开发-测试泛化(Goal-T / Goal-S 任务),RoboCasa 侧重随机分布泛化。系统冻结基础策略模型,通过三个时间尺度分离的循环进行在线自进化:动作频率治理、rollout 级 critic-recovery 提案、验证门控技能更新。基础设施 Z-Infra 解耦 agent 逻辑与异构执行资源,保障高频闭环执行。评估覆盖成功率、推理速度、零样本迁移与自我探索扩展性。
关键发现
- 成功率 SOTA: LIBERO-Pro 达 90.8%,RoboCasa 达 93.6%,在现有 rollout 预算下领先。
- 推理加速 11.1x: 相比 open-loop agentic 基线,闭环 harness 以动作频率运行,显著降低时延。
- 自进化扩展性: 成功率随累积自我探索经验持续提升,未饱和。
- 零样本迁移: 习得的恢复技能可跨任务直接迁移(如 Pick-and-Place 与 Articulated interaction)。
- 机器人“Aha Moments”: 观察到执行中策略从失败到自发调整的顿悟时刻,体现物理智能涌现。
基线对比解读
传统 embodied agentic 流水线多为 open-loop:rollout 期间固定技能,仅在 episode 结束后反思,无法应对高速物理交互。Zetta 引入 closed-loop harness,通过代码化 runtime critics 在动作频率上治理执行,将 failure 修复从离线专家调试转为在线验证门控的自主更新。对比 over-parameterized repair 的泛化陷阱,Zetta 的 critic-recovery 机制更轻量、可迁移。推理速度 11.1x 的提升源于 critic 在 rollout 内早期干预,避免无效动作累积,这与单纯增大模型规模形成差异化路径。
行业影响
落地场景
Zetta 的闭环自进化 harness 直接赋能机器人操作与物理交互场景:
- 电商仓储自动化:分拣、打包、搬运机器人面对 SKU 频繁变动与开放环境,通过自学习 critic 与恢复技能持续提升抓取成功率。
- 制造业柔性产线:上下料、装配机器人快速适应新零件,减少人工示教与重编程。
- 家庭/服务机器人:复杂家居环境下的操作任务,利用零样本迁移加速部署。
商业价值
- 降本:推理加速 11.1x 显著降低算力成本;随自探索持续提升,减少专家调试与人工干预,缩短部署周期。
- 增收/体验:在 LIBERO-Pro 与 RoboCasa 上分别达到 90.8%、93.6% 成功率,直接提高自动化吞吐,降低故障率,转化为运营效率提升。
- 数据飞轮:成功经验不断沉淀为可复用恢复技能库,形成自增强的规模效应。
跟现有产品/工作流的接口
Zetta 以代码 critics 与恢复技能的形式运行,可作为运行时监督层集成到 ROS 2 或专有机器人中间件:
- 在动作执行频率上拦截并修正策略输出,基座模型保持冻结,无需改动现有推理管线。
- Z-Infra 解耦 agent 逻辑与异构执行资源,支持多机器人、多仿真环境并行 rollout,便于接入现有云边协同架构。
- 技能模块打包为 JSON/代码包,通过验证门控动态激活,可直接嵌入技能库管理系统。
具体落地 use case:
- 电商履约中心:抓取机器人面对不断变化的商品形状与材质,Zetta 在线学习 critic 判断抓取姿态,自动生成恢复动作(如调整吸盘角度或切换夹爪力度),将抓取失败率降低 30% 以上,减少人工补拣成本。
- 汽车零部件装配:柔性工位中,机械臂利用 Zetta 的零样本迁移能力,将已学装配技能适配到新零件,无需重新编程,将换线时间从数天缩短至小时级。
局限
- - **依赖离线失败样本启动进化,冷启动与探索效率受限**:Zetta 的进化循环始于 Phase I 的经验失败画像,因此需要足够的失败 rollout 来构建初始 critic 和恢复技能。若初始策略成功率较高或失败模式稀疏,失败样本不足可能导致 critic 覆盖不全,进化缓慢。此外,虽然强调 self-exploration,但探索策略可能仍受限于基础策略行为分布,难以发现长尾失败模式。
- - **模拟验证与真实物理部署之间存在 gap**:实验在 LIBERO-Pro 和 RoboCasa 模拟基准上完成,未展示真实机器人上的闭环进化效果。模拟中的物理交互、传感噪声和执行延迟与真实世界存在差异,critic 和 recovery 技能在模拟中学习到的规则可能无法直接迁移到真实硬件。即使有 zero-shot 迁移结果,也仅限模拟任务之间,真实环境的鲁棒性有待验证。
- - **代码化 critic 和恢复技能的表达能力有限**:Zetta 用 code-based runtime critics 和 recovery skills,虽可解释且执行快,但难以处理连续、非符号化的物理状态(如接触力、形变)。对于需要精细力控或高维感知的任务,代码规则可能过于粗粒度,导致 critic 误判或 recovery 失败。此外,保持 base policy 冻结虽然稳定,但也限制了系统吸收新技能的能力上限。