SPARGen: 通过原生多模态生成统一空间感知与推理
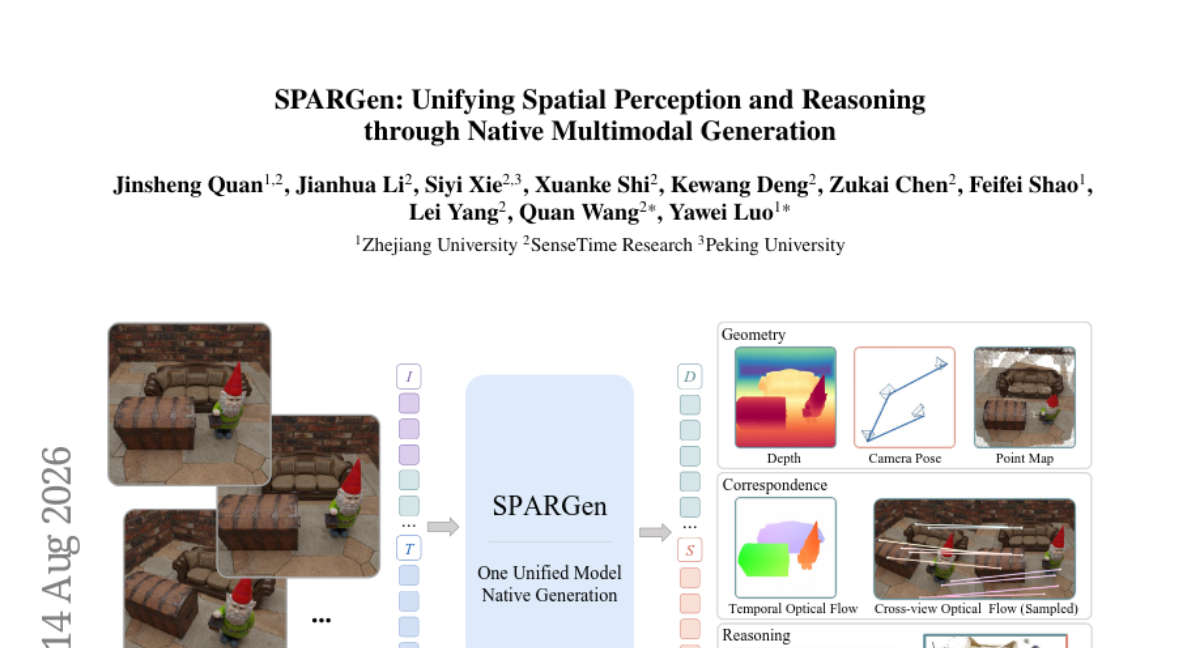
空间感知与推理需要从视觉观测中恢复几何结构、建立稠密对应并理解空间关系。现有方法通常使用任务特定架构或外部几何模块分别处理这些能力,限制了同一物理场景互补表示间的知识迁移。 我们提出 SPARGen,一个统一的多模态框架,将 3D 重建、稠密对应 和 空间推理 视为指令条件生成任务。SPARGen 将紧凑的结构化输出和语言输出序列化为 token 序列,同时生成图像对齐的稠密几何场,使空间监督能够共同塑造原生多模态生成模型中的共享表示。 在 3D 重建、对应 和 空间推理 基准上的实验表明,SPARGen 在单一原生多模态生成框架内实现了异构空间任务上的竞争性能。
论文精读
TL;DR SPARGen 用一个原生多模态生成模型统一 3D 重建、密集对应和空间推理,序列化紧凑输出并生成图像对齐几何场,让几何感知与语言推理共享表征。
问题
问题背景
空间感知与推理是视觉理解的核心任务,涵盖 3D 重建、稠密对应、空间问答等。当前领域关注如何从单目/多目视觉观测中同时恢复几何结构并执行高层语义推理。
现有方法局限
现有工作通常将各任务独立建模:3D 重建使用专用网络(如 DUSt3R / MASt3R),稠密对应依赖光流或匹配架构,空间推理则基于 VLM 加外部几何模块。这种分离带来三类问题:
- 特征割裂:同一物理场景的几何与语义表征分散在不同模型中,无法共享底层 3D 先验。
- 输出形式不兼容:重建输出密集点图/深度场,对应输出偏移场,推理输出文本 token,难以用统一目标联合训练。
- 推理链路脆弱:外部几何模块与语言模型拼接时,误差累积且缺乏端到端可微性。
为什么这个问题难 / 重要
核心挑战在于多模态输出统一表示:需要同时生成离散 token 序列(结构化结果、语言答案)和图像对齐的密集几何场(深度、对应关系),并要求两种模态的监督信号能共同塑造共享表征。技术上,这涉及异构输出空间的对齐与梯度协调。业界关注度高,因为原生多模态生成模型(如统一视觉-语言-几何模型)有望替代传统多级 pipeline,降低系统复杂度并提升跨任务一致性。
行业类比
类似机器人抓取系统:如果感知模块(物体位姿估计)、规划模块(空间关系推理)和语言交互分别独立训练,整体系统难以适应新场景;统一生成式空间模型可像端到端自动驾驶那样,将多任务输出整合为单一可学习目标。
核心洞察
- SPARGen 的核心洞察是将 3D 重建、稠密对应和空间推理统一为指令条件生成任务,在一个原生多模态生成模型内共享底层表示。与使用任务特定架构或外部几何模块的方法不同,这种统一使深度、相机运动、点图和光流等互补的几何监督信号能够共同塑造同一组特征,从而促进跨任务知识迁移,提升空间预测的一致性,并桥接几何感知与高层语义推理。
- 针对稠密几何输出,SPARGen 采用图像对齐的几何场表示,而非将全部信息序列化为 token 序列。这一设计避免了长序列生成中的冗余与精度损失,同时保留了密集的空间监督信号,与稀疏 token 序列输出形成互补。这种混合输出策略是生成式框架处理密集预测任务的关键创新,为在统一模型中高效融合结构化、语言与密集几何输出提供了工程范式。
- 指令条件生成范式赋予 SPARGen 灵活的任务适配能力,模型可根据不同指令切换 3D 重建、对应估计或空间问答等行为,无需重新设计网络结构。这类似于通用多模态助手的交互方式,使得统一空间智能模块可以方便地扩展到新任务,降低多任务部署的工程复杂度,也为构建具备感知与推理能力的具身智能系统提供了直接可复用的架构思路。
方法
输入与任务建模
SPARGen 接收图像观测和自然语言指令,将 3D 重建、密集对应、空间推理统一为指令条件生成任务。指令描述具体空间问题,模型需生成对应输出。
统一生成架构
核心是一个原生多模态生成模型(native multimodal generative model)。稀疏与结构化输出(如相机参数、匹配点索引、问答答案)被序列化为离散 token 序列,通过自回归解码生成。密集输出(如深度图、光流场、点对应图)以图像对齐场形式生成,即输出尺寸与输入图像对齐,保留像素级空间对应关系。
训练目标
训练使用混合目标:序列输出部分采用标准自回归交叉熵损失;密集几何场部分使用图像空间的重建损失(如 L1 或 L2 距离),并可能辅以空间一致性约束。所有任务共享同一个骨干网络和参数,密集监督通过图像对齐形式反向传播,促使共享表示学习场景结构。
与同类方法的差异
不同于常见方法中为不同空间任务设计独立专用架构或依赖外部几何模块(如 SfM、深度估计网络、匹配网络分别存在),SPARGen 在单一原生多模态生成框架内完成所有异构空间任务,实现共享表示与联合监督。
实验
实验设计
SPARGen 在 三维重建、稠密对应 与 空间推理 三类基准上评估。模型以指令条件生成方式输出两类表示:紧凑的结构化/语言输出序列化为 token 序列;密集几何场则以图像对齐形式生成。训练时联合优化稀疏输出和密集场目标,并与先前依赖任务特定架构或外部几何模块的方法对比。
关键发现
单一原生多模态生成框架在异构空间任务上取得有竞争力的性能。共享空间表示使几何重建、对应估计与高层推理能够互相提供监督,促进跨任务知识迁移并提升空间预测一致性。密集几何场的图像对齐生成形式与 token 序列输出互补,让统一模型同时处理连续场预测与离散结构化推理。
与基线对比
相比分离式任务专用模型或插入外部几何模块的流水线,SPARGen 不需要为每个任务维护独立参数或前后处理,降低了系统复杂度。虽然摘录未给出具体数值提升,但“competitive”表明统一生成范式没有以性能损失为代价,反而为多任务空间理解提供了一个更简洁、可扩展的底座。
行业影响
落地场景
SPARGen 作为统一多模态生成框架,可同时输出 3D 重建、稠密对应与空间推理结果,适用于需要联合几何感知与语义理解的场景:
- 电商 AR 购物:用户上传房间照片,模型生成深度图、点云与相机位姿,并进行空间关系问答(如“沙发能否放在窗边?”),驱动虚拟家具摆放与实时预览。
- 自动驾驶 / 机器人:统一处理深度估计、光流预测与空间关系推理,替代多个专用感知模块,简化车载或机器人感知栈。
- 内容平台视频理解:自动提取视频帧的空间结构与物体对应关系,生成场景图或空间描述,用于搜索、推荐与无障碍字幕。
商业价值
- 降低成本:一个模型替代多个任务专用架构,减少训练、部署与维护开销;指令条件生成允许按需调用不同能力,无需切换模型。
- 增加收入:AR 试摆、空间对话等新功能可提升用户交互深度与转化率;平台可提供空间理解 API 作为增值服务。
- 体验提升:统一表示促进跨任务知识迁移,减少预测不一致,提升空间推理的准确性与连贯性。
与现有产品/工作流的接口
SPARGen 可集成到现有 VLM 或 3D 感知流水线:
- 作为 backbone 嵌入已有 VLM(如 LLaVA、Qwen-VL),通过 instruction 格式触发 3D 重建、对应或空间推理任务。
- 输出 token 序列(结构化结果、语言回答)与图像对齐几何场(深度图、点图),可直接接入下游渲染引擎、规划器或数据库。
- 支持微调:使用领域数据(如室内场景、医疗影像)配合 LoRA 等参数高效方法,快速适配垂直业务,保留通用空间能力。
工程启示:将几何输出统一为图像对齐字段而非离散 token,可保留空间分辨率,避免量化损失,同时允许端到端梯度回传。
局限
- 统一框架下多任务共享表示可能导致任务间干扰,特别是低层几何重建需要保持像素级精度,高层空间推理需要抽象语义关系,两者优化目标存在张力,可能使单一模型在个别任务上无法达到专用模型的最优性能。论文仅报告竞争性结果而非 SOTA,暗示了这种权衡。实际工程中若对某一任务有极致要求,仍需专用方案。
- 方法将稠密几何场生成为图像对齐形式,并在自回归序列中生成结构化输出,推理时可能面临较高计算延迟和显存开销,相比前馈式专用网络缺乏实时性。论文未提供推理效率对比或延迟数据,限制了在资源受限场景下的部署可行性。
- 实验所覆盖的基准和任务类型有限,空间推理通常依赖特定数据集,跨域泛化能力未验证。与最新的大型多模态模型或专用几何模型(如 DUSt3R、MASt3R 等)的对比可能不够全面,难以判断其在真实世界复杂场景下的鲁棒性。