PlayWorld:基于智能体玩家面向长时程目标的世界模型基准测试
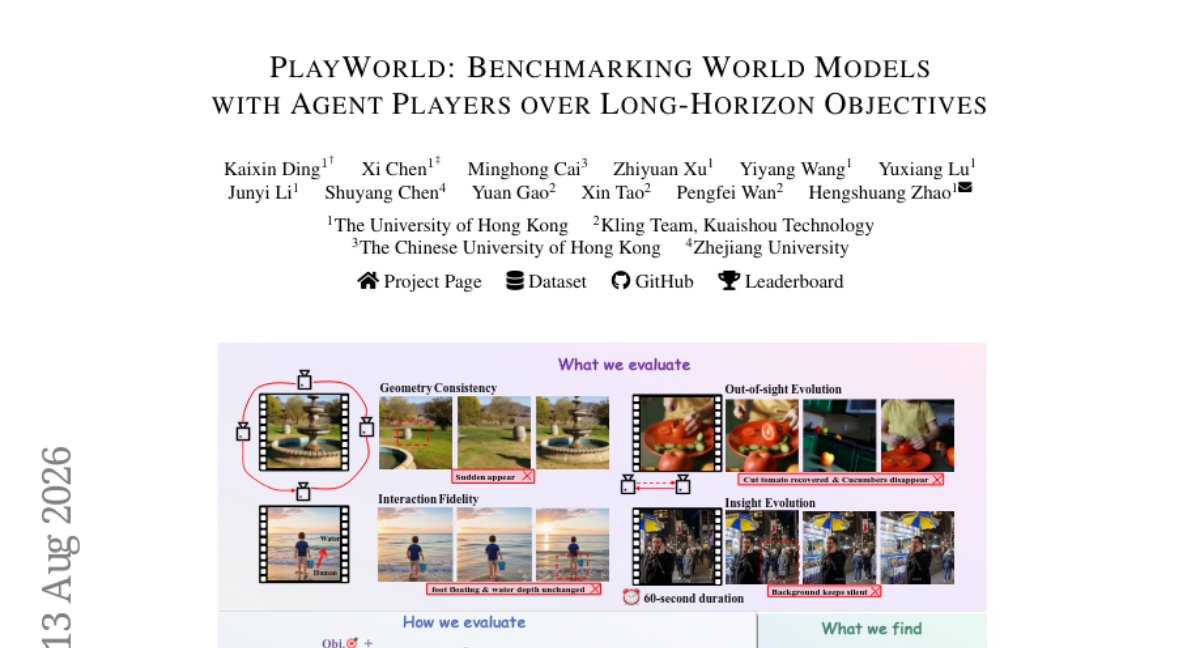
视频世界模型根据当前观察和用户动作模拟未来状态。近期系统在长序列上展示了令人印象深刻的视频一致性和动作可控性,然而公平比较这些交互式模型仍具挑战。实际中,人类玩家通常通过追求长时程目标来评估世界模型,例如旋转 360 度检查环境是否一致,或走入水中观察是否生成真实的水波。不同模型为达成同一目标所需的动作序列可能差异很大,因此固定动作条件评估不适用于跨模型比较。 为解决此问题,我们引入多模态智能体玩家 (Agent Players) 与世界模型交互,朝指定长时程目标前进。基于该范式,我们提出 PlayWorld 基准,包含 171 个场景,每个场景设有明确目标。为全面评估性能,我们从四个核心维度衡量:几何一致性、交互保真度、视野外演进 与 洞察演进。此外,我们还纳入基础能力指标,评估视频质量与可控性。 对九个最新世界模型的实验表明,当前模型在长时程交互目标上仍不可靠,尤其在保持空间一致性和持续状态演进方面。代码与数据见 https://github.com/kxding/PlayWorld。
论文精读
TL;DR PlayWorld 用多模态 Agent Players 与世界模型交互,在 171 个长程目标场景中评估几何一致性、交互保真度与状态演变,解决了固定动作序列无法公平跨模型比较的痛点,并暴露现有模型的可靠性不足。
问题
问题背景
视频世界模型旨在根据当前观测和动作序列预测未来状态,近期在长时一致性和动作可控性上取得显著进步。
现有方法局限
- 固定动作序列的离线指标(如 FVD、PSNR)只评估生成视频质量,无法衡量交互过程中的目标达成能力。
- 人工评测依赖主观判断,难以规模化,且不同评测者对长程目标完成度的标准不一致。
- 关键限制:同一长期目标在不同模型间需要不同的动作序列才能实现,固定动作条件无法公平比较跨模型能力。
为什么难/重要
- 长程交互目标要求评测方具备主动探索能力,能根据当前生成画面动态调整动作。技术挑战在于如何用多模态 Agent 生成既合理又模型无关的动作策略。
- 世界模型的可靠性还体现在空间一致性、隐藏区域的状态演化、非直接可见的物理规律等维度,这些难以用传统视频指标刻画。
- 业界对世界模型在具身智能、自动驾驶仿真等场景的落地高度关注,缺少标准化交互基准会阻碍模型迭代与横向对比。
行业类比
类似于自动驾驶仿真中用场景级行为合理性测试评估预测模型,而非只看单帧渲染质量。
核心洞察
- 将评估范式从固定动作序列转向目标驱动的 agent 交互,解决了跨模型公平比较问题。传统世界模型基准对所有模型输入相同动作序列,但不同模型达成同一目标(如 360 度转身)所需的动作粒度与步数不同,固定序列会引入偏差。PlayWorld 引入多模态 Agent Player,根据模型实时反馈自主规划动作,使评估聚焦于“在交互中实现长期目标的能力”,而非对特定动作的响应,更贴近真实用户测试场景。
- 提出四维能力分解框架(几何一致性、交互保真度、视野外演化、洞察演化),超越短期视觉质量评估。已有基准多关注视频生成质量和短时动作一致性,缺乏对长期空间一致性与状态持久性的系统度量。PlayWorld 用 171 个场景分别考察这些维度,覆盖从空间几何稳定性、物体交互反馈到视野外变化和语义洞察,为诊断模型短板提供了细粒度工具。
- 实验揭示九款最先进世界模型在长期交互目标上普遍不可靠,尤以空间一致性和持久状态演化为甚。即便基础视频质量指标表现良好,模型在多步交互中仍频繁产生几何扭曲或状态遗忘。这表明当前世界模型的内部表征不足以支撑稳定的环境模拟,未来需从架构或训练目标上加强时空一致性,而非仅优化生成质量。
方法
输入与评测范式
PlayWorld 的输入包括:世界模型接收的当前视频帧观测、用户可执行的动作空间(如旋转、前进、交互),以及为每个场景定义的长期目标(long-horizon objective),例如“转身 360 度并保持环境一致”或“走入水中并观察涟漪”。
关键模块
多模态 Agent Player
基于视觉语言模型构建,具备视觉感知与动作规划能力。Agent 根据当前帧和目标,动态生成下一步动作,而非使用预设的固定动作序列。这样可让不同世界模型在达成同一目标时采取各自的交互路径,实现跨模型公平比较。171 个场景与目标定义
每个场景绑定一个可验证的长期目标,覆盖四类核心能力:- 几何一致性:空间结构在连续动作后是否保持稳定;
- 交互保真度:动作引起的物理反应是否合理(如水波、碰撞);
- 视野外演化:离开视野再返回后场景是否持续演化且一致;
- 洞察演化:对隐式状态的理解是否在序列中保持(如物体被移动后的位置)。
VQA Rubric Verifier
使用视觉问答方式对每个目标进行自动化打分:将目标拆解为多项可检查的子问题,VQA 模型基于最终视频帧或关键帧给出是/否判断,汇总得到该场景的达标分数。基本能力评估
附加视频质量(如 FID、清晰度)和动作可控性(如条件一致性)指标,以区分基础生成能力与长期交互能力。
输出
对每个世界模型,PlayWorld 输出四个核心维度的场景达成率、整体可靠性分数,以及基本质量指标,并形成排行榜(Leaderboard)。
与固定动作序列的帧级评测不同,PlayWorld 通过闭环 Agent 交互来自适应生成动作序列,从而避免因模型响应差异而导致的评测偏差。
实验
实验设计
PlayWorld 构建 171 个长程交互场景,每个场景带明确目标(如 360° 环视、涉水观察)。使用多模态 Agent Players 自主生成动作序列,避免固定动作跨模型不可比。评估采用 VQA Rubric Verifier 对四个核心维度打分:geometry consistency、interaction fidelity、out-of-sight evolution、insight evolution,并补充视频质量与可控性基础指标。实验覆盖 9 个 SOTA 世界模型。
关键发现
- 当前模型在长程交互目标上可靠性不足,尤其空间一致性与持续状态演化弱。
- Agent 动作路径因模型而异,证实固定动作评估失效。
- 几何一致性差:场景元素漂移;交互保真度不足:物理响应失真;视野外状态难以维持。
- 人类验证显示 VQA 评分与人工判断一致,评估协议鲁棒。
对比解读
无传统数值基线,但横向对比 9 个模型显示:交互式评估暴露了静态评测遗漏的长期记忆与物理一致性短板。该基准为后续模型提供统一度量,推动从短时生成向长程交互演进。
行业影响
落地场景
PlayWorld 可服务于所有需要交互式视频世界模型的产品线。典型场景包括:
- 自动驾驶仿真:世界模型生成动态驾驶场景,PlayWorld 评测其长期几何一致性(如绕车 360 度观察)和视线外演化(车辆驶离后场景状态是否合理保持),用于筛除会产生空间漂移或瞬移的模型。
- 电商虚拟试穿 / 场景展示:用户通过动作操控虚拟相机,查看商品在不同角度、光照下的表现。PlayWorld 的交互保真度与几何一致性指标直接对应消费者体验,能自动发现模型“换视角就变形”的问题。
商业价值
核心价值在降低人工评测成本和加速模型迭代。世界模型长程交互测试通常依赖人工标注或固定动作序列,PlayWorld 提供可复现的 Agent Player 自动化流程,减少对稀缺专家评测的依赖。量化指标(几何一致性、交互保真度、视线外演化)可作为模型发布前的质量门禁,避免因空间不一致导致用户体验下降带来的投诉与流失。对于提供世界模型 API 的厂商,PlayWorld 可支撑内部 leaderboard,帮助定位模型短板,节省大量试错时间。
与现有工作流接口
PlayWorld 以 Python 库形式发布,提供Agent Player 接口和VQA Rubric Verifier,可集成到模型训练或服务流程:
- 在 CI/CD 中作为评测 stage:每次模型更新后,用 PlayWorld 的 171 个场景自动回归关键维度分数。
- 接入模型 registry:将 PlayWorld 分数与模型版本绑定,便于筛选最优 checkpoint。
- 与现有 video quality 指标(FVD、PSNR 等)互补:基础能力评测与长程交互评测并行,提供全面报告。
局限
- **依赖 Agent Player 能力上限**:该基准使用多模态智能体替代人类玩家执行长跨度目标交互,但智能体自身在视觉理解、动作规划与长序列记忆方面能力有限,可能无法充分探索世界模型的状态空间,导致评估充分性受限。作者虽通过 Agent Player Analysis 验证可靠性,但不同智能体选择会显著影响评测结论,缺少对智能体鲁棒性的系统消融。
- **自动评估器引入噪声**:四个核心维度依赖 VQA Rubric Verifier 自动打分,VQA 模型对几何一致性、交互保真度等抽象概念的判定存在偏差,且与人类感知存在差距。文中进行了 Human Validation,但仅在小规模上验证相关性,未在大规模场景中校准,自动评分可能掩盖模型间的细微差异,且无法评估 VQA 失败案例。
- **场景与交互覆盖有限**:PlayWorld 提供 171 个场景,但主要基于现有视频生成模型的常用环境(如自然场景、物体操控),覆盖的世界模型类型和交互模态仍有限,缺少驾驶、机器人、游戏等真实交互环境的扩展,限制了基准的通用性。此外,长跨度目标由人工预定义,可能无法完全捕捉真实用户开放式探索需求。