通过世界模型扩展自动研究智能体
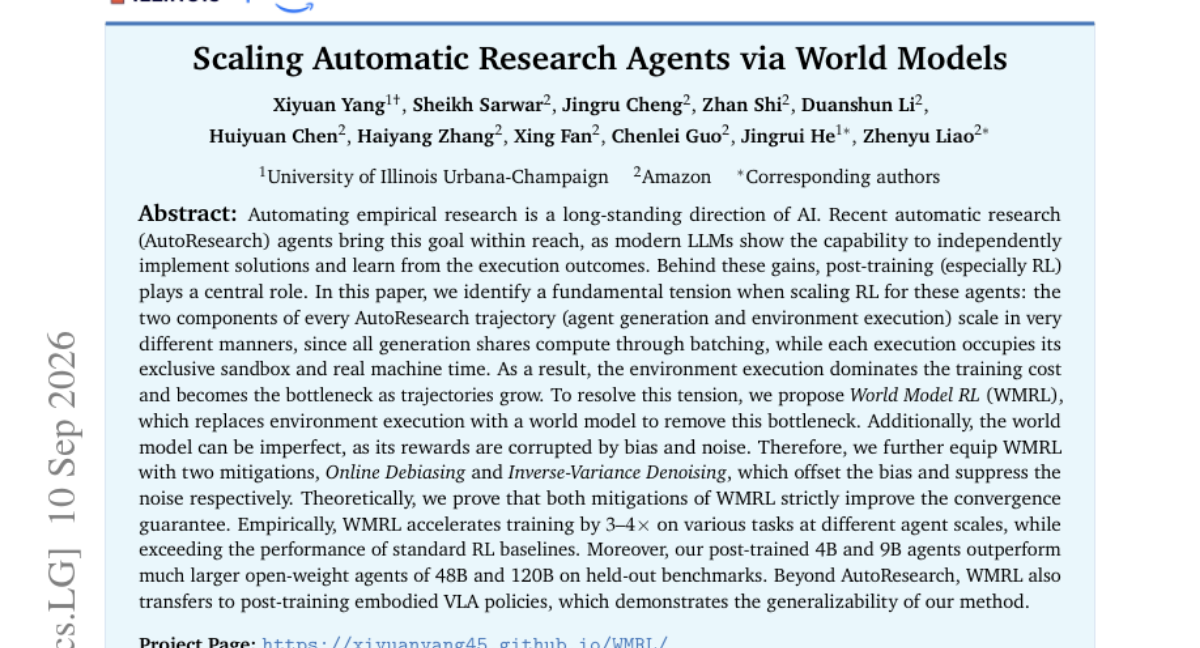
自动实证研究 是 AI 领域的长期方向。近期的 AutoResearch 智能体让这一目标触手可及,现代 LLM 已能独立实现解决方案并从执行结果中学习。其中后训练(尤其是 RL)起核心作用。本文指出,在扩展这类智能体的 RL 时存在一个根本性矛盾:每条 AutoResearch 轨迹的两个组成部分(智能体生成 与 环境执行)的扩展方式截然不同——所有生成通过批处理共享算力,而每次执行都独占沙箱与真实机器时间。因此 环境执行 主导训练开销,并随轨迹增长成为瓶颈。 为化解该矛盾,我们提出 World Model RL(WMRL),用 世界模型 替代环境执行以消除瓶颈。世界模型允许不完美,其奖励会被偏差与噪声污染,因此我们进一步为 WMRL 配备两项缓解措施:Online Debiasing 与 Inverse-Variance Denoising,分别抵消偏差、抑制噪声。 理论上,我们证明 WMRL 的这两项缓解措施均能严格改进收敛保证。实验中,WMRL 在不同智能体规模的多类任务上 加速训练 3–4 倍,同时性能超过标准 RL 基线。此外,我们后训练得到的 4B 与 9B 智能体在留出基准上超越了更大的 48B 与 120B 开源权重智能体。除 AutoResearch 外,WMRL 还可迁移到 具身 VLA 策略 的后训练,体现了方法的通用性。
论文精读
TL;DR 本文提出 World Model RL,用可学习的**世界模型**替代昂贵的真实环境执行,并通过**在线去偏**与**逆方差去噪**修正世界模型误差,将 AutoResearch 智能体的 RL 训练加速 3-4 倍,性能超越更大规模模型。
问题
问题背景: AutoResearch agents 利用 LLM 后训练(尤其是 RL)自动化实证研究,成为 AI 研究基础设施的新焦点。
现有方法局限: 标准 RL 中,每个 trajectory 包含 agent generation(可批量共享 GPU 计算)与 environment execution(独占 sandbox 和真实机器时间,不可批量)。两者扩展方式截然不同:generation 随 batch size 分摊成本,而 execution 成本线性累加。因此随着 trajectory 数量增长,environment execution 迅速占据训练总成本的主导地位,成为吞吐瓶颈。现有方案要么减少环境交互(降低样本效率),要么加速沙箱(受限硬件能力),均无法从根本上解耦这一失衡。
为什么难/重要: 核心矛盾是生成与执行在计算模式上的不匹配,这是系统层面的问题,难以通过简单调参解决。若直接使用 world model 替代环境执行,可以消除瓶颈,但 world model 的奖励预测存在偏差(系统误差)和噪声(方差),若不加处理会削弱 RL 收敛保证。因此需要同时解决“加速”与“奖励保真”两个相互制约的问题。业界对 AutoResearch、embodied VLA 等后训练任务需求强烈,降低环境交互成本是规模化部署的关键。
行业类比: 类似自动驾驶仿真:用学习到的环境模型替代真实路测可大幅加速策略迭代,但仿真与现实的差距必须通过在线修正来弥补。
核心洞察
- AutoResearch 强化学习训练中,agent generation 与环境 execution 的 scaling 特性截然不同:generation 通过 batching 共享算力,而每个执行独占 sandbox 和真实机时,导致环境执行成为训练成本瓶颈。WMRL 首次将这一张力显式化,并用 world model 替代环境执行消除瓶颈,与以往将环境与 agent 视为整体优化的 RL 方法形成对比,直接解决 scaling 瓶颈问题。
- 针对 world model 不完美引入的 bias 和 noise,WMRL 提出 Online Debiasing 与 Inverse-Variance Denoising 两种修正策略,理论上证明这两种策略严格改善收敛保证,而不仅是经验性技巧。这种可证明的修正机制使得用 world model 替代真实环境在 RL 中可行,并带来 3-4 倍加速,且小模型(4B/9B)超越大规模模型(48B/120B)的性能,展示了训练方法创新对模型效率的杠杆作用。
方法
方法核心:World Model RL (WMRL)
输入:AutoResearch 任务的轨迹数据,包含 agent 生成的解决方案(代码/文本)和对应的环境执行结果(如测试通过率、运行日志等)。在标准 RL 中,每条轨迹都需要真实 sandbox 执行。
关键模块:
- 世界模型替代环境执行:训练一个世界模型(如 LLM)来预测给定 agent 生成内容的执行结果,替代真实 sandbox。由于所有生成共享批量计算,而真实执行独占资源,世界模型推理可批量并行,消除环境执行瓶颈。
- Anchor Signal 与 Online Debiasing:世界模型的奖励存在系统偏差。WMRL 利用一个锚点信号(例如周期性少量真实环境执行的结果,或一个高精度参考模型)在线估计世界模型输出的偏差,并将其从奖励中减去,实现去偏。
- Inverse-Variance Denoising:世界模型输出的噪声(不确定性)可以通过其预测方差估算。WMRL 对世界模型奖励按其逆方差加权,降低高噪声样本对梯度更新的影响,抑制噪声。
输出:经过偏差校正和噪声抑制的奖励信号,用于策略梯度更新(如 PPO 等),驱动 agent 模型优化。
与同类方法差异:与直接使用世界模型作为环境(naive world model RL)不同,WMRL 显式建模世界模型误差的统计特性(偏差与方差),并通过在线去偏和逆方差去噪进行校正,从而在加速训练的同时保证甚至提升最终策略性能。
实验
实验设计
论文在 AutoResearch 任务上对 WMRL 与标准 RL 基线进行对比,覆盖不同规模的智能体(4B、9B 等)。基准包括 DSBench 以及 held-out 测试集。此外,在 embodied VLA policies 上验证方法的泛化能力。训练使用相同的 RL 框架,仅将环境执行替换为世界模型,并加入 Online Debiasing 和 Inverse-Variance Denoising 两种缓解策略。
关键发现
WMRL 在多种任务和智能体规模上实现 3-4× 的训练加速,同时超越了标准 RL 基线的性能。后训练得到的 4B 和 9B 智能体在 held-out 基准上表现优于 48B 和 120B 的开放权重智能体。消融实验证实两种缓解策略对性能有显著贡献。
基线对比解读
标准 RL 的成本瓶颈在于环境执行占用独占沙盒和真实机器时间,而 WMRL 用世界模型替代环境后消除了这一瓶颈,因此能获得加速。世界模型的不完美(偏差和噪声)通过去偏和去噪得以控制,理论证明这两种策略严格改进收敛保证,与实验中的性能提升一致。这一方法还成功迁移到 embodied VLA,表明其可扩展性。
行业影响
落地场景
World Model RL (WMRL) 主要适用于需要大量环境交互的后训练 RL 场景。典型用例:
- 自动研究 agent(AutoResearch):在企业内部用于自动化机器学习实验、超参搜索、代码生成与验证。例如,电商搜索团队用 agent 自动迭代排序模型,world model 模拟线上反馈,降低沙箱调用成本。
- 具身智能:训练视觉-语言-动作(VLA)策略时,用 world model 替代高保真物理仿真器,加速机器人策略学习。
商业价值
- 降本:环境执行(代码沙箱、物理仿真)通常占据 RL 训练 80% 以上成本,WMRL 用 world model 替代独占资源,训练吞吐提升 3–4 倍。
- 增效:更快的迭代让团队在相同时间内尝试更多想法,缩短模型研发周期。
- 性能杠杆:论文展示 4B / 9B 后训练 agent 超过 48B / 120B 开源模型,意味着小模型配 WMRL 可达到大模型效果,显著降低推理与部署成本。
与现有产品的接口
- 在现有 agent RL 框架(如
TRL、OpenRLHF、veRL)中,环境交互通常通过EnvClient调用沙箱/仿真器;可替换为WorldModelClient,保持接口不变。 - 需集成两个组件:在线去偏(Online Debiasing)利用少量真实环境 anchor 信号校正 reward 偏置;逆方差去噪(Inverse-Variance Denoising)根据 world model 预测方差加权 reward。
- 生产部署保留 5–10% 真实环境执行用于校准,监控 world model 漂移,必要时回退到标准 RL。
论文已开源:WMRL GitHub 与项目主页,便于直接集成实验。
局限
- **世界模型可靠性**:本文假设世界模型可以替代真实环境,但世界模型本身需要训练数据,且对于复杂、开放任务难以精确建模。所提出的 Online Debiasing 和 Inverse-Variance Denoising 依赖于 anchor signal 来估计偏差和噪声,但 anchor 的数量、分布及随时间的变化可能影响校正效果,实际部署中难以保证估计的准确性。此外,论文未讨论世界模型的推理开销是否可能成为新的计算瓶颈,尤其在环境状态维度较高时。
- **实验范围相对有限**:论文主要在 AutoResearch 基准(如 DSBench 等)上验证,并迁移到 embodied VLA 策略,但任务环境可能相对受限。对于多智能体协作、长期规划、需要丰富感知能力的任务,世界模型的构建难度更大,方法有效性有待进一步检验。另外,与 48B/120B 更大模型对比时,可能受限于基准任务难度,未能充分展示在大规模、开放任务上的优势。
- **对比基线不足**:论文虽然指出了标准 RL 中环境执行瓶颈,但与现有 model-based RL 方法(如 Dyna-style、MuZero)或最近在 LLM post-training 中使用世界模型的工作(如 LLM 作为模拟器)缺乏充分实验对比。这使得读者难以判断 WMRL 相对于已有方法的实际增益,特别是这些方法也可能通过减少真实环境交互来加速训练。