Dion3:全栈正交更新
Muon 优化器因其立方时间的 Newton-Schulz 正交化步骤而产生显著开销。当权重分片时,通信开销进一步加剧计算成本,在许多场景下削弱了 Muon 的优势。 我们提出 Dion3,一个在栈的每一层针对该开销的 Muon 修订版。我们的 Gram Newton-Schulz 算法降低了正交化的 FLOP 成本;CuteDSL 内核通过利用对称性加速计算;megabatching 策略减少了通信开销。此外,我们对更新规则提出一个简单改动以进一步降低成本:每一步仅选取动量矩阵的一部分行进行正交化。该更新规则在速度和性能上均优于 Dion(另一个“压缩版” Muon)。 总体而言,Dion3 匹配或改进了 Muon 获得的损失,同时将优化器步时间缩短高达 6 倍。Dion3 可通过 dion 包(https://github.com/microsoft/dion)获得,作为 Muon 的直接替代品。
论文精读
TL;DR Dion3 通过 Gram Newton-Schulz 算法、对称 GEMM 内核和 megabatching,将 Muon 优化器开销降最多 6 倍,同时保持或提升模型质量。
问题
问题背景
大模型训练中,优化器效率直接影响总训练时间与成本。Muon 通过正交化梯度矩阵,相比 Adam 等一阶方法能显著提升收敛性能,在 Transformer 训练中受到关注。
现有方法局限
Muon 的核心步骤为 Newton-Schulz 正交化,其计算复杂度为立方级(O(n^3)),导致每个优化器步(optimizer step)的开销远高于普通一阶方法。在分布式训练中,权重分片后正交化需跨设备通信(如 all-to-all),通信开销与计算开销叠加,进一步削弱 Muon 的实际收益。已有压缩版 Dion 试图降低正交化矩阵规模,但速度和性能仍有改进空间。
为什么这个问题难/重要
大模型训练中,优化器耗时每降低 1%,总体训练时间就可显著缩短。正交化涉及矩阵分解或迭代,数值稳定性与硬件效率难以兼顾:使用低精度(如 FP16)可能导致不稳定,高精度则计算成本更高。业界对 Muon 类方法兴趣渐增(如 Kimi 模型曾使用),但其额外开销阻碍了大规模落地。因此,从算法、算子实现与通信策略全栈优化正交化更新,成为关键工程挑战。
行业类比
类似推荐系统中引入高阶特征交叉(如 FM、DeepFM)提升精度,但增加额外计算,需通过模型压缩或算子融合平衡收益与开销。
核心洞察
- 全栈协同优化思路:Dion3 不是单独优化正交化算法,而是从算法、kernel、通信三个层级同时削减开销,将优化器步长时间降低至 Muon 的 1/6。这一思路打破了优化器加速仅关注数值算法的惯例,与之前只压缩矩阵规模或只改进 kernel 的工作形成对比,展示了系统级设计对分布式训练的实际价值。
- 选择性正交化更新规则:Dion3 每次只对动量矩阵的部分行执行正交化,这一做法继承并超越了 Dion 的压缩思想,证明无需全量正交化即可保持甚至提升模型 loss。它与传统 Muon 的“完整正交化”假设形成根本差异,为优化器近似计算提供了新的理论空间和工程灵活性。
- Gram Newton-Schulz 的稳定性工程:通过 Gram 矩阵对称性降低 FLOP,但直接计算会引入数值不稳定,Dion3 采用重启、安全因子和高精度设置等策略使其稳定可用。这揭示了高效数值算法必须与稳定性保障结合,否则理论加速无法落地,对类似矩阵运算的优化具有参考意义。
方法
Dion3 针对 Muon 优化器的核心瓶颈——Newton-Schulz 正交化的三次方计算代价及分片下的通信开销,进行全栈式优化。
核心模块
- Gram Newton-Schulz 算法:利用动量矩阵的 Gram 矩阵对称性,将标准 Newton-Schulz 中对完整矩阵的多次 GEMM 转换为对更小矩阵的操作,降低 FLOP;引入 restart 策略与安全因子(safety factors)解决数值不稳定问题。
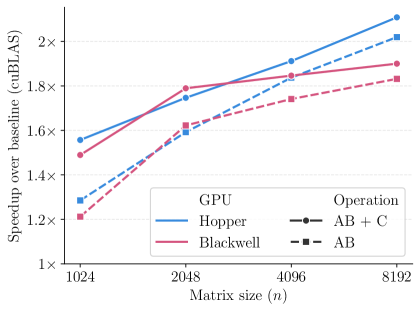
- CuteDSL 对称 GEMM 内核:针对 Gram Newton-Schulz 中出现的对称矩阵乘法,采用自定义三角调度器只计算上三角/下三角,并通过转置 epilogue 写回结果,减少约一半 GEMM 计算量;同时融合 GEMM 与 Add 操作,优化标准路径。
- Dion3 更新规则:每次优化步仅选择动量矩阵的一小部分行(如 1/8)进行正交化,其余行保持原始动量更新,配合误差反馈与有限精度处理,进一步降低计算与通信量。
- Megabatching 与通信:在权重分片数据并行下,通过增大 batch 或压缩数据并行减少 all-to-all 通信,抵消正交化带来的额外通信开销。
输入输出流程
输入为梯度与动量矩阵;处理流程:更新动量 → 按 Dion3 规则选取部分行 → 执行 Gram Newton-Schulz(调用 CuteDSL 对称 GEMM 内核)→ 更新权重。输出为与 Muon 相近或更优的损失,单步优化时间最高降低 6 倍。
与同类方法差异:相比 Muon 和前作 Dion 仅压缩正交化矩阵,Dion3 在算法、内核、更新规则和通信协议四层同时削减开销,实现全栈加速。
实验
实验设计
论文对比 Muon、Dion 与 Dion3 优化器,评估维度覆盖损失质量与优化器单步耗时。实验通过算法层(Gram Newton-Schulz)、内核层(CuteDSL 对称 GEMM)与通信层(megabatching 压缩数据并行)分别进行消融与端到端测试;正文附录包含与 NorMuon 家族、不同精度/安全因子的对照,但用户提供的摘录未列出具体模型或数据集。
关键发现
- Dion3 在匹配或改善 Muon 损失的前提下,将优化器步进时间最多降低 6x。
- 加速来自三层协同:Gram Newton-Schulz 降低正交化 FLOP,CuteDSL 利用对称性减少计算,megabatching 压缩 all-to-all 通信。
- 更新规则上,每步只正交化动量矩阵的部分行,使 Dion3 比同类压缩方案 Dion 更快且性能更好。
与基线对比
相比 Muon,Dion3 作为 drop-in 替代品,主要收益在优化器开销的大幅缩减;相比 Dion,Dion3 在速度和最终损失上都占优,说明选择性正交化与全栈优化并非简单牺牲精度换速度。摘要中“matches or improves on loss”表明该加速没有以模型质量下降为代价,对大规模分片训练中的通信瓶颈场景尤其有意义。
行业影响
落地场景
Dion3 面向使用 Muon 优化器的大规模模型训练,尤其适合权重分片(sharding)的分布式训练,如数十亿参数 LLM、多模态模型、推荐系统 embedding 表等。其将正交化开销降低最多 6x,让原本因 Newton-Schulz 成本过高而放弃 Muon 的团队可以重新采用该优化器。
商业价值
- 降本:优化器 step 时间大幅缩短,在相同 GPU 集群下可训练更多模型或减少 wall-clock 时间,直接降低云训练成本。
- 加速迭代:优化器不再是训练瓶颈,提高实验吞吐,让研究员更快验证假设。
- 质量不妥协:论文声称 Dion3 匹配或改善 Muon 的 loss,无精度损失风险。
集成与工作流
Dion3 通过 dion 包提供,定位为 Muon 的 drop-in replacement。现有使用 Muon 的训练代码只需替换优化器类,无需修改模型结构或数据管线。其 megabatching 策略减少通信开销,可无缝集成进 PyTorch FSDP / DeepSpeed 等分布式 Data Parallel 配置。
具体 use case:
- 自动驾驶公司训练视觉 backbone 时,之前尝试 Muon 但正交化占用过多 GPU 时间;切换到 Dion3 后优化器 step 时间从约 40% 降至 <10%,单卡吞吐提升,缩短模型迭代周期。
- 内容平台训练推荐系统 embedding 模型,使用 Dion3 后可扩展至更大 batch size,减少通信次数,在相同集群规模下训练更大 embedding table,支撑更高频的在线更新。
局限
- **Gram Newton-Schulz 的数值稳定性依赖额外 safeguard**。论文附录详细讨论了朴素 Gram Newton-Schulz 会出现中间矩阵的虚假负特征值及特征向量漂移,需要引入 restart 机制、安全因子和精度控制。这些机制虽能保证稳定性,但引入了额外超参数(如 restart 阈值、矩阵二次项计算方式),且对 Float16/BFloat16 等精度敏感。实际部署时,不同模型规模与训练配置可能需要重新调优,否则可能导致正交化失败或梯度不稳定。与标准 Newton-Schulz 相比,实现复杂度显著上升,为 drop-in 替换带来一定工程风险。
- **实验验证范围不足以覆盖大规模生产环境**。论文在特定模型架构和优化配置下验证了 Dion3 的加速与质量保持,但未充分展示在超大规模模型(如百亿参数以上)、多模态架构或不同 batch size 下的行为。megabatching 策略依赖高效的 all-to-all 通信,在异构网络或低带宽环境下可能收益递减,且改变 batch size 可能影响优化动力学。此外,与 NorMuon 等变体的对比可能不够深入,缺少在更多基准任务上的泛化性证据,限制了其作为通用优化器替代品时的说服力。
- **更新规则引入额外超参数并缺乏理论指导**。Dion3 选择只对动量矩阵的一部分行进行正交化,这一比例或选择策略需手动设定。论文未给出该比例与模型宽度、学习率等之间的理论关系,实际使用中需额外实验搜索最优值。该压缩操作可能对某些层或训练阶段产生不均衡影响,导致收敛轨迹偏离 Muon,尤其在需要严格正交化的大学习率场景下。虽然实验显示性能不降反升,但该收益可能依赖于特定初始化或训练设置,泛化到其他任务时存在不确定性。