MBA: 面向真实世界商业构思的多模态基准与智能体
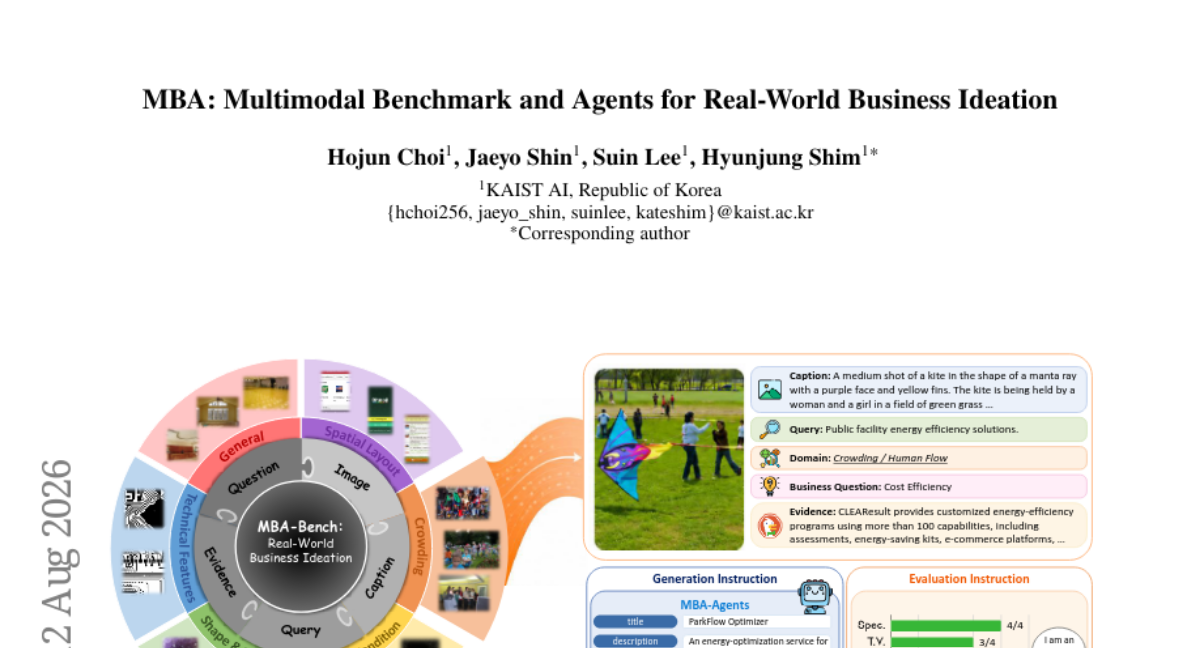
摘要 由大型语言模型(LLM)驱动的智能体系统为商业构思开辟了新机遇。然而,现有方法仍局限于纯文本范式,忽视了真实世界情境固有的多模态特性。为此,我们引入 MBA-Bench,这是首个用于训练和评估商业构思智能体的多模态基准,包含六个领域的 30K 样本,每个领域都有文本无法完全传达的独特视觉线索。具体来说,我们自动为图像添加描述,并使用 GPT-4o 通过检索查询生成、市场证据检索和证据增强合成,为每个商业问题生成五个参考点子。 参照先前工作,我们使用 MLLM-as-a-Judge 在六个面向商业的标准上评估智能体。考虑到标准隐藏或公开的设置,我们分别提出 MBA-b 和 MBA-k 对应盲测和已知标准。两者均使用两种新颖的奖励目标——创造力 和 可行性 进行训练,而 MBA-k 还额外优化六个公开标准,共八个目标。 两种模型均通过基于 LoRA 的监督微调,随后使用这些特定于设置的奖励进行 群体相对策略优化(GDPO) 训练。在 MBA-Bench 上的大量实验中,我们设置了两个基线:仅描述输入和多模态输入,后者在多项指标上接近闭源模型性能。MBA-b 和 MBA-k 分别比描述基线高出 63.9% 和 77.1%,比多模态基线高出 25.6% 和 35.8%。
论文精读
TL;DR 首个多模态业务创意基准 **MBA-Bench**(30K 样本、6 域)配合 **MBA-b** / **MBA-k** 智能体,用创造性与可行性奖励训练后,较最强基线提升 25.6%–35.8%。
问题
问题背景
AI 辅助商业创意生成正随 LLM-based agent 能力提升而受到关注,但当前研究主要停留在纯文本范式。
现有方法局限
- 现有 benchmark 与 agent 仅处理文本输入,忽略真实商业场景中广泛的视觉信号,如产品图、UI 截图、市场图表、缺陷检测图像等。
- 缺乏多模态训练数据与标准化评估,导致视觉线索丢失,无法验证 agent 在视觉驱动商业问题上的表现。
- RL 后训练普遍优化通用文本质量,未针对商业创意特有的创造力 与可行性 设计奖励函数,评估也依赖单模态 LLM-as-a-Judge。
为什么这个问题难/重要
商业创意生成要求跨模态证据整合:从商品外观、界面布局、市场图表中提取需求,再综合为可执行方案,既考验视觉理解又考验商业推理能力。文本检索增强无法弥补视觉信号缺失;构建多模态训练集需要大规模领域特定数据,设计可靠奖励需平衡主观性与客观指标,并避免模态偏差。业界对自动化产品创新、市场调研、竞品分析需求强烈,但缺少统一评测基准与开源 agent。
行业类比
类似多模态电商场景:根据商品图片与用户评论中的图像自动生成选品或营销创意,纯文本方案会产生明显盲区。
核心洞察
- MBA-Bench 首次将业务创意评估从纯文本拓展到多模态场景,通过自动 caption 图像和 GPT-4o 生成参考想法,并引入检索增强确保想法有市场证据支持。与以往仅依赖文本的基准相比,该基准覆盖六个视觉特征差异显著的领域,能验证模型是否真正利用视觉信息而非仅依赖描述。数据合成管线可扩展,为后续多模态业务智能研究提供统一评测基础。
- MBA-b 和 MBA-k 分别针对盲评和已知评价标准训练,使用创造力和可行性两个通用奖励,MBA-k 还额外拟合六个具体标准。GRPO 组相对策略优化利用样本间排名信号,避免绝对分数噪声。这种设计区分通用创意能力与特定目标优化,实际部署时可先训练 MBA-b 获取稳健通用性能,再根据业务方给定的 KPI 微调 MBA-k,工程上节省数据标注成本。
方法
整体流程:输入图像与问题 → 多模态证据链 → 评估与训练代理
MBA-Bench 的构建以图像和三个业务问题为输入。数据生成分为三步:自动为图像生成 caption,并利用 GPT-4o 通过检索查询生成、市场证据检索(基于 OpenAlex / Wikidata 等外部知识库)和证据增强合成,为每个问题生成五个参考创意。最终得到 30K 样本、六个领域,每个领域包含纯文本无法充分表达的视觉线索(如工业缺陷、UI 布局等)。
评估环节采用 MLLM-as-a-Judge,对代理输出按六个业务导向标准打分。训练时区分两种设置:MBA-b(盲审标准隐藏)和 MBA-k(标准已知)。
关键训练模块
- 奖励设计:两个核心奖励——创造力和可行性;MBA-k 额外优化六个披露标准,共八项奖励。
- 监督微调(SFT):使用 LoRA 对问题-参考创意对进行指令微调,建立初步生成能力。
- 组相对策略优化(GRPO):基于上述奖励对候选生成结果进行相对排序,进一步强化代理偏好。
输出与差异
训练后的 MBA-b / MBA-k 分别在盲审与已知标准下运行,输出面向图像上下文的业务创意。相比仅接受文本 caption 或简单多模态输入的基线,该方法首次将 视觉证据与检索增强的创意生成 纳入统一训练框架,并同时优化创造力与可行性等多个奖励目标,显著超越纯文本 agent 范式。
实验
实验设计
论文构建 MBA-Bench 基准,含 30K 样本、六个视觉域(如 ADE20K、RICO 等),每个域具备文本无法完全传达的视觉线索。通过自动 caption 与 GPT-4o 为每个域的三类业务问题各生成五个参考想法,采用 MLLM-as-a-Judge 按六项业务标准评估。设置 blind(隐藏标准)与 known(公开标准)两种设定,对应 MBA-b / MBA-k。两模型均先 LoRA SFT 后 GRPO,奖励包括 creativity 与 feasibility,known 额外优化六项公开标准。基线包括 caption-only 与 multimodal 输入两种。
关键发现
MBA-b 与 MBA-k 显著超越 caption-only 基线 +63.9% / +77.1%,超越 multimodal 基线 +25.6% / +35.8%。多模态输入带来本质增益,而奖励设计与 GRPO 进一步拉大差距。known 设定因提前知晓评估标准,相对 blind 提升更高。
与基线对比解读
相较于仅用 caption 的基线,直接处理图像输入的 multimodal 基线已大幅接近闭源性能,但 MBA 系列通过定制奖励与策略优化进一步释放潜力。creativity 与 feasibility 奖励引导模型生成既新颖又可落地的想法,而 GRPO 的排序式优化相比 SFT 更能对齐业务导向的多维评价。blind/known 差异表明,评估标准透明时模型可以更有针对性地优化,但 blind 设定更符合真实场景中需求不明确的情况,其稳健性值得关注。
行业影响
落地场景
MBA-Bench 和 MBA-b / MBA-k 可直接用于需要多模态商业创意生成的产品,如电商商品卖点提炼、广告创意脚本生成、企业创新提案工具等。典型 use case:
- 电商选品与营销:输入商品图片、用户评论截图、市场趋势图表,生成多个差异化的营销文案与活动创意,辅助运营快速测试。
- 内容平台脚本生成:基于视觉素材(产品图、场景图)与平台热点数据,自动产出短视频脚本或直播话术,提升创意产出效率。
商业价值
核心价值在于降本增效:将多人参与的头脑风暴压缩为分钟级多方案生成,减少人力成本;通过 creativity 与 feasibility 奖励训练,模型生成的创意兼具新颖性与可落地性,避免天马行空;多模态输入能力使模型能利用文本无法传递的视觉线索,提高创意与真实场景的贴合度,间接提升营销转化。
与现有工作流集成
- 模块化嵌入:作为创意生成 agent,集成到现有 LLM 编排框架(如 LangGraph、AutoGen),接收上游检索到的市场数据与图像,输出候选创意。
- 评估闭环:采用 MLLM-as-a-Judge 评估,可无缝接入现有 LLM 评估流水线,对创意质量做自动化打分,支持 A/B 测试与持续优化。
- 训练适配:基于开源多模态模型(如 Qwen-VL、InternVL)做 LoRA 微调,GRPO 奖励可与现有 RLHF 基础设施结合,工程成本可控。
局限
- - **评判可靠性与同源偏差**:论文使用 **MLLM-as-a-Judge** 评估商业创意,但未验证其与人类专家或真实市场反馈的一致性。商业创意价值受时效、文化、执行环境等复杂因素影响,LLM 评判可能存在系统性偏见,导致训练目标偏离真实需求。此外,参考想法由 **GPT-4o** 生成,训练数据与评判模型同源,可能产生过拟合或自我强化,削弱基准的有效性与泛化性。
- - **领域与模态覆盖有限**:虽然覆盖六个领域(ADE20K、RICO、MS-COCO、VisA、DTD、DeepPCB),但这些领域多为静态图像数据集,视觉线索类型相对单一,难以完全代表真实商业场景中的多模态信息(如视频、图表、用户交互流等)。文本与图像之间的关联强度差异未充分分析,部分样本的图像信息可能是冗余或噪声,影响模型跨模态学习能力。与真实商业决策所需的动态数据流相比,该基准的生态效度尚显不足。
- - **训练成本与真实效果差距**:采用 **LoRA** 监督微调后接 **GRPO**,需要分组采样与奖励计算,训练流程复杂且计算开销大,复现门槛较高。奖励目标中的 **creativity** 和 **feasibility** 定义与量化方法虽在论文中描述,但实际落地时可能因领域差异而难以迁移。与闭源模型对比时,仅在部分指标接近,且未进行真实用户研究或 A/B 测试,商业价值转化效果仍不明确。