ReRound: 重建式舍入以解决免校准 LLM 量化中的中点歧义
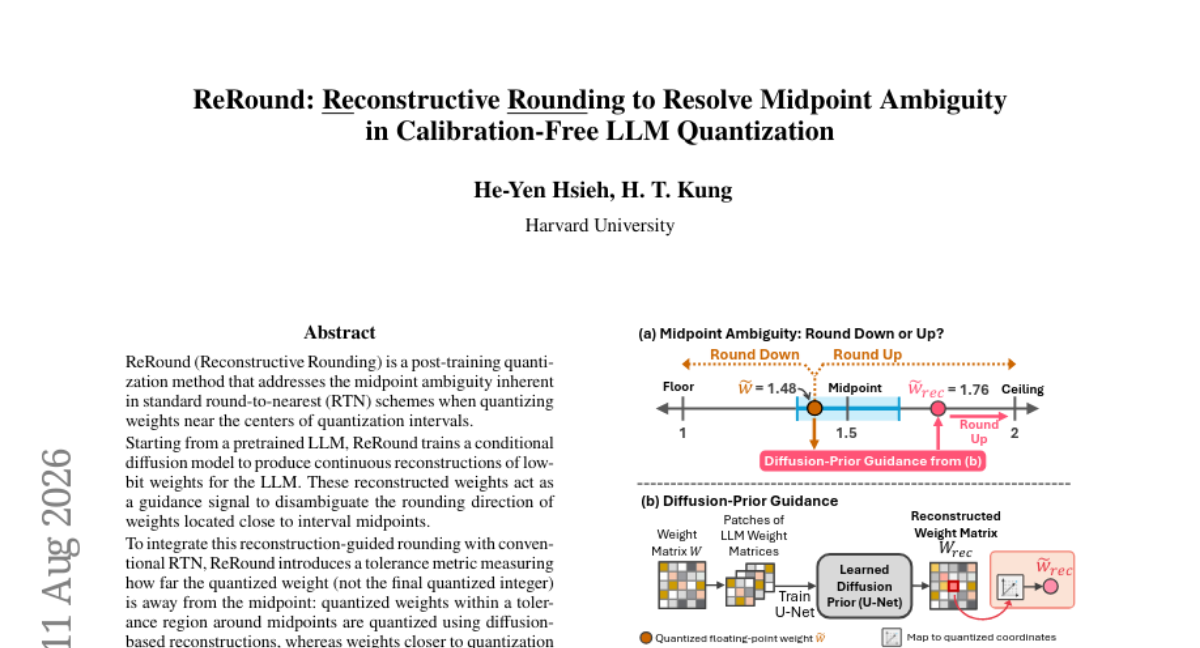
ReRound (Reconstructive Rounding) 是一种训练后量化方法,旨在解决标准舍入到最近 (RTN) 方案中,当权重接近量化区间中点时所固有的中点歧义问题。 该方法从预训练 LLM 出发,训练一个条件扩散模型来生成低比特权重的连续重建。这些重建权重作为指导信号,用于消除位于区间中点附近的权重的舍入方向歧义。为了将这种重建指导的舍入与常规 RTN 集成,ReRound 引入了一个容差度量,用于衡量量化权重(而非最终量化整数)离中点的距离:位于中点周围容差区域内的量化权重,使用基于扩散的重建进行量化;而更接近量化边界的权重则使用 RTN 量化。通过扫描容差参数,ReRound 生成多个候选量化整数权重矩阵,并选择前导奇异值与原始全精度权重最匹配的反量化权重矩阵。选中的候选矩阵决定了 ReRound 使用的容差参数。 ReRound 对较小的 LLM 特别有效。在一系列此类模型上,它在 3-bit 和 4-bit 权重量化中始终优于标准 RTN。与大量免校准方法相比,ReRound 取得了更优的精度,与依赖校准的方法相比也保持竞争力,并且完全离线运行,在低比特推理期间不引入任何额外开销。 ReRound 策略代表了低比特量化的一种新方法,适用于 LLM 之外的 AI 模型。本文重点研究其在小型 LLM 上的应用。
论文精读
TL;DR ReRound 用条件扩散模型重建低比特权重,引导中点附近权重的舍入方向,在不需校准数据的情况下提升小模型 3/4-bit 量化精度,且推理零开销。
问题
问题背景
LLM 部署中,低比特权重量化是降低内存占用与加速推理的核心手段。其中 post-training quantization (PTQ) 无需重训练,尤为实用;而 calibration-free 方法因不需要校准数据集,在隐私敏感或快速部署场景下更受关注。
现有方法局限
标准 round-to-nearest (RTN) 在量化区间中点处存在方向模糊:权重值恰好位于两个量化代表值之间时,四舍五入的任意选择会引入系统性偏差。虽然 calibration-based 方法(如 GPTQ、AdaRound)可通过校准数据优化舍入方向,但 calibration-free 方法缺乏误差信号,无法修正这些中点决策;而权重分布往往在中点附近较为密集,导致量化误差累积。已有的 calibration-free 改进(如 HQQ、Hadamard 变换 RTN)主要调整权重分布或量化策略,并未直接解决中点模糊这一根本问题。
为什么这个问题难/重要
中点附近的权重对模型输出影响较大——它们位于量化区间的过渡区域,微小的舍入方向变化可能显著改变激活分布。然而缺少校准数据时,无法评估每个舍入决策对最终损失的影响,只能依赖全局规则或启发式。业界对边缘设备上的低比特推理需求持续增长,calibration-free 方法的精度提升具有实际价值,尤其是在无法获取代表性校准集的生产环境中。
行业类比
类似无标签数据下的半监督学习,需要借助生成模型提供的先验来弥补监督信号缺失;ReRound 用条件扩散模型重建权重作为“伪标签”,指导中点舍入方向。
核心洞察
- - ReRound 将条件扩散模型用作“舍入决策器”而非“参数替代器”,通过生成连续重建来指导中点附近权重的舍入方向,而非直接采用重建权重。这一角度独特之处在于:现有舍入优化方法(如 AdaRound、SignRound)通常依赖校准数据拟合每层的舍入变量,而扩散模型的生成先验来自预训练权重分布,无需任何校准样本,且只干预最模糊的决策点,保留 RTN 在大部分权重上的简单性。
- - 容差参数与谱保持选择机制构成一种低成本的超参数自动调优策略,通过扫描容差并比较候选量化矩阵的前几个奇异值与原始权重的匹配度来确定阈值。与现有方法手动设置或基于任务损失搜索不同,该策略直接在权重矩阵的空间结构上评估舍入质量,避免了推理或校准开销,且对小模型特别有效,因为小模型对量化误差更敏感,谱保持能保留关键方向。
方法
输入与总体流程
ReRound 以预训练 LLM 的全精度权重矩阵为输入,全程不需要任何校准数据。方法分为三阶段:先训练一个条件扩散模型学习权重重建先验,再利用重建结果引导舍入方向,最后通过容差扫描与频谱匹配确定最终量化参数。
条件权重重建
对权重矩阵分块(weight patch),训练一个条件扩散模型。该模型以低比特量化后的 patch 为条件,逐步去噪生成对应的连续重建 patch。训练目标是最小化重建权重与原始全精度权重之间的误差,使扩散模型能捕捉权重分布与低比特量化失真之间的规律。推理时,给定任意权重 patch 及其低比特版本,模型输出连续重建值,作为“更优舍入目标”的参考。
重建引导舍入与容差机制
对每个权重,先计算其与量化区间中点的距离 d。若 d 小于预设容差 tau,说明该权重位于中点邻近区域,RTN 决策存在歧义,此时依据重建权重相对于中点的方向决定向上或向下舍入;若 d 大于等于 tau,则直接采用标准 RTN。容差 tau 是一个可调参数,控制仅对最模糊的权重施加重建引导。
候选生成与频谱保持选择
在容差参数 tau 的取值范围内进行扫描,每个 tau 生成一个候选量化整数权重矩阵。对每个候选进行反量化,计算其前导奇异值,并与原始全精度权重的前导奇异值比较,选择谱距离最小的候选所对应的 tau。这一选择机制确保量化后权重矩阵在全局谱特性上尽可能保留原始模型的信息。
输出与推理
最终输出为低比特整数权重矩阵,可直接加载到推理引擎中,反量化到浮点用于计算。推理阶段没有额外模块或延迟。
与同类校准依赖方法(AdaRound、GPTQ)不同,ReRound 的舍入决策完全由扩散生成先验和频谱保持驱动,无需任何校准数据集,离线一次性完成。
实验
实验设计
针对小规模 LLM 进行校准无关的 3-bit / 4-bit 权重量化评估。ReRound 先训练条件扩散模型生成连续权重重建,再结合 RTN 对中点附近权重进行重建引导舍入;通过扫描 tolerance 参数生成多个候选量化矩阵,以主导奇异值匹配原全精度权重为标准选择最优 tolerance。对比基线包括标准 RTN、HQQ、BNB FP4、Hadamard 变换 RTN、GPTQ、AdaRound、SignRound 等校准无关与校准依赖方法;并包含组件消融、替代量化参数、额外模型离线运行时间实验。
关键发现
- ReRound 在 3-bit / 4-bit 权重量化上持续优于标准 RTN,对小模型效果尤为明显。
- 在广泛的校准无关方法中取得更优精度,与校准依赖方法(如 GPTQ、AdaRound)相比具有竞争力。
- 方法完全离线,低比特推理阶段无额外计算或内存开销。
对比解读
ReRound 的核心差异在于利用条件扩散模型生成重建权重,以消除 RTN 在量化区间中点处的舍入歧义。传统校准无关方法通常依赖静态规则或有限校准集;ReRound 无需校准数据,却能通过重建引导实现更精细的舍入决策。该方法只需离线训练扩散模型和一次容差扫描,推理时仍为普通 INT 矩阵乘法。对于资源受限的小模型部署,这提供了一种新的校准无关量化路径,但扩散模型训练成本与候选扫描时间需在实际应用前评估。
行业影响
落地场景
ReRound 面向 小规模 LLM(1B-7B 参数)的 低比特量化,适合边缘设备、CPU 服务器和成本敏感型部署。典型用例:
- 电商智能客服:将 3B 级对话模型量化到 4-bit,运行在商品推荐交互或售后问答的轻量级服务中,显著降低内存占用与推理延迟。
- 医疗病历摘要:医院内部署的小型生成模型,因隐私限制无法采集外部校准数据,校准免费 的 ReRound 可在完全离线状态下完成量化,满足合规要求。
商业价值
ReRound 直接降低硬件成本:量化后模型内存缩小约 4 倍(FP16 → 4-bit),可减少 GPU 或高内存 CPU 需求,提升单机并发吞吐。由于 推理阶段无额外开销(与标准量化模型一致),延迟与能效不受影响。相比校准依赖方法(如 GPTQ、AWQ),ReRound 省去校准数据收集和调优时间,加速模型上线流程。在精度上优于 RTN 等校准免费基线,并接近校准方法,因此可减少量化引起的业务错误,提升用户信任。
集成接口
ReRound 可作为 后训练量化流程中的替代步骤,替换标准 RTN。集成方式:
- 输入原始 FP16 权重;
- 训练一个 条件扩散模型(针对目标 LLM 的权重重建器);
- 扫描容差参数生成多个候选量化权重,依据 奇异值谱匹配 选择最优;
- 导出标准量化整数矩阵,接入现有推理引擎(如
TensorRT-LLM、llama.cpp)。
可以封装为 Optimum 扩展或独立工具链,与主流 MLOps 流水线(如 MLflow、Kubeflow)对接。项目主页 ReRound 提供源码。
局限
- 训练条件扩散模型的开销较大:ReRound 需要为每个待量化模型训练一个条件扩散模型,虽然推理时无额外开销,但训练阶段的算力和时间成本显著高于传统校准无关方法(如 RTN)甚至部分校准方法。论文只在较小 LLM 上验证,可能因为扩散模型训练在更大模型上不可行或收益下降。这限制了其在资源受限环境下的实用性,且目前缺乏与其他扩散模型蒸馏/加速技术的结合。
- 仅在较小 LLM 上有效:论文明确表示 ReRound 特别适用于较小 LLM,对大型模型效果未验证。这可能是由于扩散模型重建权重的能力随参数规模增大而减弱,或者候选选择使用的谱匹配准则在高维空间中不够稳定。这种规模局限性使得该方法目前不能作为通用 PTQ 方案,与许多可扩展至百亿参数模型的方法(如 GPTQ、AWQ)相比存在差距。
- 容忍度参数的选择依赖启发式谱匹配:ReRound 通过扫描容忍度并比较量化权重与原始权重的前几个奇异值来选定候选,该准则并非直接优化量化误差或任务损失,可能在某些层或某些分布下不是最优。此外,扩散模型生成的连续重构本身带有随机性,不同随机种子可能导致不同的量化结果,缺乏稳定性保证。论文虽然展示了 SVD 谱保持的合理性,但没有理论证明其最优性,且未考虑与其他量化误差指标(如层间激活误差)的联合优化。