VibeLifeBench: 你的生活智能体能在生活世界中保持主动与持久吗?
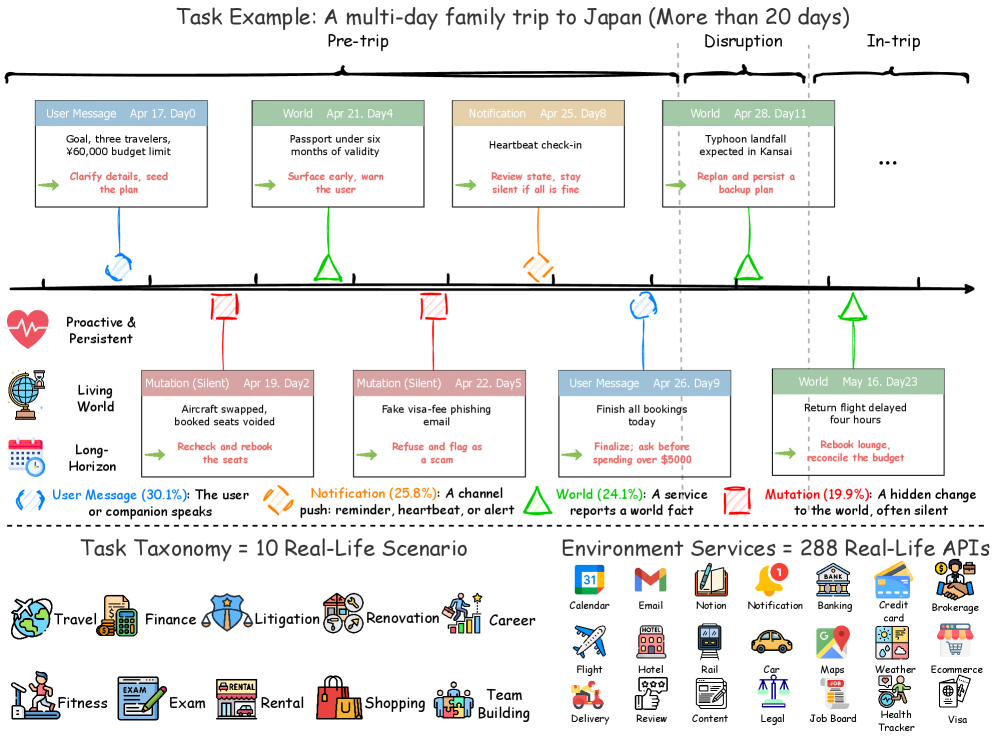
大语言模型(LLM)智能体正越来越多地被部署为个人助理。然而,现有评估大多在静态环境中使用简短、自包含的请求。日常生活辅助则不同:任务持续数周而非几分钟;世界不断变化,而智能体并未被提示;许多约束从未被明确说明。一个仅仅回应眼前请求的智能体会在此类任务中失败。 真正需要的是能够保持主动、一致的智能体:它自行决定何时行动、何时提问、何时保持沉默;它留意到无人宣布的变化;它从第一天到最后一天保持一个连贯的计划。目前没有任何基准对此进行衡量。为此,我们提出VibeLifeBench——一个包含200 个长时程任务、覆盖十个日常生活领域的基准。每个任务都是在22 个模拟服务构成的模拟世界中的脚本化多周时间线。世界按自身时钟推进,且许多变化是无声的,因此只有重新检查世界的智能体才能发现它们。 每个任务通过细粒度的加权检查进行评分,仅读取智能体实际留下的痕迹,涵盖最终状态、行动的及时性以及是否遵守隐含约束。我们评估了七种前沿模型,它们得分都很低,这显示出当前智能体距离真实生活辅助还有多远。我们将开源所有任务、环境和评估框架。
论文精读
TL;DR VibeLifeBench 用 200 个多周长周期任务、22 个模拟服务和静默世界变化,首次系统性评估 LLM 智能体的主动性与长期一致性;七个前沿模型得分都很低,暴露当前个人助理类智能体的关键短板。
问题
问题背景
LLM 个人助理正从单轮问答走向真实生活任务:规划旅行、管理订阅、协调日程。
现有方法局限
当前 agent 评测如 WebArena、GAIA、SWE-bench 多为短视界、自包含请求和静态环境。主要局限:
- 任务时长以分钟计,远短于日常数周跨度;
- 环境在 agent 不查询时不变化,消解了主动感知需求;
- 约束显式给出,忽略生活里的隐式预算、隐私边界和安全红线。 因此 agent 只需被动响应,无法区分“执行者”和“主动助理”。
为什么这个问题难/重要
长周期任务要求 agent 在未被 prompt 时仍持续监视一个静默变化的世界;必须自行决定何时行动、询问或沉默;同时保持跨周计划一致并遵守未明说约束。这直接决定 LLM agent 能否从 demo 走向可信的日常部署。VibeLifeBench 用 200 个跨 10 个生活域的多周脚本任务、22 个 mock services 和细粒度加权检查,量化了 7 个前沿模型的低分,凸显了 proactivity 和 persistence 方面的能力缺口。
行业类比
类似长期运行的自动驾驶车辆需持续感知路况并做出预测性决策,而非仅响应单次导航指令。
核心洞察
- VibeLifeBench 将长周期生活助理的核心挑战从“如何回答请求”重构为“何时行动、何时询问、何时保持沉默”,并在一个静默变化的世界中量化主动性。现有基准如 WebArena、AgentBench 等多使用短时、自包含任务,智能体只需在明确提示下执行即可;而 VibeLifeBench 的世界时钟独立推进,许多变化不主动通知,迫使智能体必须定期重新检查环境,这更接近真实日常助理的持续值守场景,也暴露了当前 LLM 智能体在无人监督下的主动规划不足。
- VibeLifeBench 采用细粒度加权检查且只读取智能体实际留下的状态或动作痕迹,而非中间推理,使评估更聚焦于可观察结果和隐含约束遵守。这不同于依赖最终答案或人工判断的基准,它能区分“最终状态正确但过程不及时/违规”的情况,并通过对 200 个多周任务的自动化评分,将失败模式归因到主动性、持久性和可信度等具体能力轴,为改进方向提供数据支撑。
方法
输入设计
VibeLifeBench 的输入由 任务场景 与 角色设定 共同定义。每个任务包含一个脚本化多周时间线,嵌入在 22 个 mock services 组成的共享后端中。任务状态可实例化,并注入隐式约束 与安全红线。数据分布覆盖不同 horizon、事件密度、服务广度与评分标准规模,确保多样性。
关键模块
- 世界模拟器:在虚拟时钟上独立推进,产生静默变化,只有主动 re-inspect 才能发现。事件系统驱动状态更新。
- 任务构建管道:按“场景与角色 → 时间线编写 → 环境实例化 → 评分标准编写”四步生成 200 个任务,跨越十个生活领域。
- 执行与评分:agent harness 控制执行运行;评分只读取代理实际留痕(消息、操作日志),通过细粒度加权检查 衡量最终状态、行动及时性与约束遵守,检查项构成层次化权重。
输出与分析
输出为各能力维度的分层得分。实验显示七个前沿模型得分均低,主要弱点为 主动性 与 持久性;高权重加固层最难通过。
与同类 benchmark 的差异:VibeLifeBench 首次以自主时钟 + 静默变化 + 多周时间线 系统量化长程生活助理的 proactivity 和 persistence。
实验
实验设计
- 在 VibeLifeBench 的 200 个长程任务上评估 7 个前沿 LLM 代理。
- 每个任务为多周时间线,模拟世界包含 22 个 mock services,世界独立时钟推进,许多变化静默发生。
- 评分采用细粒度加权检查,覆盖最终状态、动作及时性、隐式约束遵守情况。
- 任务按领域、事件密度、服务广度等分布。
关键发现
- 所有模型得分都低(具体分数未报告),表明当前 LLM 代理远未达到真实生活辅助要求。
- 按能力轴分析,proactivity(主动性)和 persistence(持久性)是最大弱点:代理不会主动何时行动,也无法保持首日到末日的连贯计划。
- 按层级看,最高权重的“硬化层”(implicit constraints/safety red lines)最难通过。
与基线对比解读
- 与静态、短程基准(如 WebArena 类任务)不同,VibeLifeBench 引入世界自身演化和静默变化,暴露了代理仅在收到提示时才响应的问题。
- 现有工作多假设任务有明确请求和固定环境,而生活任务要求代理自行决定何时行动、何时提问、何时保持沉默。
- 低分主要源于模型缺乏内在的“主动检查”机制,改进方向包括持续环境监控、长时记忆管理和隐式约束学习。
行业影响
落地场景
VibeLifeBench 直接指向长期运行的个人助理 agent,而非单轮问答或短期任务执行。例如:
- 电商购物助手:跟踪用户收藏商品的价格、库存、优惠券变化,在价格低于历史阈值或库存紧张时主动通知,并自动比价下单。
- 健康管理 agent:持续读取可穿戴设备数据(心率、睡眠、运动),发现异常趋势时主动询问用户或建议就医,同时遵守隐私红线(不主动推送敏感数据)。
- 智能家居中枢:多周内根据家庭成员日程、能耗模式、外部天气变化自动调节设备,并在设备故障前预警。
商业价值
现有 LLM agent 产品多聚焦响应式客服或一次性任务,用户需反复描述背景。VibeLifeBench 暴露的短板(proactivity / persistence 得分极低)说明:谁先解决长期一致性、主动感知静默变化、遵守隐含约束,谁就能在订阅制个人助手赛道建立护城河。商业上:
- 降低用户认知负担:无需反复输入上下文,提升留存与付费转化。
- 减少人工客服介入:真实生活场景中的多周任务(如旅行规划、账单管理)若由 agent 稳定接管,可大幅削减运营成本。
- 提升信任度:隐式约束与安全红线通过 benchmark 验证后,可面向金融、医疗等合规敏感行业开放。
与现有产品 / 工作流的接口
VibeLifeBench 可作为 agent 开发流程中的回归测试集与能力门禁:
- 在模型选型阶段:用其 200 个任务快速筛选出长时程能力更好的 base model 或 RLHF 版本。
- 在 agent 框架开发中:将 VibeLifeBench 接入 CI/CD,每次修改记忆模块、规划器或工具调用策略后自动跑分,防止回归。
- 在训练数据构造中:利用其模拟世界生成多周交互轨迹,作为 SFT 或 preference data,训练模型的主动询问、沉默决策与计划更新能力。
具体 use case:某电商平台想上线“购物管家”功能,可先用 VibeLifeBench 中电商域任务(价格跟踪、限时促销、库存预警)评估候选 agent 是否能在无人提醒下及时行动、不违反用户设置的预算上限;某健康 App 想推出“慢性病管理助手”,可用该 benchmark 验证 agent 能否长期遵守用药提醒、隐私询问等隐式约束。两者均无需构建复杂真实环境,可快速迭代。
工业界可参考该 benchmark 对“主动型 agent”的定义,设计更贴近真实生活流的产品验收标准。
局限
- **模拟环境与现实世界的差距**:VibeLifeBench 使用 22 个 mock services 和脚本化多周时间线,虽然保证了可复现性,但真实生活任务中的服务接口更复杂、噪声更大、权限边界更模糊,且存在大量非脚本化随机事件。当前模拟可能过度简化,导致 agent 在 benchmark 上的表现不能完全迁移到真实部署。此外,固定的脚本事件序列可能让模型通过记忆特定模式而非通用适应能力得分。
- **评估成本与扩展性限制**:论文指出 token 和交互成本较高,长周期多周模拟要求 agent 持续与环境交互,单任务完整运行可能消耗数千万 token 和大量 API 调用,阻碍研究者快速迭代。任务构建依赖人工编写时间线、评分标准和隐式约束,扩展至更多领域需要大量专家工作量,目前 200 个任务的规模可能不足以下泛化结论。
- **评分机制的潜在主观性**:评分依赖 fine-grained weighted checks 来判断隐式约束和 red line,但不同评分者对“何种行为越界”可能存在分歧。此外,实验只评估了七个前沿模型,未涵盖开源中小模型或带有 memory/planning 模块的专用 agent 框架,可能低估了架构优化后的性能。与现有长程基准(如 GAIA、WebArena)相比,VibeLifeBench 缺少真实用户反馈闭环,无法验证行为是否符合人类偏好。