层级式自我改进:面向任务特定可进化代理 Harness 的框架
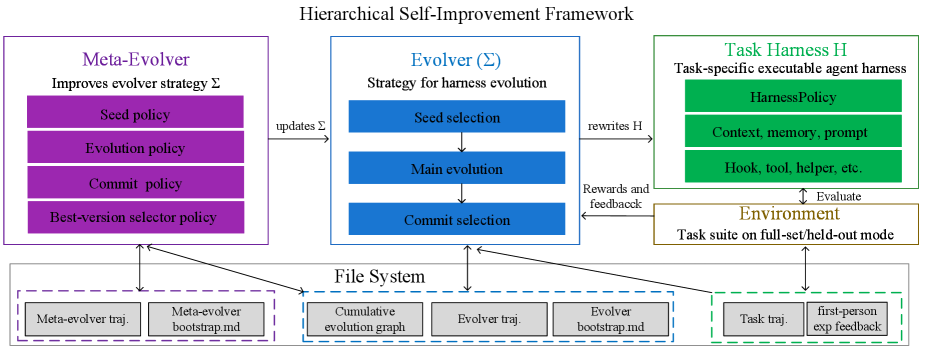
现代大语言模型(LLM)代理通常通过手动修改提示、工具或工作流来改进,而模型周围的可执行脚手架——即 Harness——在部署后通常被视为固定制品。本研究探索了一种替代方案:Harness 是任务特定且可连续进化的:每个任务族维护自己的 Harness,通过固定的任务注入接缝(task-injection seam)在迭代间热替换,并利用环境反馈进行重写。 我们提出 层级式自我改进(Hierarchical Self-Improvement, HSI) 框架:单个冻结的 LLM M 在三个层级作用域上运行——执行任务的任务 Harness H、重写 H 的进化器(evolver),以及在一个固定外部锚定下重写进化器策略代码的元进化器(meta-evolver)。通过 思考开/关(thinking-on/off)设计,我们隔离了 Harness 进化的贡献:任务执行期间禁用推理,而自我修改期间启用。 HSI 受两个因素约束:反馈保真度界(进化需要信息丰富的奖励信号来指导选择)和 骨干能力界(Harness 重设计无法克服冻结模型的限制)。在 BALROG 基准上,以 DeepSeek-V4-Flash-Preview 为冻结骨干,HSI 在中等难度任务上相比初始 Harness 取得稳定增益(BabyAI +39.3、Crafter +33.0、TextWorld +25.0、MiniHack +15.0,均为原始进度百分比),并在 BabaIsAI 子套件上获得强留出泛化(从 20% 未见拆分中,BreakStop 最佳测试 0.98,GoTo 1.00)。在超出骨干能力的任务(NLE)上,Harness 进化未带来改进。 这些结果表明,任务特定 Harness 进化是在明确经验极限下改进冻结 LLM 代理的一条可行路径。代码见 https://github.com/TailinZhou/hsi。
论文精读
TL;DR Hierarchical Self-Improvement (HSI) 让单一冻结 LLM 通过分层自修改演化任务专用执行 harness,在 BALROG 中等难度任务上显著提升性能,同时明确其受反馈质量与模型能力双重边界约束。
问题
问题背景
LLM agent 性能优化长期依赖人工调整 prompt、工具与工作流,部署后 harness(执行脚手架)通常固定不变。业界正探索让 agent 持续自改进、适应任务分布漂移的机制。
现有方法局限
传统方法局限于手动修改提示或少数工具,难以系统利用环境反馈更新整个可执行 scaffold;Gödel-style 递归自改进存在失控风险与验证难题;在线适应方法(如 Reflexion、Voyager 等)多针对单一任务或固定工具库,缺乏任务级 harness 的热替换与演化框架。由于 harness 组件耦合度高,修改范围不明确,自动演化容易破坏已有能力,且难以归因收益来源。
为什么这个问题难/重要
技术挑战在于:1) 需要隔离自修改边界,避免模型直接改写自身权重或核心推理逻辑导致不可控;2) 环境反馈稀疏或噪声时,演化信号可能误导 harness 重写;3) frozen backbone 的能力上限使 harness 演化存在天花板,需明确可演化边界。业界高度关注低人工干预的 agent 自改进:降低维护成本、提升长尾任务表现、支持多任务家族独立演化,同时保持可审计与可回滚。
行业类比
可将 task-specific harness 演化类比为 推荐系统 中按场景动态切换的策略配置:模型权重固定,但通过持续 A/B 实验更新场景级策略参数与执行逻辑。
核心洞察
- HSI 将“可进化单元”定位为 task harness(执行脚手架),而非模型权重或 prompt,通过固定 task-injection seam 实现热插拔和回滚,使 agent 改进成为有版本控制、可评估的工程对象。同类工作常把 harness 视为部署后的固定 artifact,手动修改 prompt/tool/workflow,改进不可累积且难以归因;HSI 让 harness 自身可被选择、探查、提交和继承,为 LLM agent 在线适应提供新的工程接口。
- HSI 的层级自改进(harness→evolver→meta-evolver)并不追求无限递归,而是明确受 feedback-fidelity 和 backbone capability 两个 bound 约束,并用 thinking on/off 隔离归因。这提供了可证伪的 self-improvement 评估协议:中等难度任务上提升显著,超出骨干能力任务(如 NLE)无改进。相比宣称“模型可无限自改进”的工作,HSI 以实验划出能力边界,更符合工程上对可靠性和可控性的要求。
方法
方法核心:HSI 以单个冻结 LLM M 为唯一执行与生成器,输入任务族、初始 task harness(H)以及环境交互接口。H 通过固定 task-injection seam 注入执行循环,并在迭代中被热替换;模型权重不变。
三层结构:
- 执行层:
H调用 M 完成环境交互,默认关闭推理(thinking-off)以隔离 harness 贡献。 - 进化层:evolver 读取轨迹与奖励,生成候选
H,以 multi-commit pool 并行保存多个版本,按反馈选择 commit。 - 元进化层:meta-evolver 在冻结外层锚下改写 evolver 的策略代码,让“如何进化”本身可进化。
关键机制包括:
- Seed selection:从失败轨迹生成改进假设,作为初始种子。
- Hot-swappable rewrites:每轮替换当前
H,旧版本保留在进化图。 - Commit selection:多提交池中进行 explore-exploit 选择。
- Best-version selection:导出时优先 held-out 泛化,而非只看训练集奖励。
- Thinking on/off:仅自我修改阶段开启推理,任务执行禁用 cot,用于归因收益来源。
输出:任务特异的可替换 H 与版本谱系。HSI 受两类边界约束:反馈保真度边界(奖励信号信息量)与骨干模型能力边界(无法突破冻结模型上限)。
与同类 prompt / 固定 scaffold 优化方法不同,HSI 将 harness 本身作为持续进化对象,并通过 meta-evolver 形成两层自改进循环。
实验
实验设计
在 BALROG 基准上评测,frozen backbone 为 DeepSeek-V4-Flash-Preview。Setup A 对每个 task family 独立进化 harness,通过固定 task-injection seam 热切换;Setup B 在 BabaIsAI 子套件上做 held-out 泛化,20% 未见 split 测试。思考开关设计仅允许 self-modification 时启用推理,隔离 harness 进化贡献。基线为初始手工 harness。
关键发现
- 中等难度任务上,HSI 相对初始 harness 获得一致提升:BabyAI +39.3、Crafter +33.0、TextWorld +25.0、MiniHack +15.0(原始 % Progress)。
- BabaIsAI held-out 泛化:BreakStop 0.98、GoTo 1.00 best-test,表明 harness 进化可泛化到新 split。
- 超出 backbone 能力的 NLE 上无提升,验证 backbone capability bound。
- meta-evolution 进一步改进 evolver 策略,但受反馈质量约束。
与基线对比解读
HSI 的提升全部来自 harness 重写而非模型权重更新,证明 harness 是独立进化轴。相比手动 harness 工程,HSI 自动化、任务特定、支持热切换;但受限于 feedback-fidelity bound 和 backbone capability bound。相比 Gödel 式自改进,HSI 用固定外层 anchor 避免递归不稳定,但边界更清晰。
行业影响
落地场景
HSI 适合环境反馈明确、需长期维护的 LLM Agent 任务族。例如:
- 电商客服:按订单类型(退换货 / 物流 / 支付)分别演化 harness,自动适配政策变化;
- 内容审核:不同内容形态(短视频 / 直播 / 图文)各自演化审核 harness,根据误杀 / 漏放反馈持续更新。
商业价值
- 降本:冻结骨干模型,只演化轻量 harness,减少人工改写 prompt / 工具 / workflow 与重复微调成本;
- 提效:中等难度任务上原始
% Progress提升(如 BabyAI +39.3、Crafter +33.0),可直接转化为任务成功率; - 风险可控:反馈保真度与骨干能力边界明确,企业可预判演化收益上限,避免无效投入。
与现有产品/工作流的接口
现有 Agent 栈(LangGraph / AutoGen / LlamaIndex)把 harness 视为固定配置。HSI 可作为外层 演化循环 接入:
- 保留原执行接口,通过固定
task-injection seam热插拔任务 harness; - 引入 evolver / meta-evolver 与多提交池,纳入 CI/CD 或 MLOps 流水线;
- 用评测集做 generalization-first export,与现有回归测试 / 金标库对齐。
工程启示:先确认任务反馈信号足够稠密可靠,再决定引入 HSI;对超骨干能力任务(如 NLE)不应期待演化收益。
局限
- **反馈保真度依赖**:HSI 的进化选择依赖环境反馈信号,当奖励稀疏、带噪或不可分解时,`evolver` 与 `commit selection` 难以选出有效 harness。论文在 NLE 任务上观察到进化无收益,说明反馈质量是硬约束;真实场景中许多任务缺乏稠密、可信的奖励函数,这会显著限制 HSI 的适用范围。
- **骨干能力上限**:HSI 只重写执行 harness,不更新 frozen LLM 权重,因此改进不能突破 backbone 本身的知识与推理能力。对于需要新知识或强推理的任务,即使 harness 优化到最优也无法弥补模型短板;论文明确以 NLE 为例展示这一硬瓶颈,说明 HSI 只能作为模型能力之上的增效手段,不能替代模型升级。
- **实验范围与工程成本**:评估集中在 BALROG 的若干子任务与单一 backbone(DeepSeek-V4-Flash-Preview),且未与 prompt 级自改进、多智能体在线学习等方法进行系统对比;多层级进化(`evolver` / `meta-evolver` / 提交选择)会引入多次 LLM 调用,带来 token 开销与延迟,论文未提供详细成本分析,工程落地时可能面临性价比问题。