基于演化评分规则奖励的音频推理强化学习
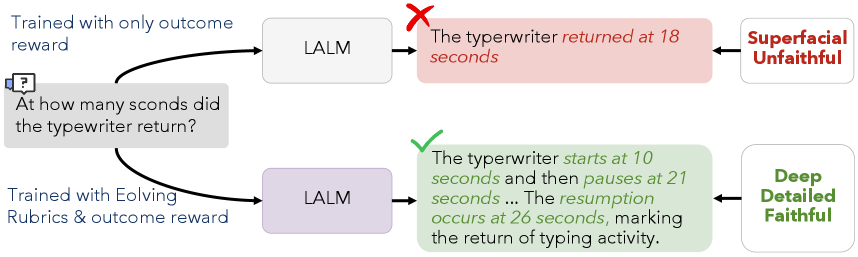
音频推理对于机器理解声学世界至关重要。基于可验证奖励的强化学习 能够引发此类推理,然而现有奖励设计各有限制:基于结果的奖励仅监督最终答案,模型可能绕过音频;基于过程的奖励依赖粗糙、手工、固定的标准,既不适应问题也不基于声学证据。此外,不同问题需求多样,静态标准会随策略改进而变弱。 为此,我们提出 AudioRubrics,一个以自演化、音频为锚的规则奖励监督音频推理的强化学习框架。AudioRubrics 从原始波形合成每个样本的规则,并基于模型自身的 rollout 重新生成和加权标准,提供持续学习信号,精准打击当前策略的薄弱点。 在三个音频推理基准上的全面评估表明,AudioRubrics 大幅超越多种开源与训练基线。分析显示收益随规则生成器与评判器的能力增强而扩大,且推理长度收敛稳定,避免退化或失控。音频感知的提升进一步验证了将监督锚定于声学证据的有效性。
论文精读
TL;DR AudioRubrics 用自演化、音频感知的评分细则作为强化学习奖励,针对模型弱点持续优化音频推理,性能大幅超越基线。
问题
问题背景
音频推理(audio reasoning)是机器理解声学世界的关键能力。近期工作利用强化学习(RL)与可验证奖励来引导模型展示逐步推理过程,但奖励设计成为瓶颈。
现有方法的局限
两类主要奖励设计各具缺陷,形成互补性困境:
- 结果导向奖励(outcome-based reward)仅根据最终答案正确性给予信号,模型可能产生“捷径”推理,甚至忽略音频输入,导致推理与声学证据脱节,泛化能力差。
- 过程导向奖励(process-based reward)试图直接评估推理步骤,但通常基于粗糙、手工设计的固定评分标准(如关键词匹配、步骤完整性),存在三重局限:
- 不具适应性:不同问题对感知深度的要求不同,固定标准无法针对具体问题动态调整;
- 脱离声学证据:标准未能扎根音频内容,无法保证推理忠实于实际声学信息;
- 信号饱和:随着模型策略改进,静态标准逐渐丧失区分度,不再提供有效训练信号。
技术挑战与重要性
设计细粒度、音频扎根(audio-grounded)且持续进化的奖励极其困难,因为为每个样本手动编写详尽评分标准不切实际。音频推理本身跨度大——从单纯感知到复杂多步推理——使得统一的奖励范式不可行。在工业界,语音助手、环境监测等音频理解系统对可解释推理的需求日益增长,推动着该问题的研究价值。
工程类比
类似于代码生成中,从基于测试的结果奖励转向利用静态分析的过程奖励以保障代码质量,音频推理也需要从原始音频动态生成“评分规则”,像代码 linter 一样持续检查推理过程,确保其与声学信号一致。
核心洞察
- **从静态手工准则到自演化评分标准的范式转变**:现有过程奖励依赖固定、粗粒度的手工规则,无法适应不同问题的需求差异,且随着策略提升逐渐失效。AudioRubrics 让评分准则在训练中自我进化——根据当前策略的 rollout 表现,动态生成新的评判维度并重新加权,持续瞄准策略弱点。这不同于一次性设计奖励函数,而是将奖励设计本身变成了一个在线学习过程,为长周期 RL 训练提供了持续有效的反馈,避免了奖励饱和导致的训练停滞。
- **音频锚定的奖励设计弥合感知与推理的鸿沟**:结果导向奖励让模型可能忽略音频直接猜答案,而传统过程奖励的准则往往脱离实际声学内容,难以确保推理忠实于听觉证据。AudioRubrics 从原始波形中合成每个样本特有的评分准则,使奖励直接植根于音频信号,强制模型的推理步骤与声学内容严格对齐。这种音频第一的奖励设计不仅提升了推理准确性,还反向强化了音频感知能力,而这是纯文本 RL 奖励无法实现的,为多模态推理任务的奖励塑造提供了新思路。
方法
AudioRubrics 以原始音频波形 + 问题为输入,输出经过强化学习微调、能够产生多步推理与答案的音频推理模型。方法核心由三个模块构成:
- Per-sample Rubric 生成:对每个训练样本,从原始音频直接合成一组细粒度、基于声学证据的评分标准(rubrics)。这些指标不只关注最终答案,更涵盖感知准确度、推理步骤连贯性、证据引用等维度,从而将奖励信号锚定在音频内容上。
- 策略采样与 Rubric 演化:在每次策略更新时,音频推理模型(policy)对同一输入采样多条推理轨迹(rollouts)。利用这些 rollout 的统计分析,框架自动重新生成并重新加权各评分标准组,让 rubrics 持续对准当前策略的弱点——当某些指标饱和(即模型已稳定满足)时,其权重下降,而新的薄弱环节被提升。
- 自适应 Reward 计算与 GRPO 优化:演化后的 rubrics 由评判模型(judge)对每条 rollout 打分,产生细粒度的过程奖励与结果奖励。最后,采用**组相对策略优化(GRPO)**来更新策略,无需额外价值网络,仅通过组内相对比较估计优势。
整个训练循环中,rubrics 随策略改进动态演变,避免了固定手写标准在训练后期失效的问题。
与同类方法的差异点:不同于静态、人工定义的 process reward,AudioRubrics 的 rubrics 是逐样本动态生成、音频感知且自演化的,从而持续提供与声学证据对齐的、高信息量的训练信号,解决了现有方法中奖励标准僵化或脱离音频内容的问题。
实验
实验设计
AudioRubrics 在三个音频推理基准上开展评估,与多种基线进行对比,包括仅使用最终答案奖励 (outcome-based) 和静态过程奖励 (static process-based) 的强化学习方法。所有实验均以 GRPO (Group Relative Policy Optimization) 为优化框架,AudioRubrics 的核心创新在于使用自演化的、音频锚定的 rubric 奖励,其中评分细则由生成器根据原始音频和模型 rollout 动态生成并重新加权。分析部分涵盖奖励设计与判断能力的伸缩性、消融实验以及 rubric 演化轨迹,以全面验证各组件的作用。
关键发现
- 性能大幅领先:AudioRubrics 在所有三个基准上均显著超越现有开源模型及基于训练的基线。
- 能力伸缩性:随着 rubric 生成器和裁判模型的能力增强,性能增益也随之扩大,表明该框架可从更强的评判模型中持续获益。
- 推理长度稳定收敛:模型收敛后的推理长度保持稳定,既未出现退化性坍塌,也未发生无限制增长,说明奖励信号成功约束了推理过程的规模。
- 音频感知增强:通过将监督信号锚定在声学证据上,模型的音频感知能力得到切实改善,验证了音频锚定的必要性。
对比解读
相比仅依赖最终答案的 outcome-based 奖励,AudioRubrics 强制模型关注音频内容,从而避免“只看答案、不听声音”的捷径行为。与手动的、固定的过程奖励相比,自适应 rubric 能针对当前策略的弱点动态调整评判标准,持续提供有效的学习信号,解决了静态标准在策略提升后逐渐失效的问题。这一对比深刻表明,在复杂音频推理任务中,细粒度、自适应且音频锚定的奖励设计是实现稳健推理的关键,对整个多模态推理领域的奖励工程具有重要启示。
行业影响
落地场景与产品价值
AudioRubrics 自动演化打分标准的方法能直接用于增强语音助手、会议转录系统、内容审核工具、教育评估平台、医疗问诊记录分析等产品的推理能力。其核心在于对音频推理过程进行细粒度、音频锚定的监督,而不仅关注最终答案,尤其适合需多步逻辑(如通过环境声推断事件原因)或细粒度感知(如辨别乐器技法)的场景。与原有的固定规则或只看结果的方法相比,它让模型在音频信号上保持注意力,减少“不看音频也能猜对”的捷径学习。
商业价值
该方法同时改善准确率、可解释性和训练效率,对应三重商业收益:
- 降本:减少人工对模型输出的审核与修正;动态生成的评分标准免去大量人工设计 reward 的成本。
- 增收/体验提升:在语音交互类产品中,更可靠的推理直接提升用户粘性与付费转化(如智能客服解决率上升、教育场景自动评价可信度提高)。
- 风险控制:音频推理过程被显式监督,有助于审计模型如何利用声音证据,便于满足合规要求。
与现有工作流的集成
AudioRubrics 可作为训练管线中的一个模块,嵌入现有的 RLHF 或 GRPO 训练 loop:
- 利用预训练音频编码器和 LLM,从原始波形生成样本级评分项(rubric)。
- 基于当前策略的多条 rollout,按组重新生成和加权重估评分项,作为持续更新的奖励信号。
- 该奖励信号可直接与策略梯度优化器(如 PPO)对接,无需改动主模型架构。
对于已有音频推理系统的团队,可将静态的 reward_model 替换为 AudioRubrics 模块,或将其作为额外信号与原有 reward 结合。项目页AudioRubrics 和代码库github.com/tianyi-lab/AudioRubrics 提供了参考实现。
典型 Use Case
- 智能车载助手:对行车记录仪音频推理(如“后方急刹车的声音,会不会是摩托车”),自动演化评分标准能持续提升对罕见声音的辨识与推断能力,减少误判,提高驾驶辅助系统的安全价值。
- AI 音乐教育工具:学生演奏一段钢琴,系统需识别错音、触键力度并给出改进建议。AudioRubrics 可动态生成针对该学生演奏的精细评分项(如“是否在第三小节有滑音”),代替固定清单,使评估更贴近实际教学需求,提升个性化反馈质量。
局限
- **依赖外部模型质量与计算开销**:AudioRubrics 的奖励质量强依赖于 rubric 生成器和评判器的音频理解能力,若这些组件不够稳健,细则可能失准,误导策略学习。同时,从原始波形生成专属细则并在每次 rollout 后演化,额外计算成本较高,可能限制其在实时或资源受限场景下的应用。论文未分析不同品质生成器带来的性能波动,也未对比更轻量级的过程监督方法。
- **奖励黑客与过拟合风险**:演化细则旨在针对当前策略弱点,但模型可能学会利用评判器漏洞获取高分,而非真正提升音频推理能力。奖励信号完全来自另一模型,缺乏外部真实监督,存在策略与评判器共谋或过拟合评判偏好的风险,可能导致推理过程脱离实际声学证据。论文未讨论此类风险的缓解手段,也未评估在未见数据上的泛化表现。
- **实验与比较范围有限**:评估仅在三个音频问答基准上进行,未扩展到音乐分析、声景分类等更广泛音频任务,也未与基于人类反馈的过程奖励模型或大规模音频预训练方法充分对比。所有实验固定于单一骨干模型,对不同架构和参数量的鲁棒性未知,方法的普适性尚需进一步验证。