BoundInk:边界感知的在线手写生成
逼真的在线手写 不仅取决于单个字符的形状,还取决于书写者如何连接、留白与对齐相邻字符。现有方法主要依赖长程序列建模,只能隐式地 刻画这些字符间行为,因此常生成看似合理、却伴随连笔断裂、间距不一致或风格不一致过渡的结果。 为此,作者提出 BoundInk:一个以书写者为条件的框架,将字符间边界视为显式的生成单元。通过联合建模局部过渡 与周边文本上下文,BoundInk 在保留书写者特有字形外观的同时,提升了整行文本的连通性与间距一致性。 他们还提出边界感知评估框架,在传统轨迹相似度之外,直接评估字符间的连笔连续性 与空间关系。主要结果包括: - 在三个基准匹配的设置中,BoundInk 提升全部适用的边界质量指标,并将归一化动态时间规整(DTW) 降低 17.6--47.8%; - 在盲测人工评估中,其输出在 78.0--82.6% 的有效逐准则判断中被优先选择。
论文精读
TL;DR BoundInk 将在线手写生成中的字符间边界显式建模为生成单元,联合局部过渡与上下文,改善连笔、间距和风格一致性;在边界感知评测中,NDTW 降低 17.6–47.8%,人类评估偏好 78–82.6%。
问题
问题背景:在线手写生成 旨在根据文本和书写者风格生成连续笔迹轨迹,当前研究聚焦于保持字符形状的同时提升整行书写的连贯性与自然度。
现有方法局限:主流方法依赖长序列建模,如 RNN、Transformer 或扩散模型,隐式学习字符间过渡。这种隐式建模难以显式表征字符边界,导致生成结果常见以下问题:
- 断笔或连笔不自然,尤其是在常见字符组合之外的 pair 上;
- 间距与对齐波动,破坏书写者风格一致性;
- 模型优化目标以字符级重建为主,缺少边界级监督信号;
- 训练数据中字形过渡样本多样性有限,长序列模型容易过拟合。
为什么这个问题难/重要:字符边界涉及局部几何(连接、间距、对齐)与全局书写风格的强耦合,必须同时建模局部过渡和上下文。传统评估指标如DTW 关注整体轨迹相似度,无法直接度量 cursive 连续性和空间关系,导致模型优化与感知质量脱节。业界在个性化字体、教育辅助、数字签名等场景对生成手写的可用性要求高,边界质量直接影响落地效果。
行业类比:类似于语音合成中显式建模韵律边界 而非仅依赖端到端声学模型隐式学习停顿,显式边界建模能显著提升生成结果的感知自然度。
核心洞察
- BoundInk 将字符间边界作为显式生成单元,而非仅依赖长程序列建模隐式捕获字符间过渡。这一设计使模型能够显式学习连笔、间距和对齐等 writer-specific 行为,从而在保持字形质量的同时提升整行书写的连续性。相比现有方法(如基于 RNN/Transformer 的序列生成),其核心差异在于通过 bigram-aware local decoding 与 boundary supervision,将局部过渡与全局上下文联合建模,直接针对连笔断裂、间距不一致等常见缺陷进行优化。
- BoundInk 提出边界感知的评测框架,直接度量 cursive continuity 和字符间空间关系,突破了传统 trajectory similarity(如 DTW)对书写质量的单一评价。这种评测方式能捕捉人类感知中的连笔断裂与间距不均问题,使模型优化目标与实际书写自然度对齐。在基准匹配设置下,BoundInk 将 normalized dynamic time warping 降低 17.6-47.8%,并在盲评中获得 78.0-82.6% 的偏好,证明边界感知评价能有效反映人类对书写连贯性的判断。
方法
输入与编码
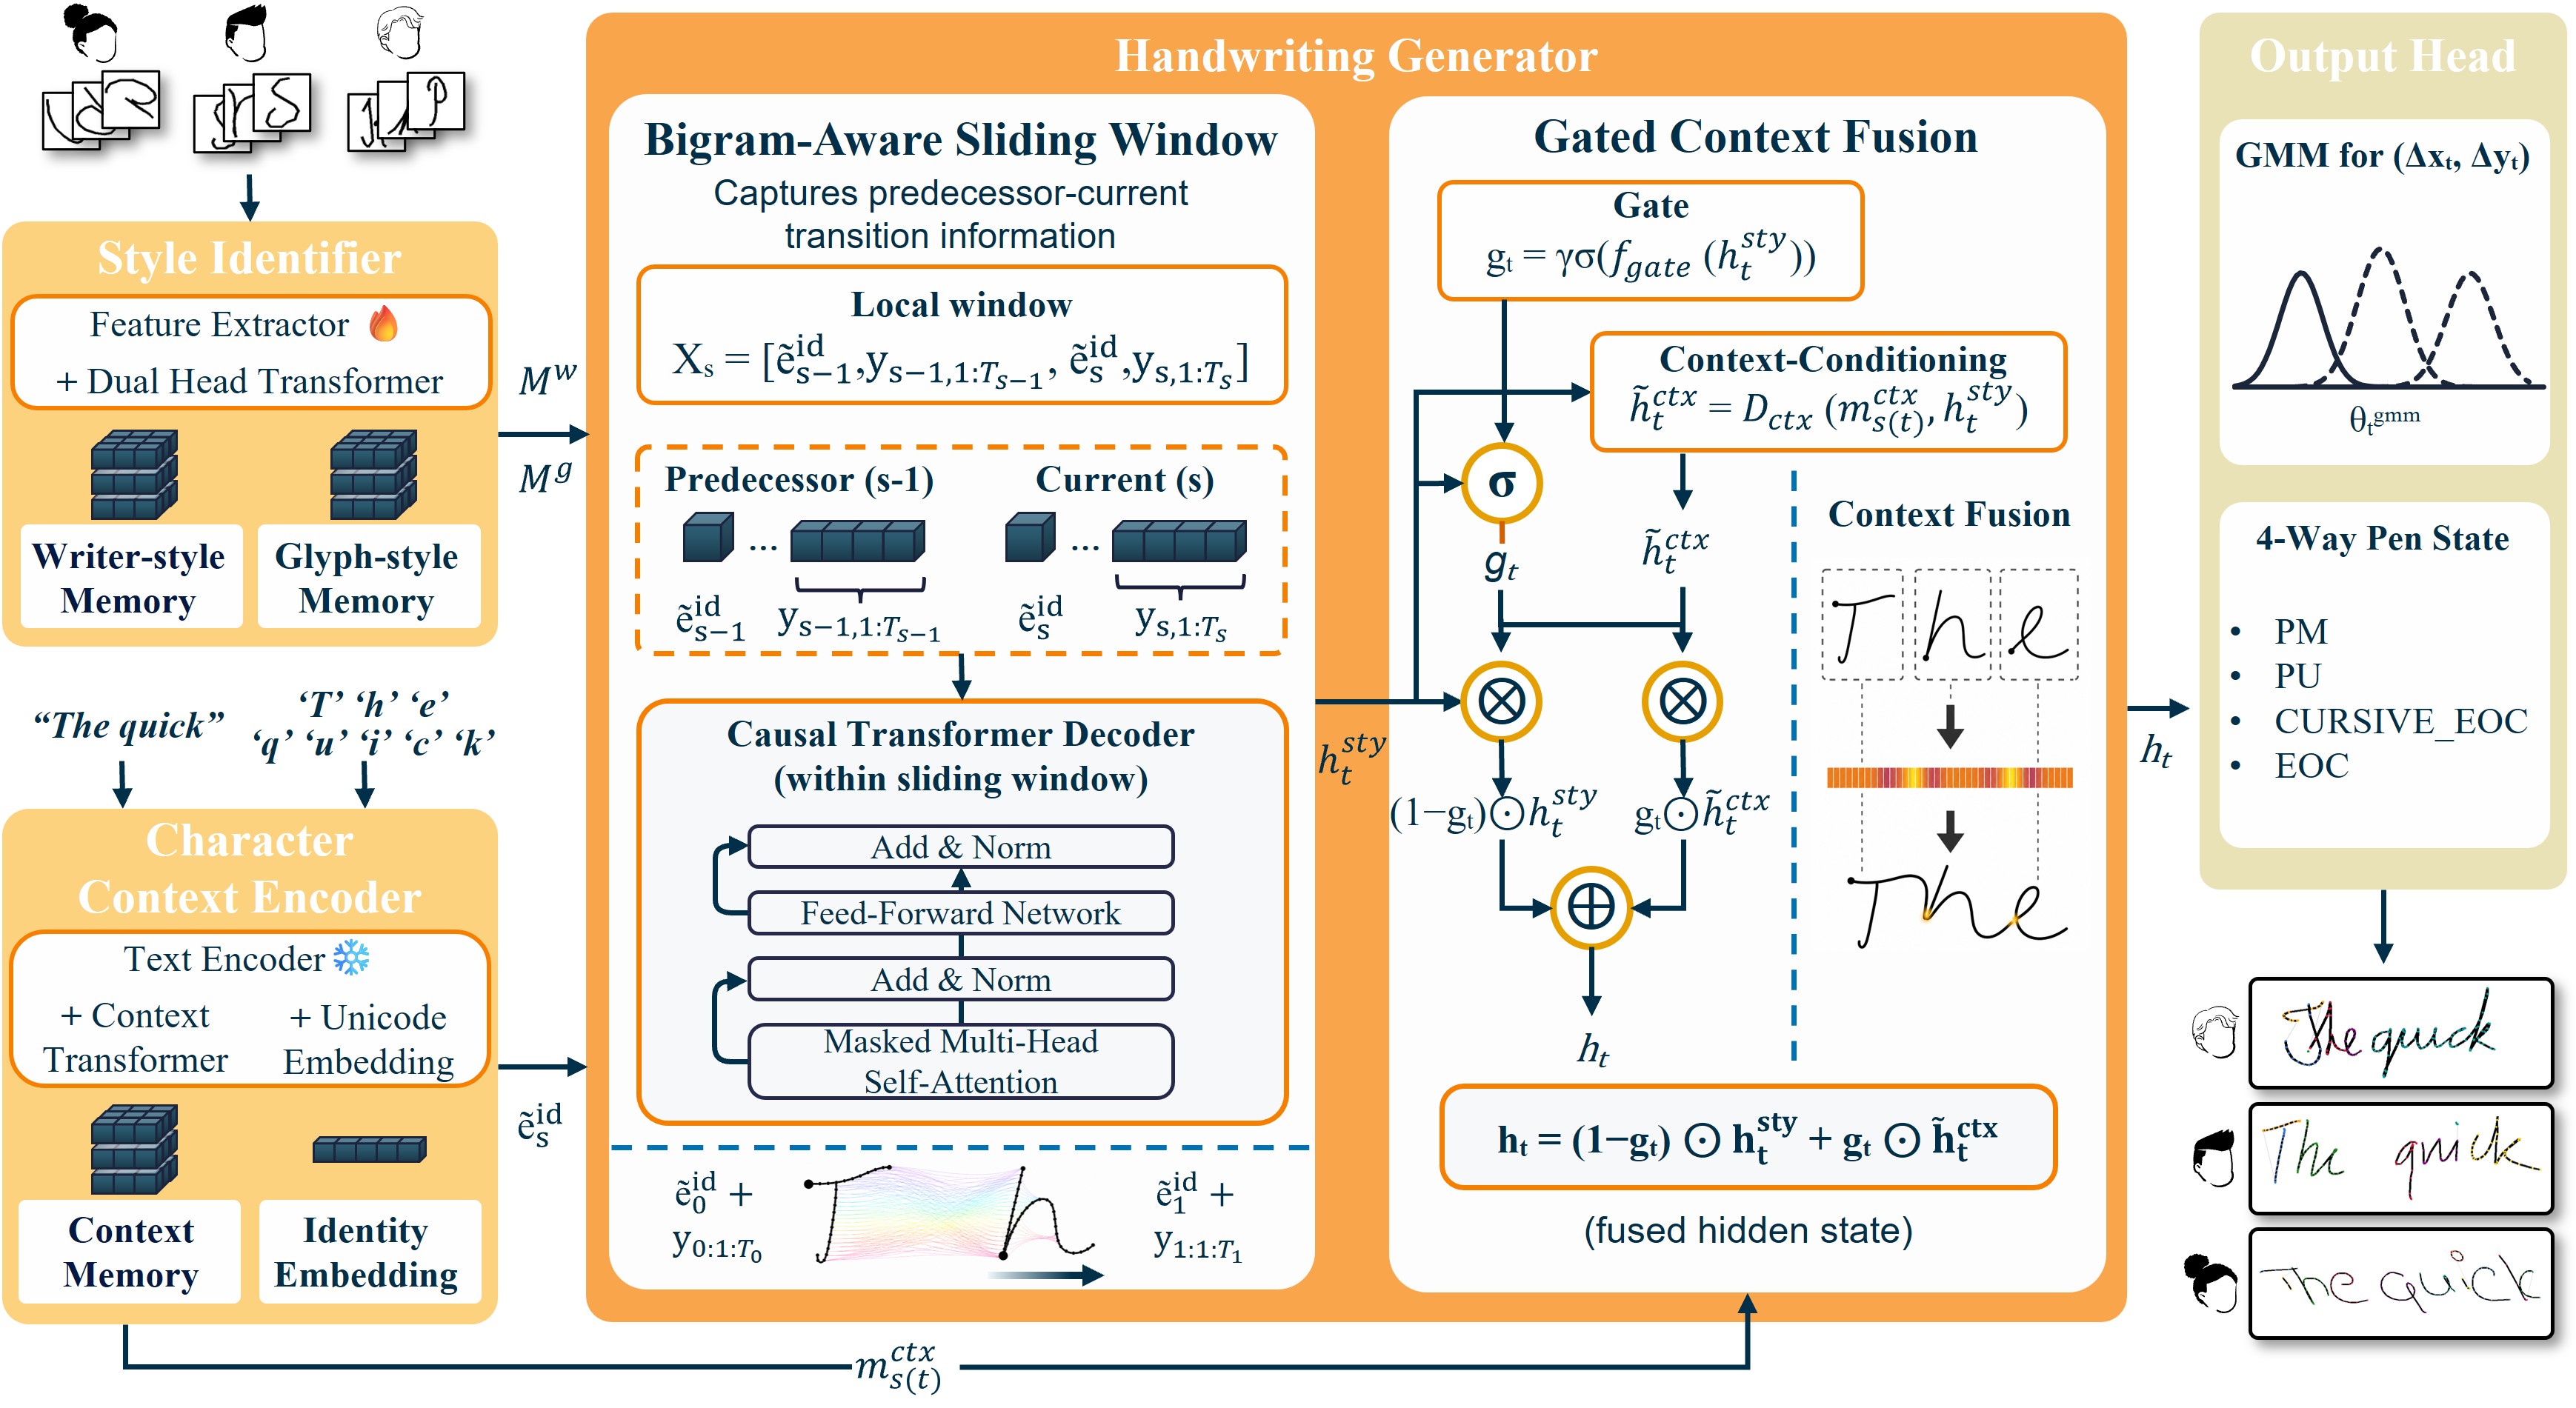
BoundInk 的输入包括:目标文本字符序列 与 作者风格参考(可通过序列风格参考或 writer embedding 注入)。字符先经过 Character Context Encoder 获得两类表示:Character-Identity Embedding(单个字符的独特形状特征)和 Context Memory(相邻字符与整行文本的上下文信息)。
关键生成模块
核心是 Bigram-Aware Local Decoding(局部双字符解码器),不再依赖全局长序列 RNN/Transformer 去隐式学习字间关系,而是将每个相邻字符对(bigram)作为显式生成单元。具体包括:
- Bi-SWT Decoder:对字符对边界进行双向滑动窗口建模,局部捕捉连接、间距、对齐等过渡行为;
- Gated Context Fusion:用门控机制融合上下文记忆,避免局部生成与整行风格冲突;
- GMM Output Head:每个时间步输出笔迹轨迹点的位置(x, y, pen state)及混合高斯分布参数。
训练与监督
采用 三阶段课程与边界监督:先单独训练字符形状,再引入字符对生成,最后整行生成。损失包括轨迹重建误差、GMM 负对数似然,以及显式的边界状态辅助目标(如区分笔画连接/断开、调节间距)。
输出为完整的在线笔迹轨迹序列,包含字形轮廓与字符间连接。
与依赖长程序列建模、仅隐式建模字符间关系的方法相比,BoundInk 将边界作为显式生成单元并通过 bigram 局部解码与边界监督直接优化字间连接与间距,这是核心差异。
实验
实验设计
BoundInk 在三个 benchmark-matched 设置下评估,包括由 IAM 与 BRUSH 协调构建的英文合并数据集等。评估分为轨迹相似度与边界质量两个维度:前者使用 normalized dynamic time warping (ND-DTW) 等常规指标;后者引入边界感知指标,直接量化字符间连笔连续性、间距与对齐。此外还进行了盲评人类偏好测试。
关键发现
BoundInk 在所有适用的边界质量指标上均有提升,且 ND-DTW 降低 17.6%–47.8%。盲评中,78.0%–82.6% 的有效标准判断偏好 BoundInk 输出,说明其不仅改善数值指标,也更符合人类对连贯手写的感知。
与基线对比解读
现有方法依赖长程序列建模,仅隐式捕获字符间行为,常导致连笔断裂、间距不一致。BoundInk 将 inter-character boundaries 作为显式生成单元,联合建模局部转移与上下文,因而能在保持 writer-specific 字形的同时显著提升连贯性。工程启示:在手写生成等具有强局部结构的序列任务中,显式建模边界或过渡单元比单纯堆叠全局上下文更有效。
行业影响
落地场景
BoundInk 可作为在线手写生成引擎 嵌入以下产品:电商平台的个性化手写感谢卡与贺卡生成,按用户风格输出连贯手写文本;在线教育平台的教师手写体板书、批注模拟,减少人工录制成本;内容创作工具中的“手写笔记”导出,支持创作者风格一致的长文本生成;金融与企业服务场景中用于电子签名样式个性化(如合同展示、客户沟通信函),提供自然书写体验。数字文具应用可让用户用少量样本生成个人手写字体,用于日记、便签等。
商业价值
- 降本:替代人工手写服务(定制贺卡、邀请函等),自动生成逼真手写内容,边际成本大幅降低。
- 增收:提供 API 或 SDK 给第三方应用,按调用量计费;或作为增值功能提高订阅转化。
- 体验提升:相比传统字体引擎,BoundInk 显式建模字符间连笔与间距,显著提升书写真实感。论文盲评中 78.0%–82.6% 的偏好率证明用户感知价值明确,可增强用户粘性与品牌差异化。
与现有产品/工作流接口
- 输入输出:输入文本序列 + 目标书写者风格参考(少量笔画样本或特征向量);输出在线轨迹点序列(
x,y, 时间戳),可直接渲染为 SVG 动画、短视频或嵌入 PDF。 - 集成方式:作为微服务部署,对接内容管理系统(CMS)的文本渲染模块;封装为轻量级 ONNX 模型,支持移动端离线生成。
- 训练与数据:兼容现有手写数据集(IAM、BRUSH、中文协议),支持跨数据集合并训练,降低数据准备成本。
- 互补场景:生成数据可用于手写识别系统数据增强,提升 OCR 鲁棒性,形成数据闭环。
局限
- **依赖显式边界标注**。BoundInk 将字符间边界作为显式生成单元,训练与监督均需精确的字符边界真值。然而真实在线手写数据(尤其是连笔严重的草书、历史文献或低资源文字系统)通常只提供笔画序列,缺少字符级分割标注。这要求额外的人工标注或边界检测预处理,可能引入噪声并限制方法在大规模无标注笔迹数据上的直接应用,削弱其可扩展性。
- **Bigram 局部解码的长程依赖不足**。虽然方法融合了 surrounding text context,但其核心解码器基于 Bigram 建模相邻字符对,归纳偏置可能难以捕捉整行级别的书写风格一致性(如全局基线倾斜、段落级字距变化)。对于长文本生成,逐对解码可能产生累计漂移,且无法显式建模非相邻字符间的远距离依赖(例如某个字符的习惯性连笔方式受更前方内容影响)。
- **评估框架的泛化性与基准代表性有限**。论文提出的 boundary-aware metrics 聚焦连笔与间距,但缺少与传统感知质量指标(如 FID、LPIPS)的系统对比,难以全面反映生成笔迹的视觉真实感。人类评估虽显示高偏好,但样本量与评判者背景未详细披露。此外,merged English dataset 与 Chinese protocol 的规模及多样性可能不足,且经过特定归一化(如高度、倾斜校正),在更复杂或未对齐的真实书写场景下的鲁棒性尚待验证。