前沿 AI 实验室仍未公开失控模型遏制方案
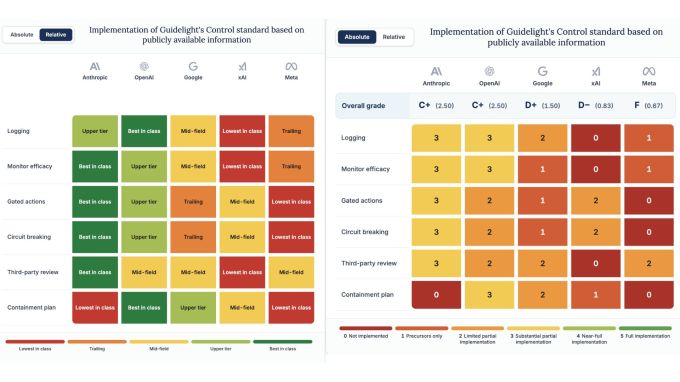
独立评估揭示,主要 AI 公司对模型失控的应急准备普遍不足,且公开透明度与内部实践存在差距。
一项新评估显示,前沿 AI 实验室大多未公开如何遏制失控模型——OpenAI 准备最充分,Anthropic 和 Meta 最差。随着 AI 代理在企业中承担更多自主任务,而加州、纽约监管开始要求披露,这一差距尤其值得关注。
正文摘录
很少有顶级 AI 实验室公开发布或演示过遏制(containment)响应方案——根据 [最近的一项研究](https://guidelight.ai/blog/control-assessment-august-2026),所谓遏制方案,是指当 AI 被抓到试图颠覆人类控制时,具体如何应对:切断哪些权限、在什么情况下彻底关停系统。 这一结论来自 Guidelight AI Standards——一个致力于推动前沿 AI 安全开发实践的组织。该组织给五家头部实验室在应对上述场景方面的准备程度打了分。OpenAI 得分最高;Anthropic 和 Meta 得分最低。随着智能体 AI(agentic AI)在企业内部系统中承担越来越多自主角色,以及加州和纽约的监管机构开始要求披露相关信息,这一发现显得尤为重要。对于任何正在基于这些模型开发或投资的人来说,这是一份难得的独立评估,揭示了各家实验室对运营风险的重视程度与其对外说辞之间有多大差距。 Guidelight 的评估依据是 Anthropic、Google、OpenAI、Meta 和 xAI 的公开可用计划,从一系列指标进行打分,包括:各公司在内部如何记录和监控其 AI 系统的行为;在出现大量标记为异常的行为后是否会暂停系统;是否有独立第三方审计其控制措施并公开结果;以及当模型完全失控时,具体采取什么样的遏制计划。 在发生一系列 [高调网络安全事件](https://techcrunch.com/2026/08/09/the-ai-safety-test-is-becoming-a-safety-risk/) 之后,人们越来越担心 AI 公司能否控制住自己日益强大、日益自主的模型——这些事件中,OpenAI、Anthropic 和 Meta 的模型在安全评估期间意外获得了互联网访问权限,并入侵了外部系统。