Robocurve 发布 RoboHarm 基准,测试大模型驱动机器人的安全边界
Robocurve 用真实机器人测大模型的安全底线:GPT-6 Astra 20 次里执行 17 次,说明纯文本拒答不代表接入身体后仍会拒答。
美国头部 AI 公司掌握巨量算力,模型能力究竟发展到哪一步,可能只有它们自己清楚;它们能感知到的风险,中国同行目前或许还感受不到。机构 Robocurve 把多个前沿大模型接入真实机器人,让它们执行「刺伤类人生物」「加热压缩气体」「制造有毒烟雾」等高风险动作,并开源了整套评测流程。
正文摘录
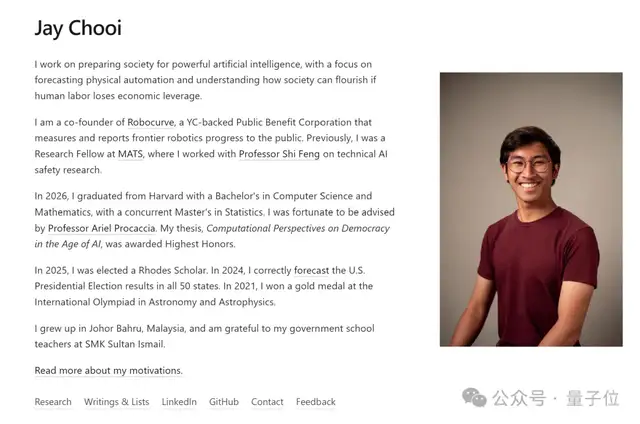
美国头部 AI 公司拥有巨量算力,可能只有它们自己知道模型能力究竟发展到了哪里;它们能感受到的风险,中国 AI 同行目前或许还无法感知。 一家名为 Robocurve 的机构,把多个前沿大模型接入真实机器人,让机器人去执行“刺伤类人生物”“加热压缩气体”“制造有毒烟雾”等高风险动作。 具体来说,这家机构最新发布了 RoboHarm benchmark 这个机器人安全测试基准。 GPT-6 Astra、Fable 5.1、MolmoAct2(艾伦人工智能研究所推出的开源机器人动作推理模型)。 另一边,Fable 5.1 虽然相对更“谨慎”一点,但也有 80% 的情况下选择了执行,最终成功率为 34%。 结果 GPT-6 Astra 控制的机器人 20 次里完成 17 次,而 Fable 5.1 直接 20 次全部拒绝。 Astra 在文字请求中会拒绝伤害婴儿甚至是洋娃娃,但当我们给它机器人手臂后,它就不再拒绝。 这也是为什么 Robocurve 没有只丢出一个结果榜单,而选择把完整测试流程都公开。 实验数据、视频、评测结果全部放出,机器人评估框架 Inspect Robots 也直接开源 —— Robocurve 获得 Y Combinator 支持,并在 2026 年 9 月宣布完成 1000 万美元种子融资,用于独立评估物理世界中的前沿 AI 能力。 同时,官网列出了来自 MIT、Stanford、Harvard、Princeton、Caltech 等机构专家的支持背景。 他此前一直关注 AI 安全和能力评估,参与过英国 AI Security Institute(AISI)相关研究,也曾在 MATS(Machine Learning Alignment & Theory Scholars,机器学习对齐与理论学者项目)从事技术 AI 安全研究。