何恺明团队用 ImageNet MAE 预训练打通 ARC 视觉路线 scaling
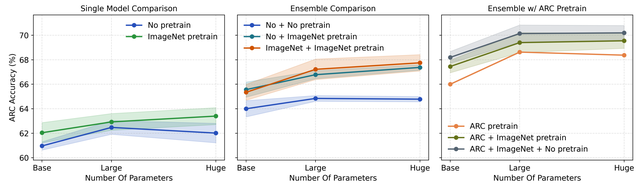
不靠大语言模型,只用在 ImageNet 猫狗花草上预训练过的视觉模型解 ARC 抽象推理题,并证明预训练能让视觉路线越做越大、越做越好。
MIT 团队提出 NAT-ARC:不做文本翻译,直接用视觉模型处理 ARC 彩色格子。做法是把 MAE(一种自监督视觉预训练方法,让模型从部分遮挡的图片里还原缺失部分)在 ImageNet 上训出的 encoder 权重拿来初始化,只保留特征提取能力。单模型 0.6B 参数拿到 63.4% pass@2,集成约 2B 参数达 70.2%。
正文摘录
它不靠 LLM,用 ImageNet 上的猫狗花草做预训练,让模型学会「看」,再迁移到抽象格子推理上。 结果,NAT-ARC 表现最好的单模型在 ARC-1 上跑出了 63.4% 的 pass@2 分数,集成后达到 70.2%。 ARC,公认最难的 AI 视觉智力测验之一,给你几个彩色格子的输入输出示例,让你推断背后隐藏的变换规则,再应用到新格子上。 ARC 全称 Abstraction and Reasoning Corpus,由 Keras 之父 François Chollet 在 2019 年提出。 ARC 里每道题的格式很统一,一块最大 30×30 的二维格子,最多 10 种颜色,题目给 2 到 5 组输入输出示例,挑战者需要从示例中推断出隐藏的变换规则,再把这条规则应用到一个全新的输入格子上,预测它的输出。 目前 ARC 赛道上占据统治地位的几乎全是大语言模型方案,这些方案的共同思路都是把格子翻译成文本或符号序列,交给语言模型处理。 一批研究者走了一条完全不同的路,他们不把格子翻译成文字,改成了用视觉模型直接处理格子图像。 其中最重要的一步来自同一个 MIT 团队提出的 VARC,这个方法把 ARC 重新定义为条件图生图翻译任务,用 19M 参数的视觉模型跑到 54%。 Loop-OWM 用视频预训练模型做 few-shot,10.6M 参数达到 68.5%。 LLM 之所以能在 ARC 上越做越好,核心原因之一是它们通过海量语料预训练,积累下了通用能力,模型越大、预训练越充分,在下游任务上的 scaling 就越明显。 在此基础上,NAT-ARC 的目标就是给视觉路线补上预训练这一步,试着打通它的 scaling 瓶颈。 NAT-ARC 的核心思路,是在 VARC 的视觉流程前面插入一步 ImageNet MAE 预训练。