AI 推理的隐藏存储成本:后端数据量可达输出文件的 130 倍
文章拆解 AI 推理长期被低估的存储账单:后端数据量远超用户看到的输出,而且不会随算力需求的回落而减少,因此存储规划需要按数据生命周期分层来做。
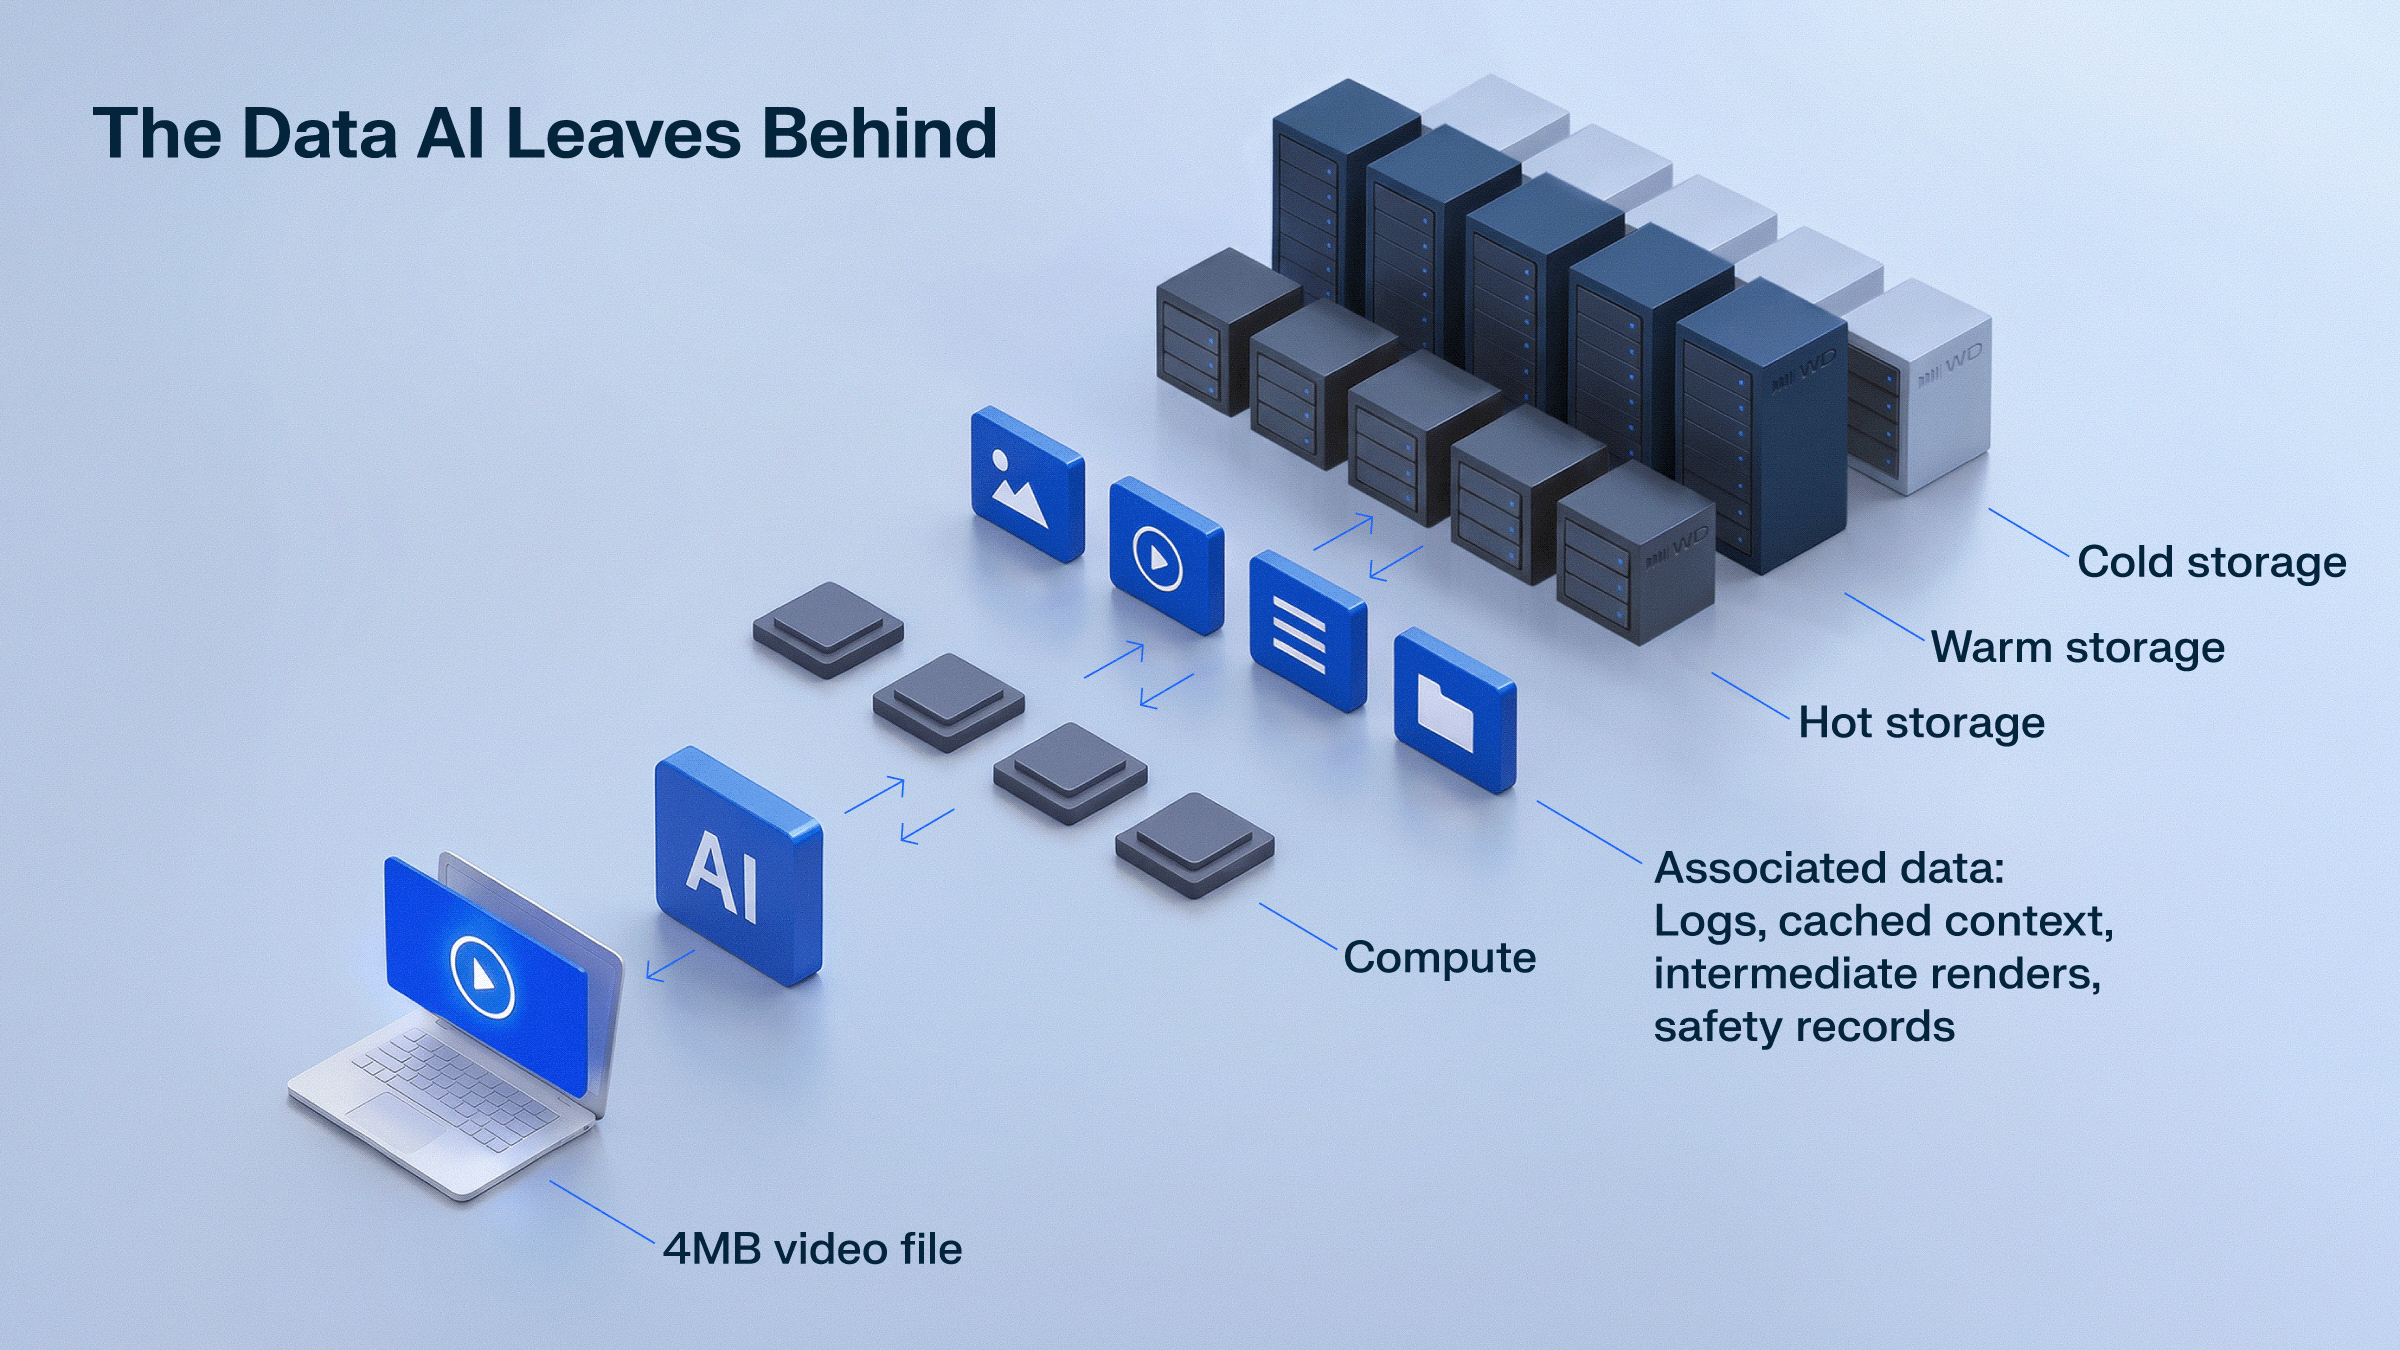
多数高管估算 AI 成本时只想到 GPU 算力,却忽略了存储。训练是一次性项目,推理却持续运行;每次请求都在后端留下日志、缓存、渲染件和备份。WD 实测:用户拿到的一段 8 秒视频是 3.97MB,后端为此留下的数据超过 500MB。
正文摘录
如果让大多数高管想象 AI 的成本,他们大概率会想到 GPU——成排的加速器、数以吉瓦计的电力——以及一份等待硅芯片的名单。但这幅图景漏掉了一样东西:数据存储成本。  模型给出响应之后,数据会怎样?每天数十亿次的提示词、图像和视频所产生的大量后端数据都需要被存储。但数据存储是较难规划的基础设施成本之一,而且在最初的 AI 基础设施规划中常常被忽视。 随着推理规模扩大,数据足迹也随之增长 传统上,AI 基础设施的讨论一直集中在训练模型这一计算密集型过程上。训练是有限的:一次运行开始、消耗算力,然后结束。但推理是持续运行的,模型每回答一个提示词,就会运行一次。对基础设施规划来说,这种差异很重要:一次训练运行是一个可以编制预算并在完成后退役的项目。推理不会退役;每一个推理请求都会留下一些东西。 以 AI 生成的视频为例。在这类工作负载中,后端支出可能相当可观。根据内部测量,WD 发现一段 8 秒的片段(返回给用户的是 3.97MB 的 720p 文件)在后端留下了超过 500MB 的关联数据,包括日志、缓存上下文、即时渲染结果、备份和安全记录。这比用户看到的输出文件大小增加了 130 倍。若将其扩展至生成更长、更高分辨率视频的企业,每个片段的后端足迹会增长到数百 GB。 而且这一后端足迹正在快速增长。