微软发布深度学习 DFT 模型 Skala 1.1,并集成到多款主流计算化学软件
微软发布更精准的深度学习 DFT 模型 Skala 1.1,并逐步集成到主流化学计算软件中,让高精度模拟更易用。
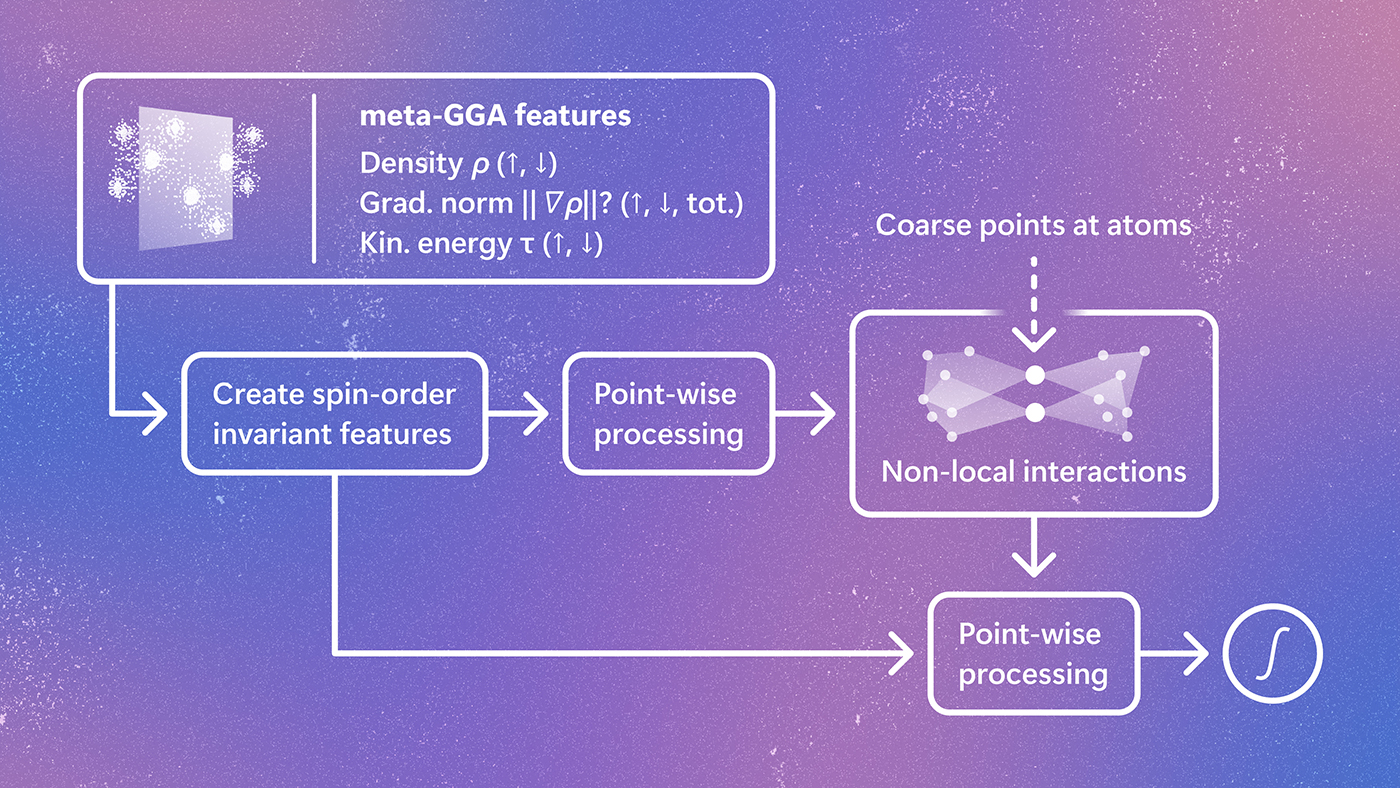
Skala 是微软研究院开发的深度学习泛函,用于密度泛函理论(DFT)计算——一种通过电子密度近似求解量子化学方程的方法。新版 Skala 1.1 训练数据量达到前代的 2.5 倍,在热化学、反应动力学和分子结构预测等任务上精度显著提升,计算成本却只相当于中等水平泛函。更重要的是,Skala 现已接入 CP2K,并正在整合进 Psi4、FHI-aims、ORCA 和 VASP 等常用软件。微软还推出了一个持续更新的性能基准,方便社区跟踪各版本的实际表现。
正文摘录
 概览 - Skala 1.1 展示了微软研究院深度学习 DFT 方法持续改进的特性:训练数据量是前代的 2.5 倍,在关键分子模拟挑战中实现了显著更高的精度,涵盖热化学、反应动力学和分子结构预测等方向。 - Skala 现已可在 CP2K 中使用,并正在集成到 Psi4、FHI-aims、ORCA 和 VASP 中,让依赖这些代码的日常用户更接近下一代 DFT 精度。 - 微软研究院还推出了一个“活基准测试”,用于追踪不断优化迭代的 Skala 各版本的性能表现,帮助社区衡量并加速通向更高精度与效率的进步。 - 这些进展共同标志着迈向未来计算化学模拟兼具预测性与普适性的又一里程碑——使其能够融入各类相关科学与工业工作流程。 将密度泛函理论(DFT)提升到预测级精度是一场长跑,而非一蹴而就。 自从我们[推出 Skala](https://www.microsoft.com/en-us/research/blog/breaking-bonds-breaking-ground-advancing-the-accuracy-of-computational-chemistry-with-deep-learning/)(我们的深度学习交换关联泛函)以来,我们沿着两条互补的路线持续推进:提升精度,以及扩大在计算化学生态系统中的可及性。 ![图 1:Skala-1.1 与竞争性密度泛函在 GMTKN55 的 55 个子集上的误差表。