Databricks 为 Lakebase Postgres 推出向量与全文搜索扩展
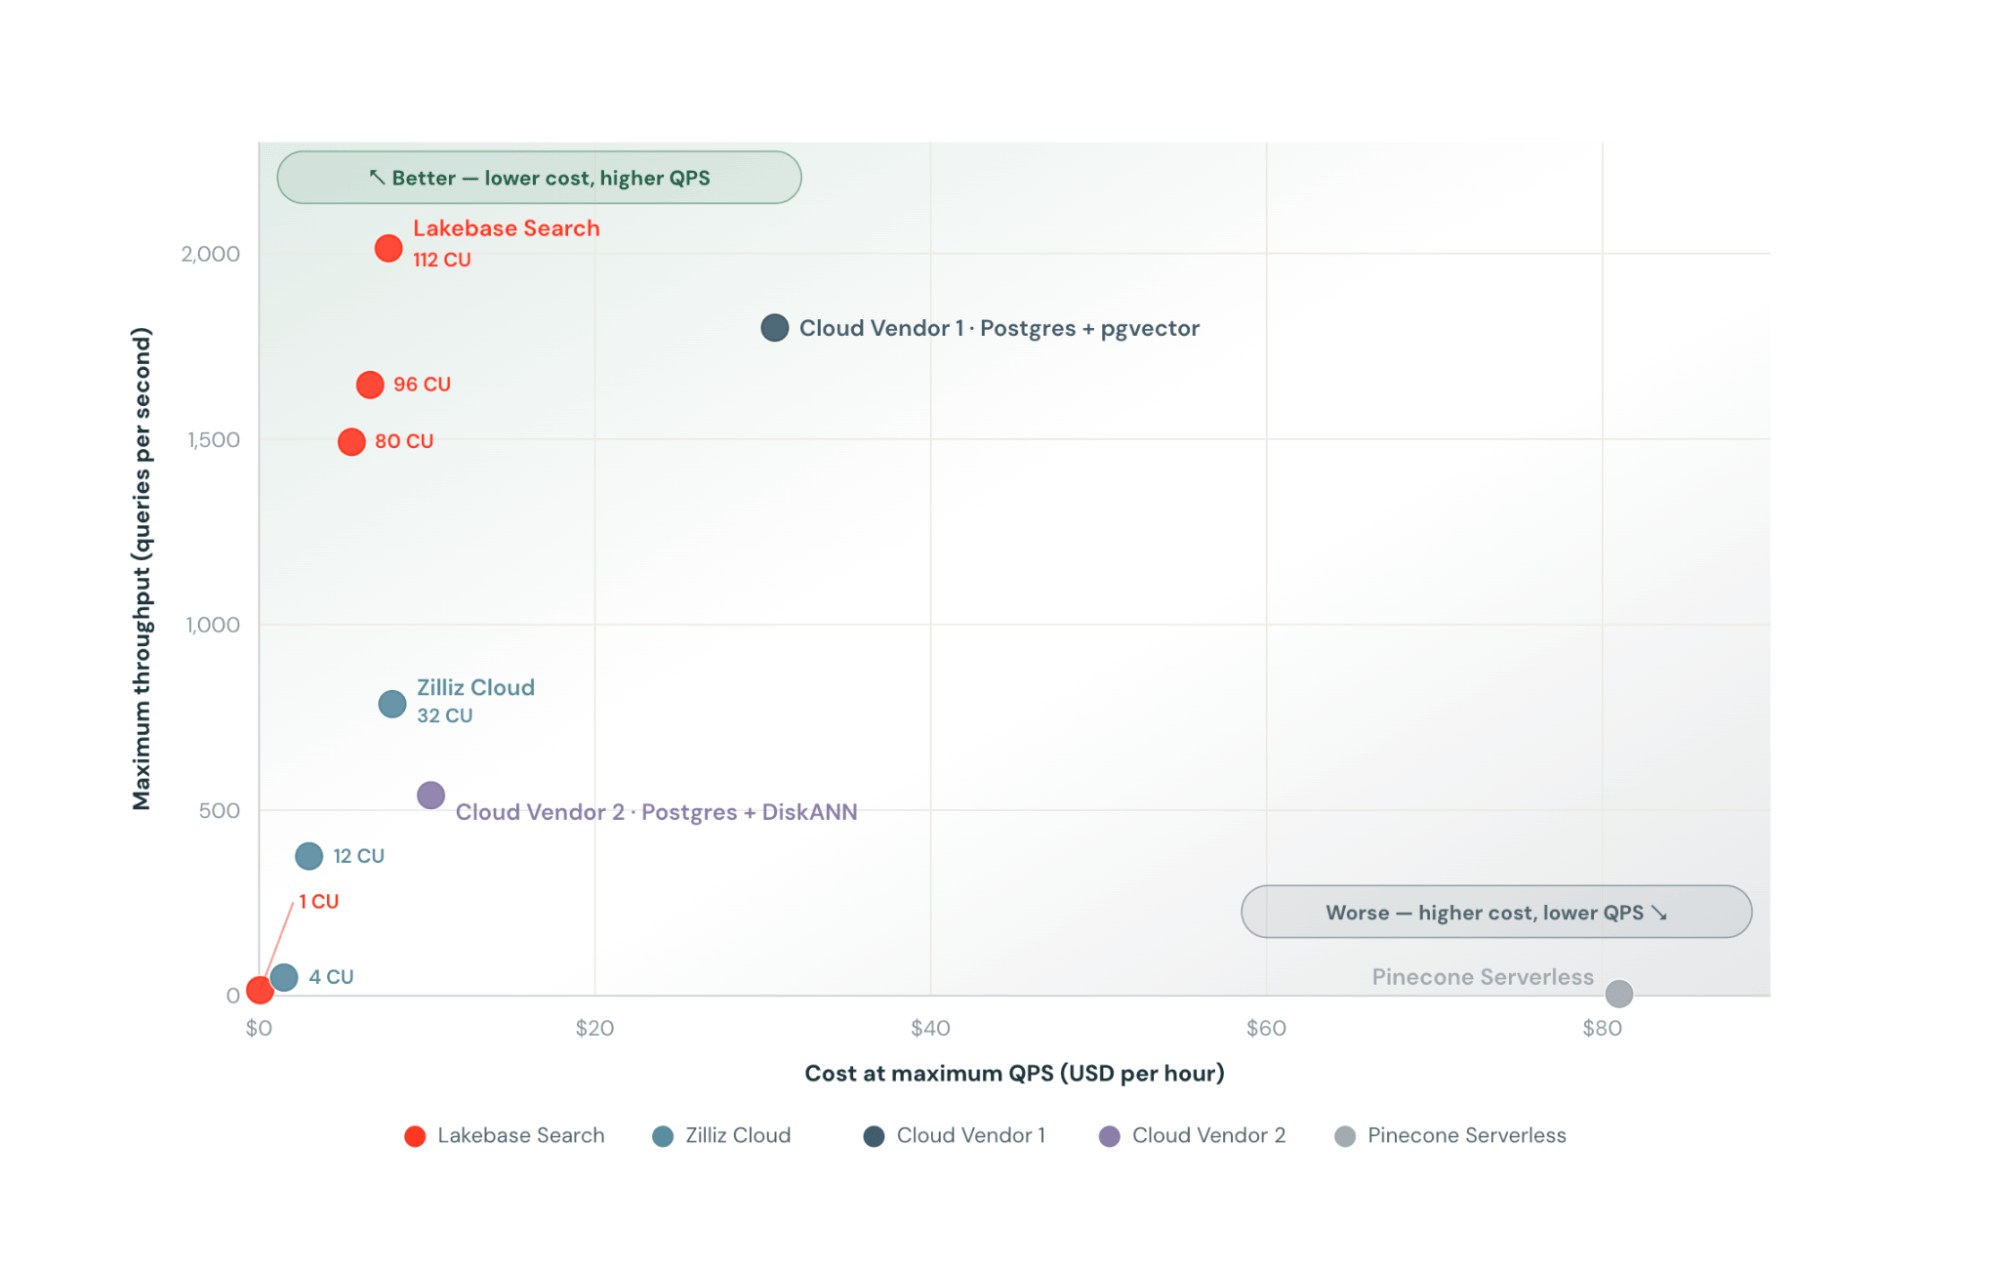
Databricks 把向量检索与 BM25 全文搜索内置进 Lakebase Postgres 并正式发布,让 OLTP 数据库直接跑 AI 检索负载,不必再单独搭一套搜索系统。
Databricks 为 Lakebase Postgres 加上快速、可弹性伸缩且 serverless(无需自行管理服务器)的搜索能力,现已正式可用。它由 lakebasevector(向量近邻搜索)和 lakebasetext(BM25 全文搜索)两个扩展实现,让原本只跑 OLTP 事务的数据库直接承担向量与全文检索负载。
正文摘录
Postgres 中的快速、可扩展且无服务器(serverless)的搜索,现已正式可用(GA) 作者:Zhou Sun、Jinjing Zhou、Keming Yang、Usamoi Cui、Pranav Aurora 和 Junyu Chen 传统 OLTP(在线事务处理)系统并不是为 AI agent 的搜索需求而构建的。它们需要在所有数据上做低延迟、高准确率的检索,而且经常要执行大规模并行搜索。到目前为止,解决这个问题意味着用 ETL(抽取、转换、加载)管道,把一个独立的搜索引擎硬接到你的主数据库上。 但如果你的 OLTP 数据库本身就能高效跑搜索负载呢? 今天,我们通过两个扩展把快速且可扩展的搜索引擎带到 Lakebase Postgres:lakebasevector(可扩展的近似邻居搜索)和 lakebasetext(BM25 全文搜索)。这两个扩展现已在 AWS 和 Azure 上正式可用。 借助 lakebasevector,Postgres 现在站到了向量搜索的前沿。它在效率和可扩展性上超过了专用搜索引擎。在 VectorDBBench 100M 基准测试中,它的吞吐量是第二好系统的两倍,成本比使用 pgvector 的云 Postgres 厂商低 4 倍,而且这还没有算上 autoscaling(自动扩缩容)带来的额外节省。 它在不牺牲准确率的前提下保持这种性能。在我们的测试中,lakebasevector 在 97% recall(召回率,即成功检索到真实最近邻的概率为 97%)下实现了 71 毫秒的 P99 延迟。 Lakebase Postgres 现在具备最先进的搜索能力。我们看到像 Conexiom 这样的客户,在超过 1 亿行数据上运行基于 BM25 的混合搜索,计算资源占用只有他们之前 pgvector 方案的一半。