Databricks 如何让 14000 名员工在模型发布首日接入新模型
Databricks 公开了内部模型放行流程:新模型首日全员可用但先标记为实验性,靠跑分、用户反馈和成本追踪三条信号,几天内决定是否转正。
Databricks 把新模型的内部放行拆成一条流水线:所有调用先过自研的 Unity Gateway(公司内部统一的 AI 网关,负责治理、成本与可观测性),再由装在员工笔记本上的 UG CLI 自动把配置推给 Claude Code、Codex 等客户端。新模型先打上 Experimental 标签、走独立预算,用几天数据判断它值不值得长期保留。
正文摘录
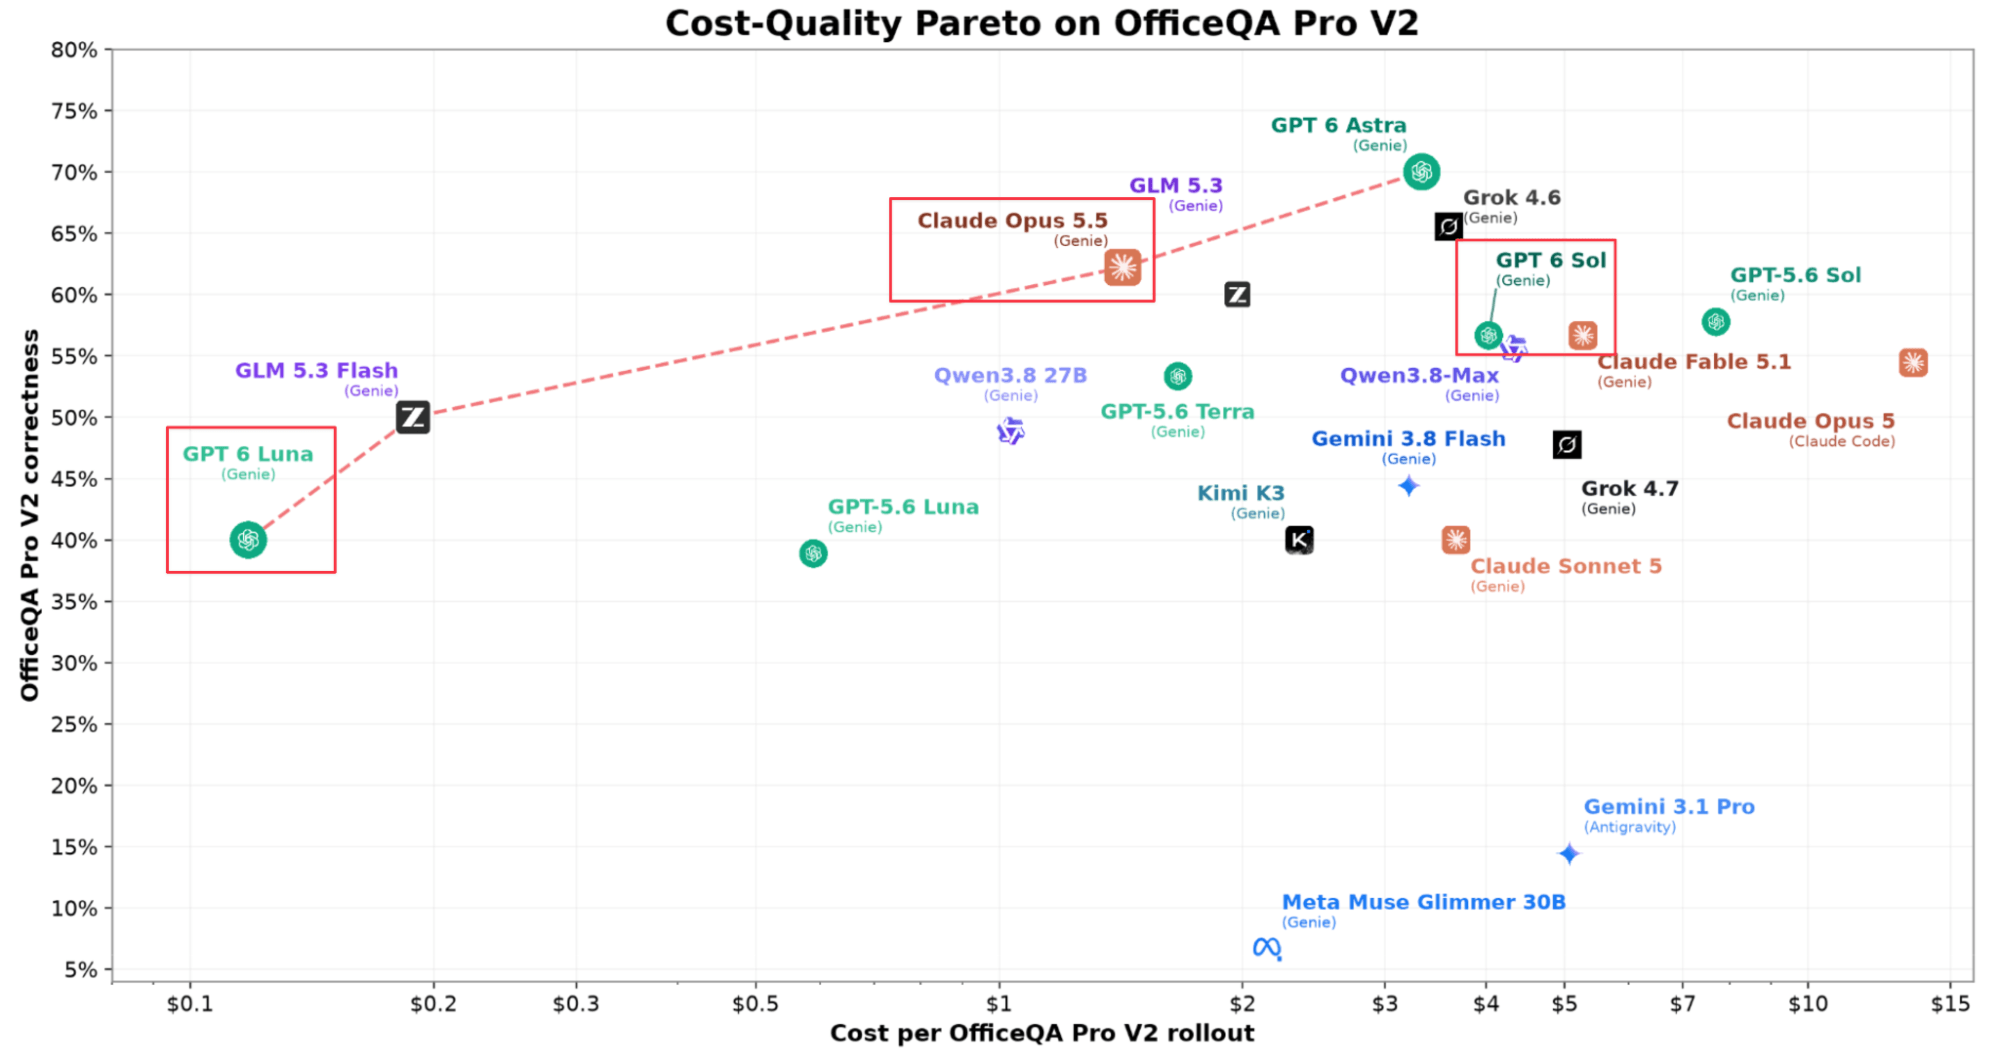
作者:Databricks AI 产品与工程团队 为员工提供前沿 AI 能力,是 Databricks 的头等大事;因此,让员工在新模型可用时立刻就能用上,对我们同样重要。但与此同时,要让超过 10,000 人在新模型发布后迅速用上它,并不是件小事,原因在于: 本文讨论了我们采用的一套技术手段,让 Databricks 的大多数员工都能在新模型发布当天(Day 1)就用上它们,同时让我们能够评估某个模型是否真的适合长期作为主力(workhorse)。这些手段在很大程度上依赖 Unity Gateway 来对模型进行自适应发布、评估与集成。9 月 21 日那一周,是对这套能力的一次关键考验:Opus 5、GPT-6 Sol 和 GPT-Luna 在短时间内接连发布。那一周里,Databricks 为全体员工提供了 Day 1 访问权限;到第 3 天,我们已经收集到足够数据,确认这些模型处于效率前沿(efficiency frontier),于是将它们纳入了更广泛的基础设施。 从整体上看,Databricks 上新模型的发布流程大致如下: 为了让跨闭源与开源模型提供方的模型管理更简单,我们在所有内部使用场景中都采用自家的 Databricks Unity Gateway。它是我们在 AI 治理、成本管理与可观测性方面的中央枢纽,因此从这里着手也是顺理成章。 Gateway 是我们让全体员工访问新发布模型的地方。但仅靠服务端配置还不够。我们的员工在笔记本上使用 Claude Code、Codex 以及 Omnigent 这个 meta-harness,我们需要把新的模型配置分发到他们手上。 这就是 Unity Gateway CLI(UG CLI)的用武之地。UG CLI 已经通过我们的移动设备管理(Mobile Device Management)部署在每个人的笔记本上。