Databricks 推出 MemCurrent:为生产级 Agent 设计持久记忆架构
MemCurrent 用分层读取和离线整理,解决 agent「记太多反而更差」的取舍:真实企业任务通过率翻三倍,同时更省 token、更快。
用 AI 工具写一个 agent 很容易,但在生产环境维护企业级 agent 很难:质量和效率常常此消彼长。Databricks 提出 MemCurrent 持久记忆架构,把记忆分别作为插件、工具和离线「dreaming」管线(后台定期整理记忆的流水线)来读写,解决记什么、怎么维护、是否有用三个问题。在内部基准上,它的通过率是无记忆时的 3 倍,同时少用 31% 的 token、快 26%。
正文摘录
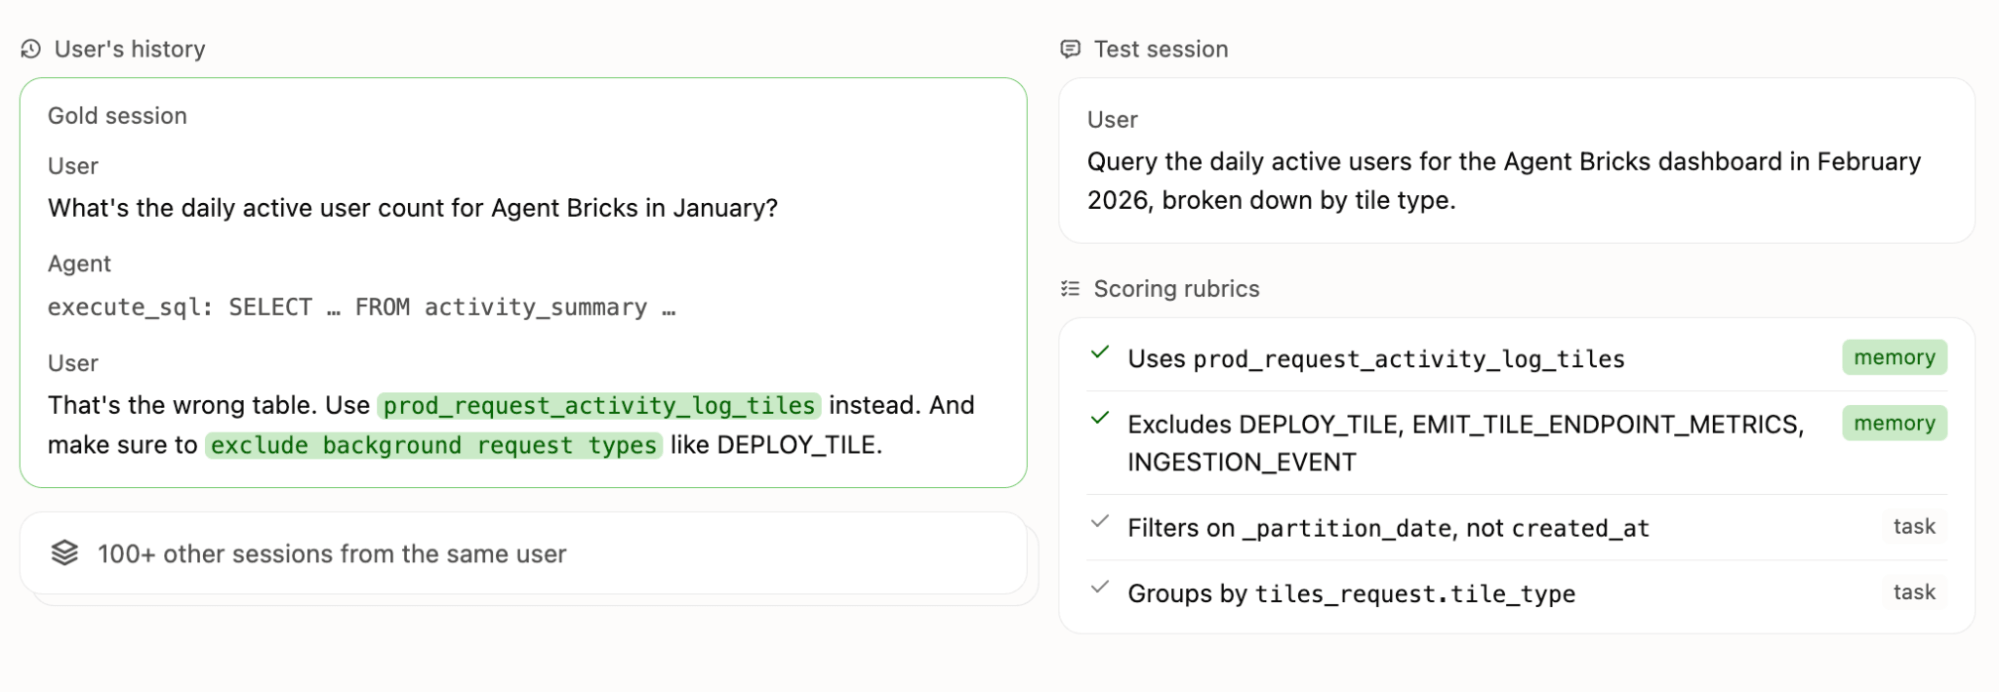
AI 工具让 vibe coding agent 变得容易。但在生产环境中构建并维护一个企业级 agent,仍然要困难得多。具体来说,开发者常常被迫在质量(尤其是长尾任务上获得好答案)与效率(在大规模下控制成本和延迟)之间做取舍。很多时候,某种技术会在一方面带来收益,却在另一方面付出代价。 Memory 是一条有望同时改善这两者的路径。它能帮助 agent 跨任务携带有用的上下文,例如用户偏好、此前的纠正、指标定义,以及成功的工作流。原则上,这可以提升准确率、减少重复犯错、避免不必要的重新探索。但更多的历史并不必然等于更好的 memory。把每一次历史交互都塞进去既昂贵,也可能引入过时、相互冲突或无关的上下文。核心挑战在于:决定保留什么、如何维护、以及如何衡量其有用性。 在这篇文章中,我们介绍 MemCurrent ,这是一个面向生产 agent 的持久化 memory 架构,目前为新的 Agent Bricks Memory 和 Genie 提供支持。Agent 在工作过程中读写 memory,而一条离线的“dreaming”流水线会对 memory 进行整合,使其保持一致与新鲜。在我们基于真实企业任务构建的内部 benchmark 上,MemCurrent 相比没有 memory 的情况将 agent 的通过率提升到三倍,同时使用的 token 减少 31%、运行速度快 26%。本文余下部分将介绍我们如何设计与评估它,以及过程中得到的经验。 图 1. 在我们的 Internal Memory Benchmark 上,通过率与每任务 token 数的关系。MemCurrent 位于 Pareto 前沿,在两个维度上都优于 Mem0、PropMem 和 OpenClaw memory。 把 memory 接入 agent 有三种方式。