蚂蚁百灵发布Ling-3.0-Flash,124B参数对标行业领先模型
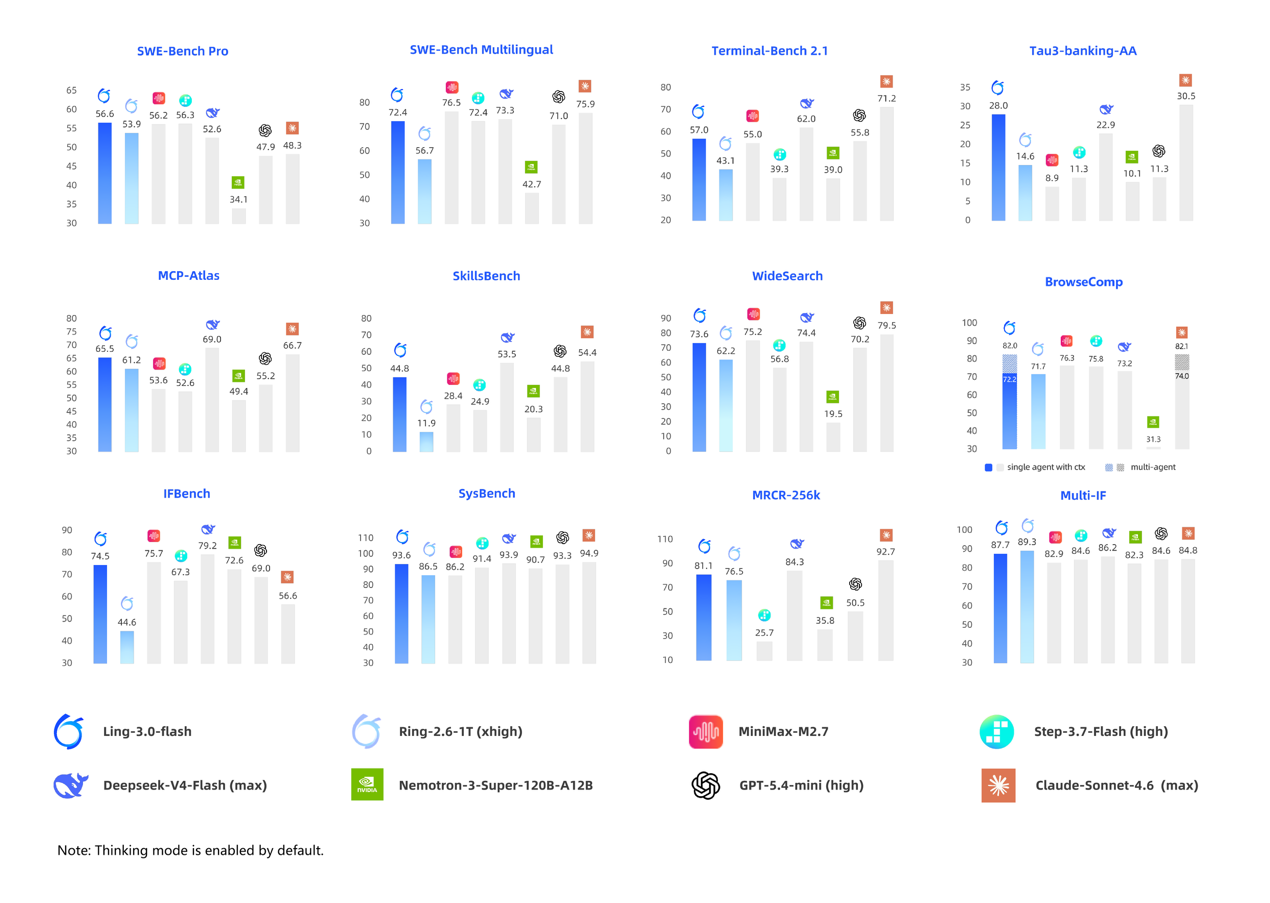
蚂蚁百灵发布Ling-3.0-Flash,以124B总参和5.1B激活参数量实现高智效比,对标大模型,并专注Agent落地,已上线免费测试。
蚂蚁百灵发布新一代原生混合推理模型Ling-3.0-Flash,总参数124B,但每次推理仅激活5.1B参数(一种稀疏激活技术,大幅降低算力)。在推理、指令遵循等指标上对标参数多2-3倍的模型,已上线OpenRouter限时免费,之后开源。针对Agent场景优化,扩展超10000个真实交互环境,提升自我纠错与长程规划。关键创新是混合注意力架构和专家激活压缩至1/64。
正文摘录
7 月 24 日,蚂蚁百灵正式发布新一代原生混合推理模型 Ling-3.0-Flash。该模型总参数量 124B,单次计算激活 5.1B。在大幅精简体量与降低算力开销的同时,Ling-3.0-Flash 在基础推理、指令遵循及长文本处理等核心指标上,对标甚至超越了参数规模达其 2 至 3 倍的行业领先模型,展现出更高的“智效比”与落地性价比。据了解,该模型已上线 OpenRouter,限时免费一周,之后将正式开源。  作为该版本的重点,Ling-3.0-Flash 针对 Agent 的实际应用场景进行了深度打磨。模型扩展了超 10000 个真实交互训练环境,并优化了复杂任务的自我纠错与长程规划机制。无论是在代码编写、复杂任务拆解,还是多源信息深度调研等场景中,Ling-3.0-Flash 均展现出更强的自主闭环交付能力,解决了传统模型在大任务中容易“跑偏”或断档的难题。 据介绍,实现“小体量、高智能”的关键,源于模型底层计算架构的重新设计。Ling-3.0-Flash 放弃了单纯堆砌参数的思路,从预训练阶段即采用混合注意力架构,以 5:1 的比例交替堆叠 KDA 线性注意力层与 MLA 层,让模型在长上下文效率与模型能力之间实现更优平衡。 此外,Ling-3.0-Flash 将上一代的 Lightning Attention 升级为 KDA(Kimi Delta Attention),在 Delta Rule 的状态更新中引入细粒度对角门控,让模型在处理长文档和代码库时能更精准地记住关键信息。