综述提出智能体自我改进统一框架,区分模型更新与系统更新
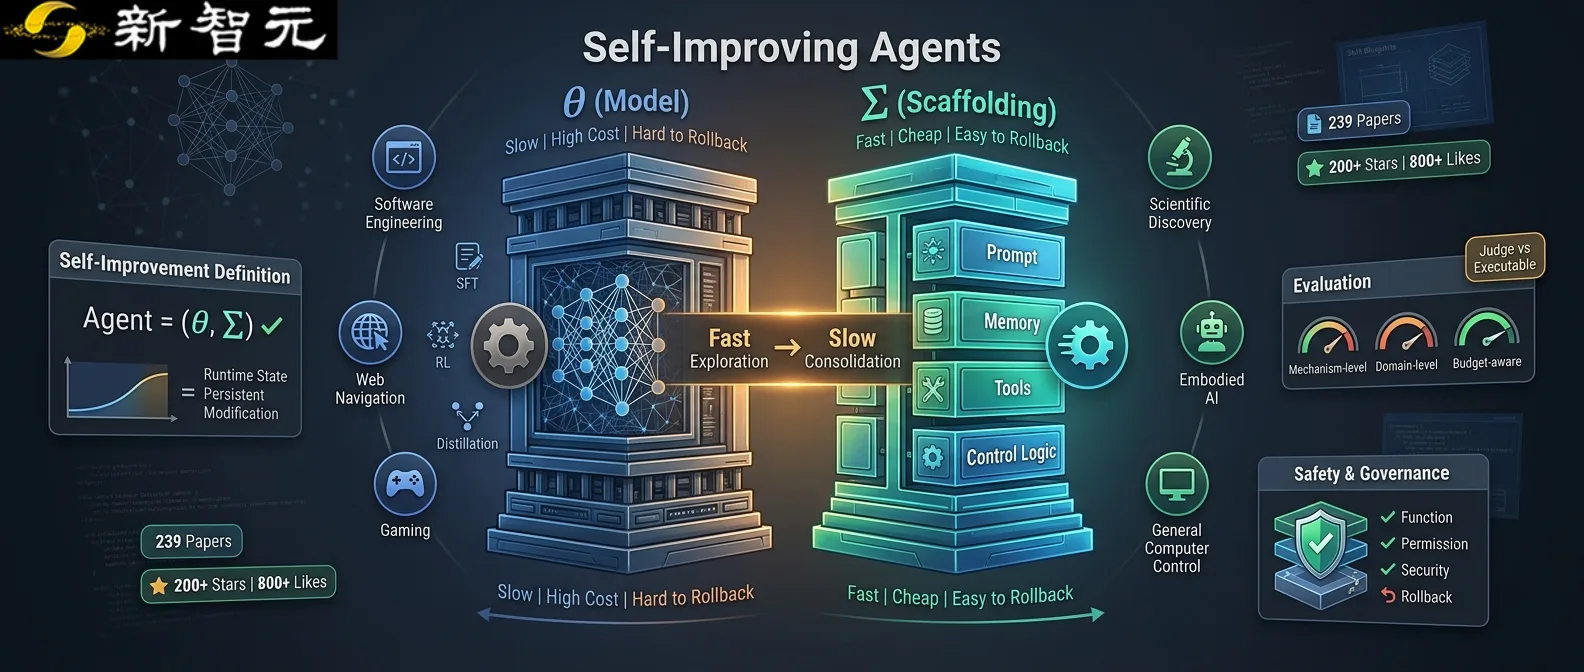
这篇综述为 AI 自我进化建立统一坐标系,厘清概念并区分两条技术路线,是理解该领域的重要地图。
智能体(能自主决策的 AI 系统)的“自我改进”被重新定义:只有持久修改模型参数或外围脚手架(提示词、记忆、工具等),并让下次任务从新起点出发,才算真正自我进化。综述将模型训练与系统改写纳入同一框架。
正文摘录
- title: LSTM 之父最新 97 页综述:Agent 如何真正学会「自我进化」? - sourcecompany: 新智元 - bodymarkdown:  新智元报道  过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent 等概念不断涌现。 它们有时指模型继续训练,有时指 Prompt 或工具自动优化,也有时被直接归入递归式自我改进(Recursive Self-Improvement,RSI)。 问题在于,这些术语描述的变化层级和强度并不相同,却长期缺少一套统一坐标系。 近日,来自吉林大学、KAUST、阿尔伯塔大学和瑞士人工智能实验室等机构的研究团队发布综述,从系统层面重新定义「自我改进」,并将模型训练、记忆演化、工具创建和 Agent 架构搜索放进同一张地图。配套项目目前已整理 312 篇相关工作。