清华与沃顿学者用GPT-5.6证明梯度下降纯步长调度存在收敛极限
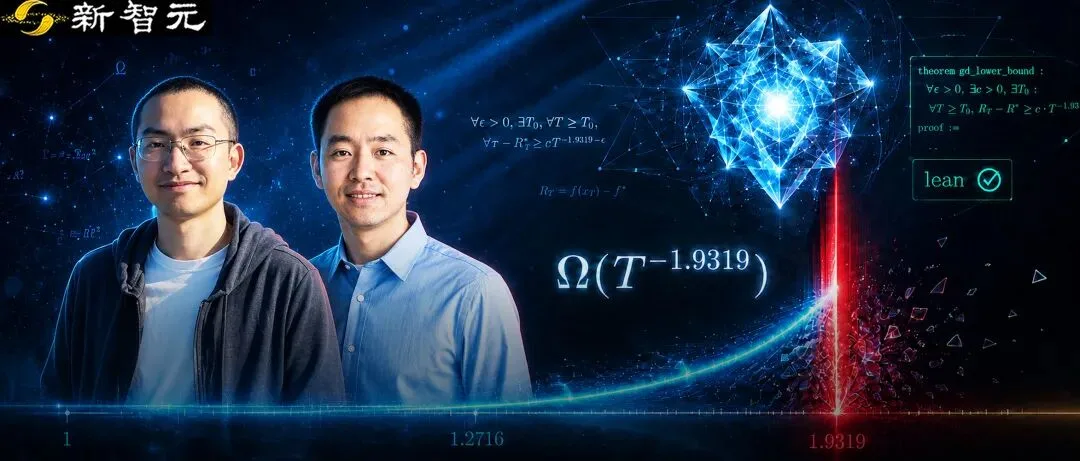
这项研究首次证明梯度下降仅靠调步长存在数学天花板,且核心证明由AI完成,人类只负责监督。
梯度下降(训练AI模型的基础优化算法)靠调整步长序列能跑多快?清华和沃顿的研究者用GPT-5.6给出了40年未解的下界证明:纯调步长无法达到Nesterov加速的O(1/T²)收敛速度,极限指数约为1.9319。完整证明已用Lean 4形式化验证,零跳过。
正文摘录
 新智元报道  训练一切 AI 的算法,被 AI 自己判了「死刑」? 就在最近,清华大学和宾大沃顿商学院的两位研究者挂出一篇新论文,给了一个优化理论界等了 40 年的结论—— 梯度下降想跑到最快,光调步长没用。   这是历史上第一次有人证明,梯度下降光靠设计步长序列,存在一道跨不过去的数学天花板。 而且,完成核心证明的不是人,是 GPT-5.6 Sol Pro。  GPT-5.6 搞定了一个 40 年没人答过的问题 事情是这样的。 梯度下降大家都知道,从 GPT 到 Stable Diffusion 到自动驾驶,底下跑的都是它。标准梯度下降的收敛速度是 O(1/T),跑 T 步,误差大概降到 1/T 的量级。 1983 年,Nesterov 给梯度下降加上动量,直接推到了 O(1/T²) 。同样跑 1000 步,误差从千分之一变成百万分之一,差三个数量级。