hindsight
面向 AI Agent 的长期记忆层,把世界事实、经历、观察和心智模型分层组织,通过 retain/recall/reflect 三个操作让 agent 跨会话积累并巩固知识。与纯向量检索或知识图谱不同,它并行跑语义、关键词、图、时间四种召回再做融合重排,官方称在 LongMemEval 上取得领先成绩,并配套 60+ 框架与 coding agent 集成、内置 MCP endpoint 以及 Docker/Helm/嵌入式多种部署方式。MIT 协议,另有商用 Cloud 版本。
README
文档 • 集成 • Cookbook • 基准测试 • 论文 • Hindsight Cloud


Hindsight 是什么?
Hindsight™ 是一套 agent 记忆系统,旨在打造会随时间学习、越来越聪明的 agent。大多数 agent 记忆系统专注于召回对话历史。Hindsight 的目标是让 agent 学会学习,而不只是记住。
它消除了 RAG 和知识图谱等替代技术的不足,并在长期记忆任务上达到了业界领先(SOTA)水准。
目录
- 记忆性能与准确性
- 快速开始 — 服务端 · 客户端 · 平台 · 嵌入式
- 将 Hindsight 接入你的 Agent — LLM Wrapper · 集成 · 编码 agent · MCP
- 核心概念 — 记忆类型 · retain / recall / reflect · observations · mental models 与 knowledge pages · banks
- 使用场景
- 生产环境部署
- 资源
记忆性能与准确性
根据基准测试表现,Hindsight 是目前测试过的最准确的 agent 记忆系统。它在 LongMemEval 基准测试上达到了业界领先水准,该基准被广泛用于评估记忆系统在各种对话式 AI 场景下的性能。以下是截至 2026 年 1 月 Hindsight 及其他 agent 记忆方案所报告的性能:
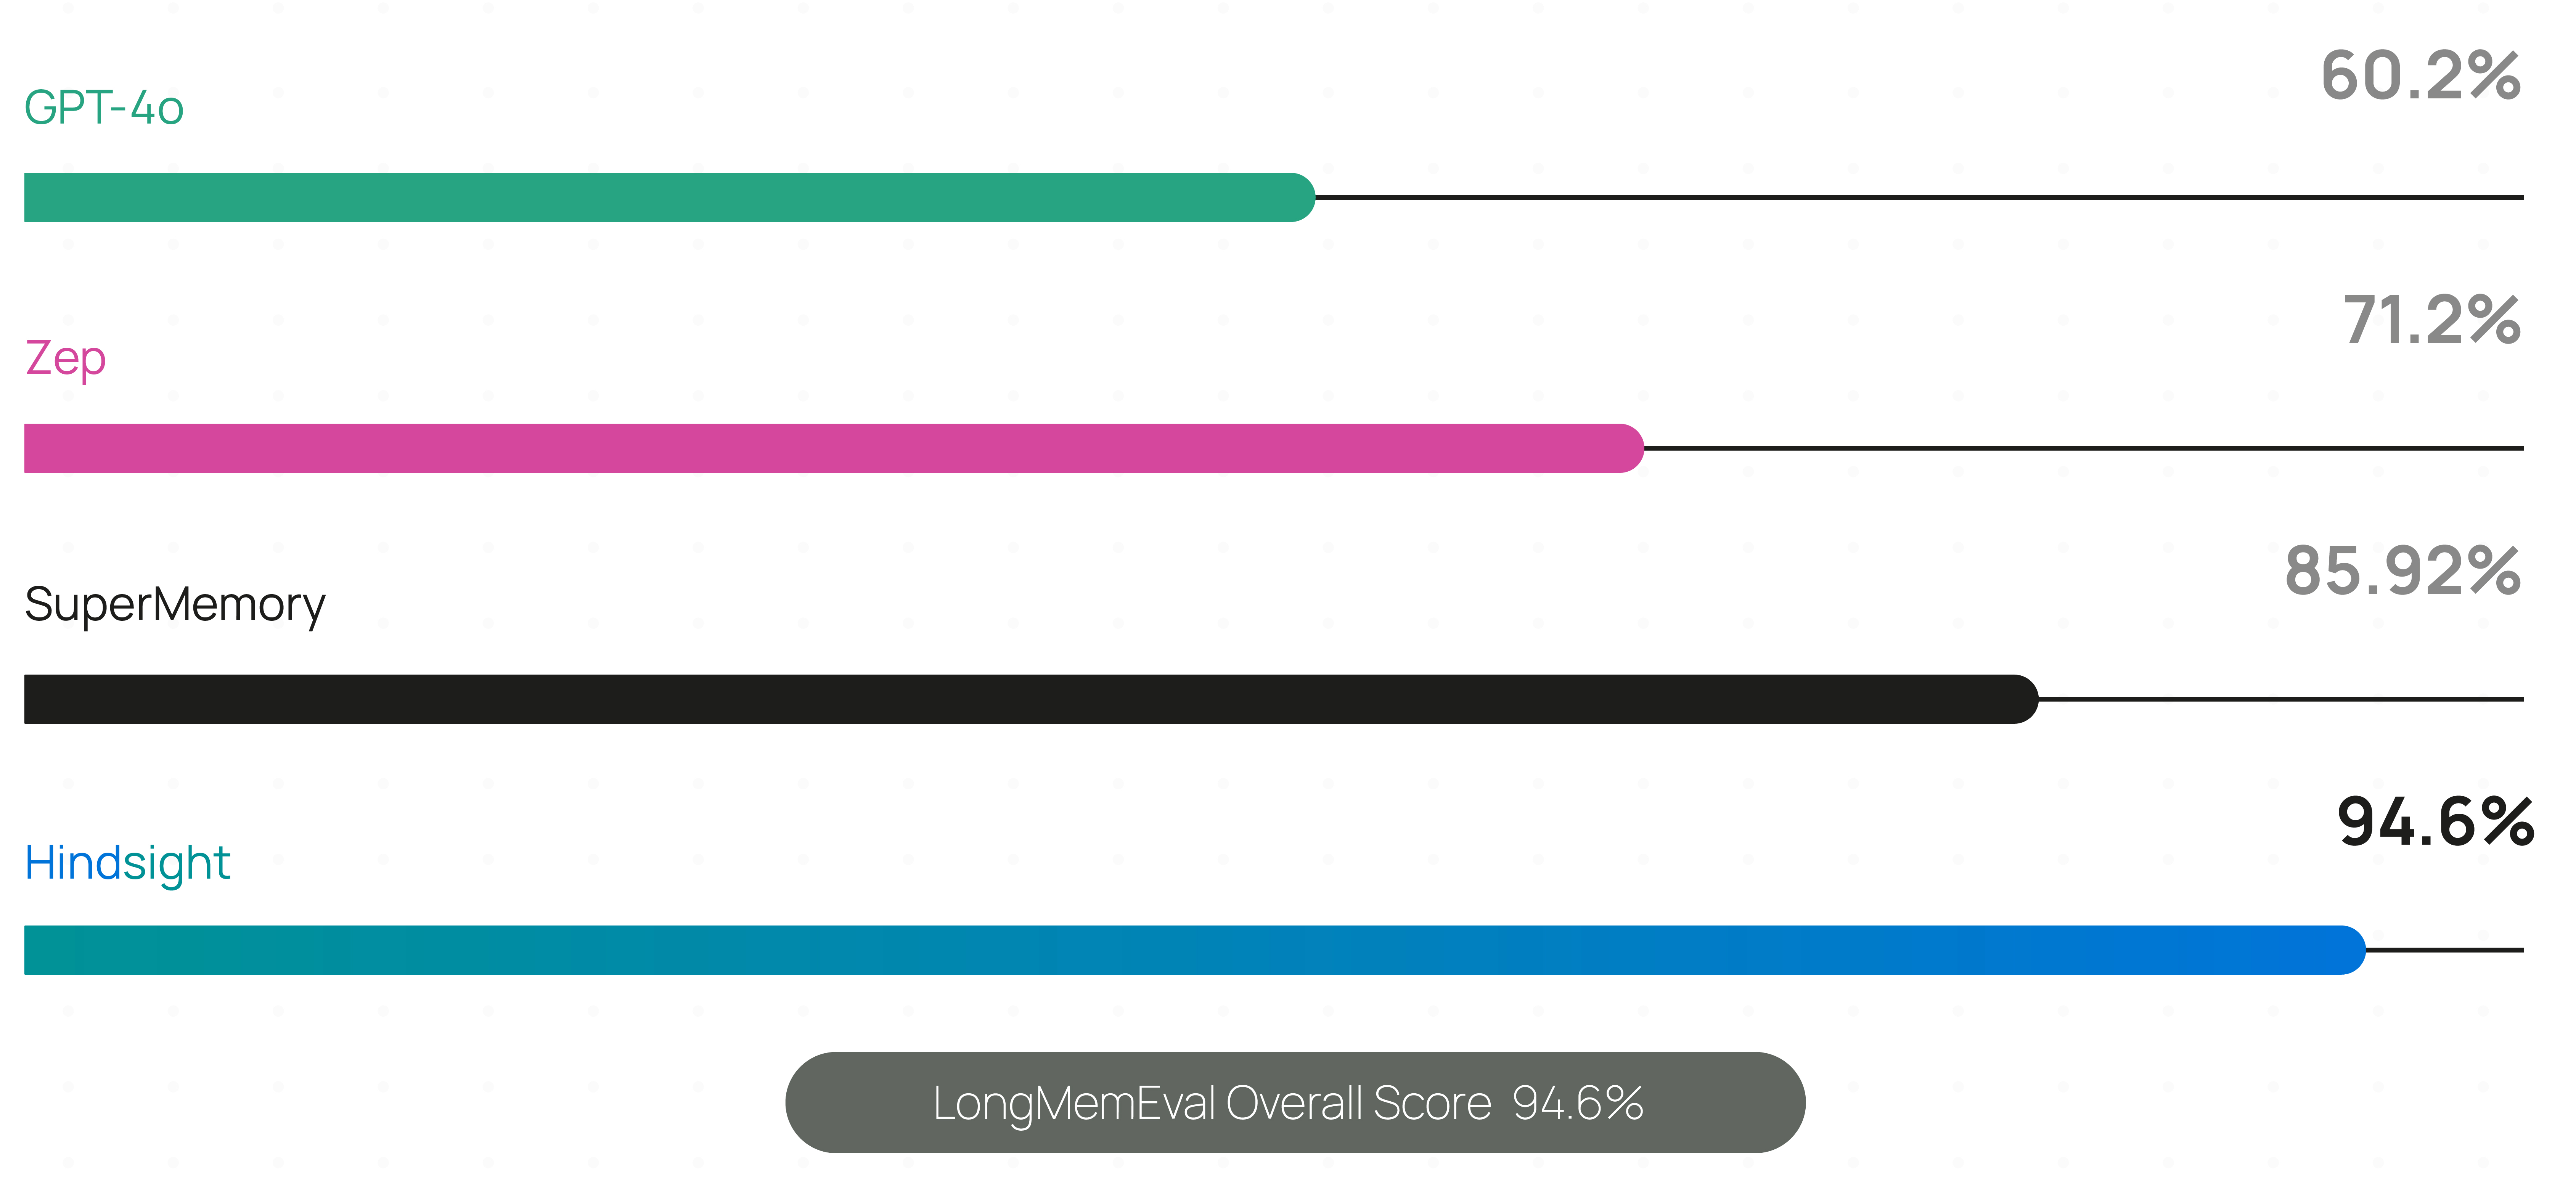
实时、持续更新的结果——包括各模型的准确率、延迟和成本——发布在 benchmarks.hindsight.vectorize.io。
Hindsight 的基准性能数据已由 Virginia Tech Sanghani Center for Artificial Intelligence and Data Analytics 和 The Washington Post 的研究合作者独立复现。其他分数由软件厂商自行报告。
Hindsight 已在财富 500 强企业以及越来越多的 AI 初创公司的生产环境中使用。
🤖 正在使用编码 agent? 安装 Hindsight 文档技能,在编码时即时访问文档:
npx skills add https://github.com/vectorize-io/hindsight --skill hindsight-docs支持 Claude Code、Cursor 及其他 AI 编码助手。
快速开始
1. 启动服务端
Docker(推荐)
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
Hindsight 通过 HINDSIGHT_API_LLM_PROVIDER 支持 25+ 个 LLM 供应商 —— 托管型(openai、anthropic、gemini、groq、bedrock、vertexai、minimax、deepseek、atlas、meta……)、完全本地型(ollama、lmstudio、llamacpp)、任意 OpenAI 兼容的 endpoint,以及可接入其余供应商的网关(litellm、litellmrouter)。现有订阅也能使用:openai-codex(ChatGPT Plus/Pro)、claude-code(Claude Pro/Max)、cursor(Cursor)和 github-copilot(GitHub Copilot)无需 API key。参见支持的模型。
Docker(外部 PostgreSQL)
export OPENAI_API_KEY=sk-xxx
export HINDSIGHT_DB_PASSWORD=choose-a-password
cd docker/docker-compose
docker compose up
企业级部署也支持 Oracle AI Database,功能完全对等。详见存储文档。
裸机(pip)
pip install hindsight-api
export HINDSIGHT_API_LLM_API_KEY=sk-xxx

hindsight-api
Kubernetes (Helm)
helm install hindsight oci://ghcr.io/vectorize-io/charts/hindsight \
  --set api.llm.provider=openai \
  --set api.llm.apiKey=sk-xxx \
  --set postgresql.enabled=true
托管版(无需服务端)
Hindsight Cloud 是托管选项:自动扩缩的托管基础设施,外加仪表盘、备份、团队协作和 99.9% 正常运行时间的 SLA。计费按用量计算,并提供入门免费额度——无固定月费或按席位收费。将任意客户端指向 https://api.hindsight.vectorize.io 并提供 API key,即可完全跳过部署。
比较自托管、Cloud 与 Enterprise → · 注册 →
包括 Windows 和隔离(air-gapped)环境在内的所有方案,均在安装指南中说明。
2. 连接客户端
pip install hindsight-client -U                                  # Python
npm install @vectorize-io/hindsight-client                        # Node.js / TypeScript
go get github.com/vectorize-io/hindsight/hindsight-clients/go     # Go
curl -fsSL https://hindsight.vectorize.io/get-cli | bash          # CLI
Python
from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")

# Retain: Store information
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")

# Recall: Search memories
client.recall(bank_id="my-bank", query="What does Alice do?")

# Reflect: Generate disposition-aware response
client.reflect(bank_id="my-bank", query="Tell me about Alice")
Node.js / TypeScript
const { HindsightClient } = require('@vectorize-io/hindsight-client');

const main = async () => {
  const client = new HindsightClient({ baseUrl: 'http://localhost:8888' });

  await client.retain('my-bank', 'Alice loves hiking in Yosemite');

  const results = await client.recall('my-bank', 'What does Alice like?');
  console.log(results);
}

main();
完整参考:Python · Node.js · Go · CLI · REST API
支持的平台
| 平台 | Docker | 裸机(pip) | 嵌入式数据库(pg0) |
|---|---|---|---|
| Linux (x86_64, ARM64) | ✅ | ✅ | ✅ |
| macOS (Apple Silicon / arm64) | ✅ | ✅ | ✅ |
| macOS (Intel / x86_64) | ✅ | ⚠️ | ✅ |
| Windows (x86_64) | ✅ | ✅ | ✅ |
⚠️ Intel Mac:请使用 hindsight-all-slim —— 详见安装指南。
Python 嵌入式(无需服务端)
pip install hindsight-all -U
在 Intel (x86_64) Mac 上,请改为安装 hindsight-all-slim —— 参见支持的平台。
import os
from hindsight import HindsightServer, HindsightClient

with HindsightServer(
    llm_provider="openai",
    llm_model="gpt-5-mini",
    llm_api_key=os.environ["OPENAI_API_KEY"]
) as server:
    client = HindsightClient(base_url=server.url)
    client.retain(bank_id="my-bank", content="Alice works at Google")
    results = client.recall(bank_id="my-bank", query="Where does Alice work?")
也提供 Node.js 等价实现和守护进程 CLI。
将 Hindsight 接入你的 Agent
LLM Wrapper(2 行代码)
为现有 agent 添加记忆最简单的方式是 LLM Wrapper。将你的 LLM 客户端替换为包装后的客户端——此后每次调用都会自动存储和检索记忆,代码无需其他改动。
pip install hindsight-litellm
from openai import OpenAI
from hindsight_litellm import wrap_openai

# Wrap your existing LLM client and you're done.
# Defaults to Hindsight Cloud; pass hindsight_api_url for a self-hosted server.
client = wrap_openai(
    OpenAI(),
    bank_id="user-123",
    hindsight_api_url="http://localhost:8888",
)

# Hindsight recalls relevant memories before the call
# and retains the conversation after it.
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "What do you know about me?"}],
)
wrap_anthropic() 对 Anthropic SDK 提供同样的能力,并且每一项设置——bank、recall 预算、fact 类型、用 reflect 替代 recall——都可以通过 hindsight_* kwargs 在每次调用时覆盖。由于底层是 LiteLLM,同一集成即可覆盖 100+ 模型。参见 LiteLLM 集成。
如果你需要显式控制记忆何时被存储和召回,请直接使用 SDK 或 REST API。
集成
60+ 集成 —— 大多数无需修改代码。
| 编码 agent | Claude Code · Codex · Cursor · GitHub Copilot · opencode · Cline · Aider · Zed · Continue · Roo Code · OpenHands |
| Agent 框架 | LangGraph / LangChain · LlamaIndex · CrewAI · Pydantic AI · OpenAI Agents SDK · Google ADK · Agno · Strands · AutoGen · Microsoft Agent Framework · Vercel AI SDK · Haystack |
| 无代码 / 低代码 | n8n · Zapier · Dify · Flowise |
| 应用与工具 | ChatGPT · Perplexity · Obsidian · Pipecat · Vapi |
👉 浏览全部集成
编码 Agent
一个 package 即可为 CLI 编码 agent 提供长期项目记忆:一个按仓库自动构建的 bank,源自 git 历史和过往会话,在 agent 开始工作时注入,外加经过整理、涵盖架构、约定与进行中工作的 knowledge pages。
npx @vectorize-io/hindsight-coding-agents install all          # every detected agent, wired natively
npx @vectorize-io/hindsight-coding-agents install claude-code  # or just one
支持 Claude Code、Codex CLI、Cursor CLI、GitHub Copilot CLI、opencode、Kilo CLI、Cline CLI、Antigravity CLI、Devin CLI、pi、Prime Agent、Grok Build 和 DeepSeek Harness。摄入是自动的——无需设置命令。参见编码 agent 集成。
MCP Server
每个服务端都内置 Model Context Protocol endpoint,每个 bank 一个,默认启用:
http://localhost:8888/mcp/{bank_id}/
将任意 MCP 客户端指向它,即可将 retain、recall 和 reflect 暴露为工具。参见 MCP server 文档。
核心概念
记忆类型
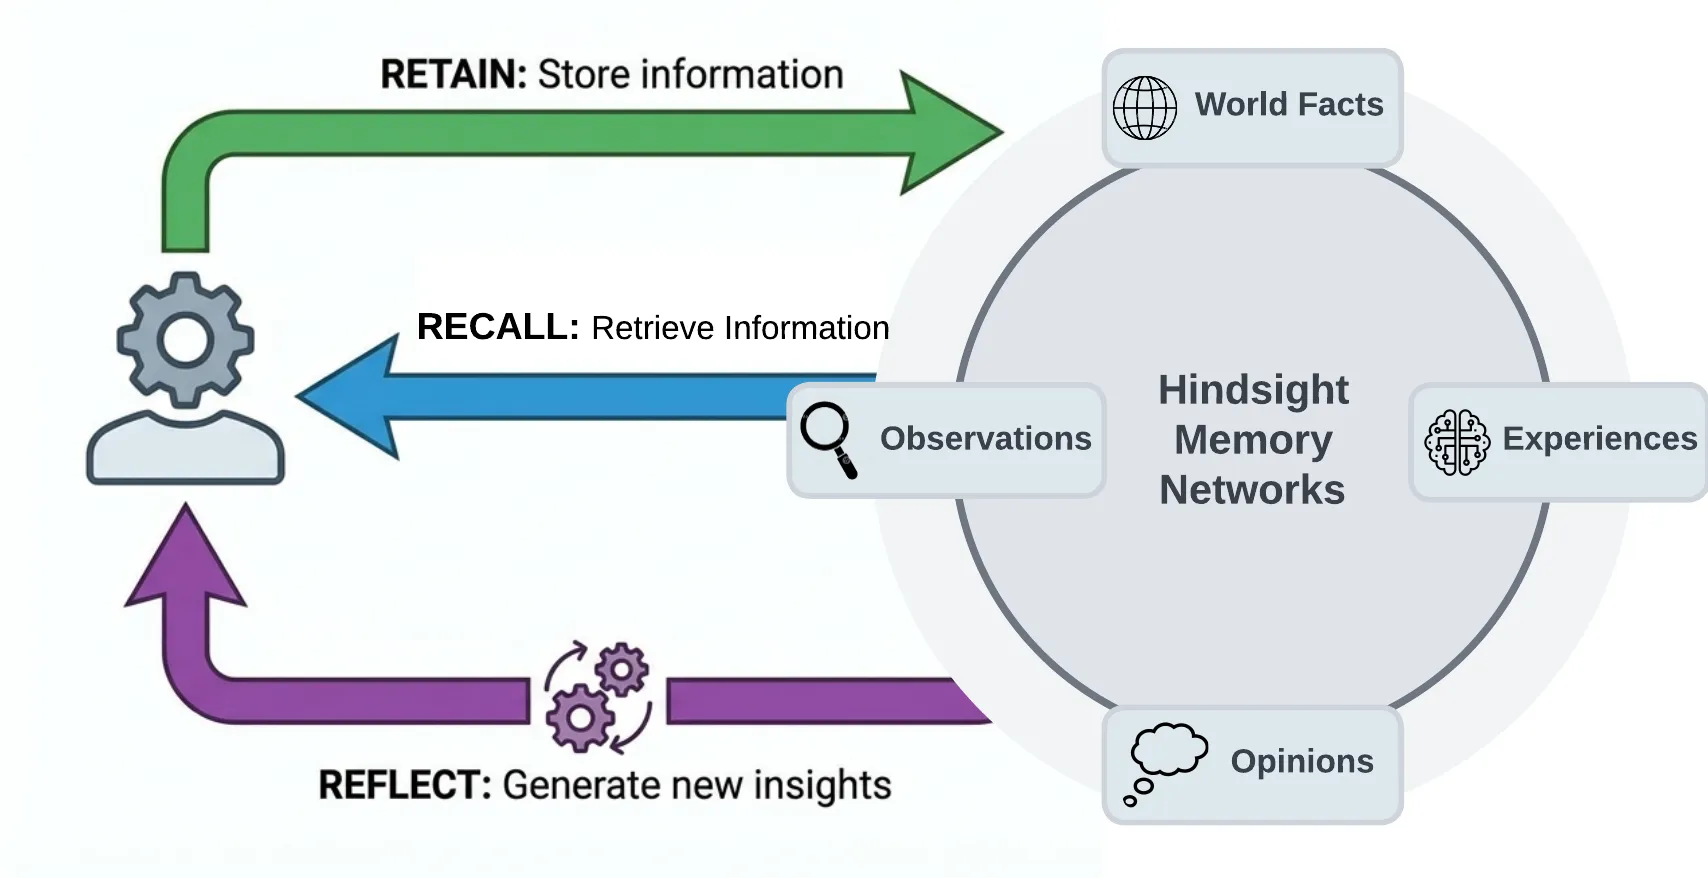
大多数 agent 记忆实现依赖基础向量搜索,或偶尔使用知识图谱。Hindsight 使用仿生数据结构来组织 agent 记忆,使其更接近人类记忆的工作方式:
- World facts(世界事实): 关于世界的事实("炉子会变烫")
- Experiences(经历): agent 自身的经历("我碰了炉子,真的很疼")
- Observations(观察): 由众多记忆整合而成、有证据支撑的信念
- Mental models(心智模型): 由 observations 和 facts 综合而成的、对 agent 所处世界的习得性理解
记忆存放在 banks 中。添加记忆时,它们会被推入 world facts 或 experiences 通路,随后表示为实体、关系和时间序列的组合,并配以稀疏/稠密向量表示,以助后续召回。
三大操作
Retain
retain 操作用于将新记忆推入 Hindsight。它告诉 Hindsight 把你传入的信息作为输入 retain(保留) 下来。
client.retain(
    bank_id="my-bank",
    content="Alice got promoted to senior engineer",
    context="career update",
    timestamp="2025-06-15T10:00:00Z",
)
在底层,retain 使用 LLM 提取关键事实、时间数据、实体和关系。它将这些数据经过归一化流程,转换为规范实体、时间序列和搜索索引以及元数据。这些表示形式为 recall 和 reflect 操作中的准确记忆检索铺就了通路。
Recall
recall 操作用于检索记忆。这些记忆可以来自任意记忆类型(world、experiences 等)。
client.recall(bank_id="my-bank", query="What does Alice do?")
client.recall(bank_id="my-bank", query="What happened in June?")   # temporal
Recall 并行执行 4 种检索策略:
- Semantic(语义):向量相似度
- Keyword(关键词):BM25 精确匹配
- Graph(图):实体/时间/因果链接
- Temporal(时间):时间范围过滤
各结果会被合并,使用 reciprocal rank fusion(倒数排序融合)和 cross-encoder 重排序模型按相关性排序,然后按需裁剪以适应 token 上限。
Reflect
reflect 操作会对现有记忆进行更深入的分析。这使 agent 能在记忆之间建立新的联系,构建对其世界更全面的理解——或回答需要深度思考而非简单查找的问题。
client.reflect(bank_id="my-bank", query="What should I know about Alice?")
例如,reflect 支持如下场景:
- 一位 AI 项目经理 反思项目中需要缓解哪些风险。
- 一位 销售 agent 反思为什么某些触达消息收到了回复,而其他没有。
- 一位 客服 agent 反思客户提出的问题中,哪些是当前产品文档未能解答的机会点。
Observations
保留的事实不会只是一堆平铺的东西。在后台,Hindsight 会把相关事实整合为 observations —— bank 随时间积累起来的、去重后的信念。每条 observation 都保留其支撑证据,附带精确引用和证据计数,并在新证据到来时被精炼而非覆盖,因此新信息会强化、削弱或扩展已有信念,而不是悄悄替换它。
Mental Models 与 Knowledge Pages
mental model(心智模型) 是对某个 bank 的某个问题的常备答案("这个用户的偏好是什么?")。你只需定义一次问题;Hindsight 会撰写答案、存储答案,并在 bank 学到更多时在后台重写它。读取一个 mental model 只是一次数据库读取——无需检索,无需 LLM 调用——因此 agent 可以用一页既定的知识启动,而不必每个会话都重新发现它。
knowledge pages(知识页) 是隐藏了机制细节的 mental models:bank 关于自身的活文档,像 wiki 一样按文件夹组织,可搜索,并可作为普通 markdown 投射到磁盘上。提供名称和一个问题即可;其余所有决策都是可覆盖的默认值。
Mental models → · Knowledge pages →
Memory Banks
bank 是隔离的记忆存储——一个用户、agent 或项目对应一个"大脑"。隔离是严格的:不会跨 bank 泄漏。bank 携带背景上下文和 disposition traits(倾向特质)(怀疑、字面、同理心),它们塑造 reflect 对其记忆的推理方式,并且可以从声明式 bank templates 创建。
还有两点值得了解:
- 默认多语言。 输入语言会被端到端检测并保留——事实保持其原始语言,实体保留其原生文字(张伟保持为张伟,而不是"Zhang Wei")。文档 →
- Memory Defense(记忆防御)。 一种可选、按 bank 配置的策略,针对 45 种模式扫描每次 retain 中的密钥和 PII,并将匹配项涂改(
[REDACTED:github_token])或在进入存储前拦截该项。文档 →
使用场景
Hindsight 旨在支持对话式 AI agent,以及那些被设计为自主执行任务的 agent。Hindsight 的理想场景是需要混合上述能力的 agent,例如需要处理开放式任务、根据用户反馈改变行为,并学会执行复杂任务以接近人类工作水平的 AI 员工。Hindsight 也可以用于简单的 AI 工作流,例如用 n8n 及其他类似工具构建的那些,但对这类应用可能有些过度。
按用户记忆与聊天历史
你可以用 Hindsight 做的事情中较简单的一种,是通过存储和召回与各个用户关联的记忆,来个性化 AI 聊天机器人和其他对话式 agent。
这类场景的需求通常大体如下:
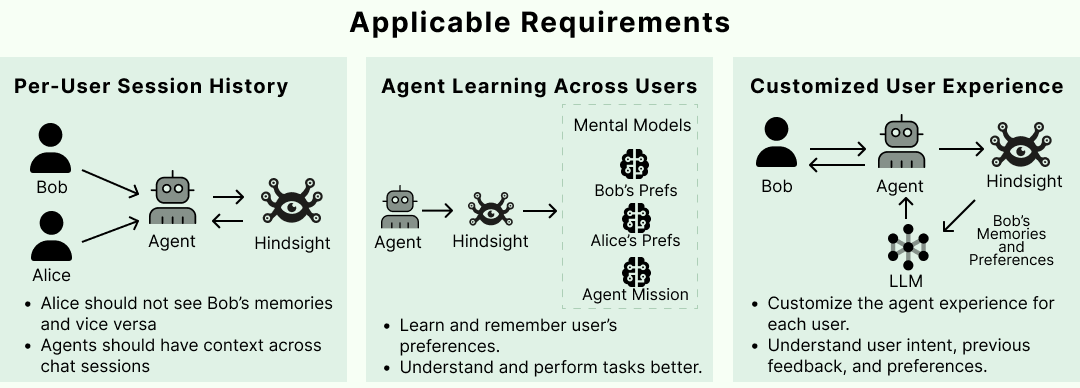
在 Hindsight 中满足这些需求很直接。当新的用户输入和工具调用通过 retain 操作摄入 Hindsight 时,可以用自定义元数据来丰富新记忆。元数据提供了一种便捷方式,将需要限定到特定用户的记忆隔离开来。一旦这些被送入 retain 操作,任何创建的原始记忆和 mental models 都可以在检索相关记忆时进行过滤。
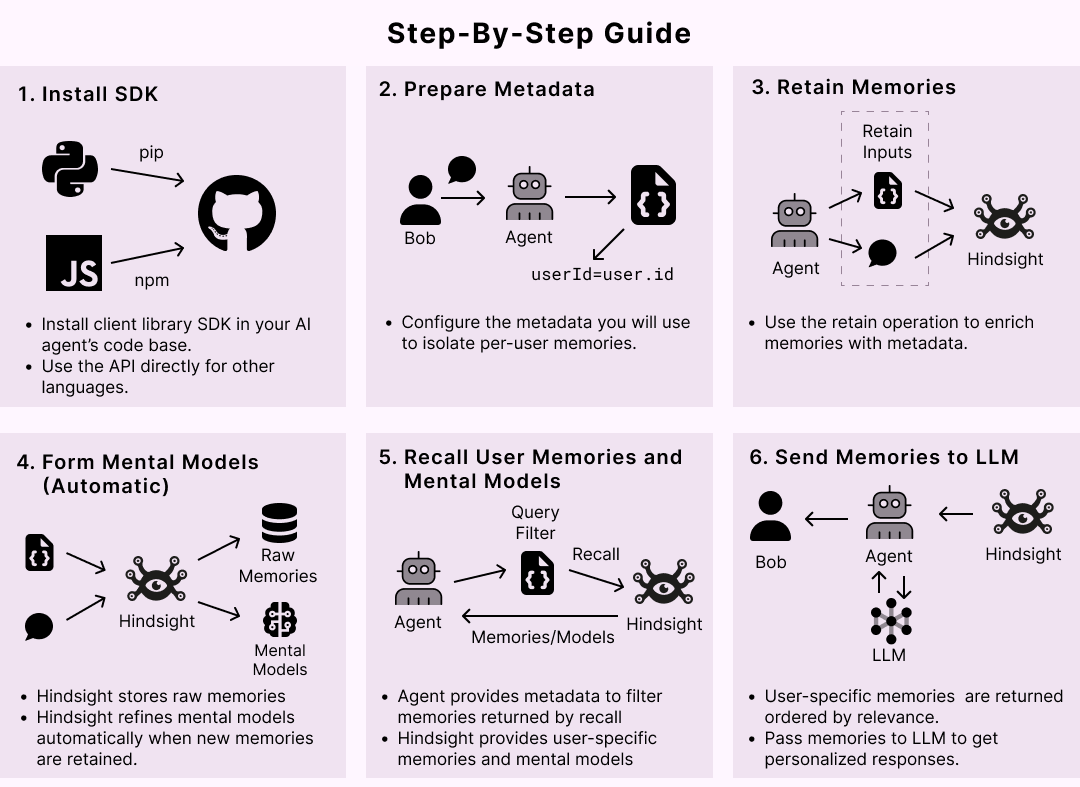
更多模式见 Cookbook 和 Best Practices。
生产环境部署
| 存储 | PostgreSQL + pgvector,或功能完全对等的 Oracle AI Database 23ai —— storage |
| 配置 | 分层:全局环境变量 → 按租户 → 按 bank —— configuration |
| 监控 | 针对 LLM 调用、token 和延迟的 Prometheus 指标与仪表盘 —— monitoring |
| 运维 | 用于迁移、bank 修复和卡住操作的管理 CLI —— admin CLI |
| 事件 | 针对 retain、整合和刷新生命周期事件的 Webhooks —— webhooks |
| 扩展性 | 租户、认证和存储扩展点 —— extensions |
| 托管 | 用 Hindsight Cloud 跳过这一切 —— 托管、按用量计费、99.9% 正常运行时间 SLA |
资源
文档:
- Docs · FAQ · Best Practices · Cookbook · Blog
- 论文 · 基准测试 · RAG vs Memory
客户端:
社区:
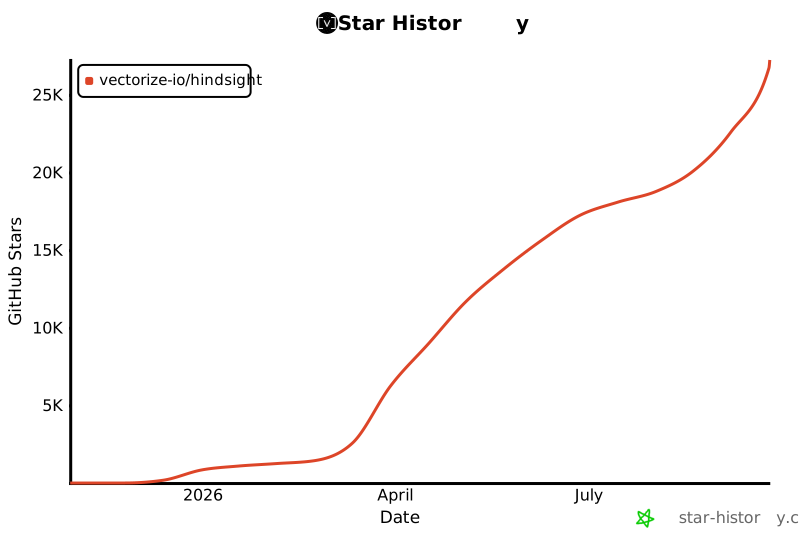
Star History
贡献
参见 CONTRIBUTING.md。
许可证
MIT —— 参见 LICENSE
由 Vectorize.io 构建
