Model-Optimizer
面向 LLM/VLM 的模型压缩与推理加速库,把量化(PTQ/QAT)、剪枝、蒸馏、NAS、投机解码、稀疏化等技术收敛到一套 Python API,导出可直接部署到 TensorRT-LLM、vLLM、SGLang 的量化 checkpoint。亮点是与 NVIDIA 自有训练栈(Megatron-Bridge、Megatron-LM、HF Accelerate)打通,NVFP4/FP8 方案能在保持精度的前提下换来约 1.3x 以上吞吐与数倍更小的权重,官方还放出大量预量化权重省去自己跑一遍流程。安装会拉取第三方开源依赖,使用前需先确认各自许可条款。
README
NVIDIA Model Optimizer
Documentation | Roadmap | Announcement Blogs
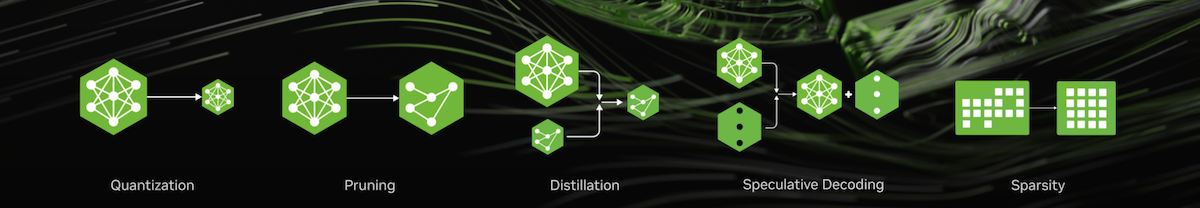
NVIDIA Model Optimizer(简称 Model Optimizer 或 ModelOpt)是一个模型优化库,涵盖当前最前沿的模型优化技术,包括量化(quantization)、剪枝(pruning)、神经架构搜索(Neural Architecture Search, NAS)、蒸馏(distillation)、投机解码(speculative decoding)和稀疏化(sparsity),用于加速模型。
[输入] Model Optimizer 目前支持输入 Hugging Face、PyTorch 或 ONNX 模型。
[优化] Model Optimizer 提供 Python API,用户可以轻松组合上述模型优化技术,并导出优化后的量化 checkpoint。 Model Optimizer 还与 NVIDIA Megatron-Bridge、Megatron-LM 和 Hugging Face Accelerate 集成,以支持需要训练的推理优化技术。
[导出以部署] Model Optimizer 与 NVIDIA AI 软件生态无缝集成,其生成的量化 checkpoint 可直接在下游推理框架中部署,例如 SGLang、TensorRT-LLM、TensorRT 或 vLLM。统一的 Hugging Face 导出 API 现已同时支持 transformers 与 diffusers 模型。
最新动态
- [2026/09/16] Qwen3.6-35B-A3B 的端到端 W4A4 NVFP4 + QAD 教程:NVFP4 W4A4 PTQ 加量化感知蒸馏(quantization-aware distillation),相比 BF16 在 vLLM 上实现最高 1.30 倍吞吐量、checkpoint 体积缩小 3.1 倍,同时恢复了 W4A4 带来的精度损失。
- [2026/09/09] BLOG: Improving NVFP4 Accuracy with Local-Hessian Weight Scales
- [2026/08/24] BLOG: AutoQuantize: A Fast Automatic Mixed-Precision Assignment
- [2026/08/17] BLOG: Developing Nemotron 3.5 Lightning NVFP4 with QAD Using NVIDIA Model Optimizer:了解量化感知蒸馏如何从激进的 NVFP4 量化中恢复精度,同时减小模型体积并提升吞吐量。
- [2026/06/26] BLOG: Creating the NVIDIA Nemotron 3 Ultra NVFP4 Checkpoint with NVIDIA Model Optimizer:我们如何使用 Model Optimizer 将 Nemotron 3 Ultra(550B)量化为 NVFP4 —— 在解码密集型推理上吞吐量最高达到 GLM-5.1 754B FP4 的 5.9 倍,同时保持与 BF16 相当的精度。checkpoint 已发布在 Hugging Face 上:NVFP4 Checkpoint。
- [2026/05/27] Nemotron-3-Nano-30B-A3B 端到端优化教程:剪枝 + 两阶段蒸馏 + FP8 量化,实现 2.6 倍 vLLM 吞吐量和 2.6 倍内存占用降低。
- [2026/05/13] Puzzletron:一种用于 LLM 和 VLM 模型异构剪枝与 NAS 的新算法。
- [2026/04/15] 客户案例:Domyn 使用 ModelOpt 的 Minitron 剪枝 + 蒸馏将 Colosseum-355B 压缩至 260B
- [2026/03/17] 客户案例:Bielik.AI 使用 ModelOpt 的 Minitron 剪枝 + 蒸馏构建 Bielik Minitron 7B(体积缩小 33%、速度提升 50%、保留 90% 质量)
- [2026/03/11] Model Optimizer 量化的 Nemotron-3-Super checkpoint 已在 Hugging Face 上开放下载:FP8、NVFP4。更多信息见 Nemotron 3 Super 发布博客。了解如何量化 Nemotron 3 系列模型以加速部署,请参见此处
- [2026/03/11] NeMo Megatron Bridge 现已支持使用 Model Optimizer 库对 Nemotron-3-Super 进行量化(PTQ 与 QAT)以及导出工作流。FP8/NVFP4 量化与 HF 导出说明见量化(PTQ 与 QAT)指南。
- [2025/12/11] BLOG: Top 5 AI Model Optimization Techniques for Faster, Smarter Inference
- [2025/12/08] NVIDIA TensorRT Model Optimizer 现已正式更名为 NVIDIA Model Optimizer。
- [2025/10/07] BLOG: Pruning and Distilling LLMs Using NVIDIA Model Optimizer
- [2025/09/17] BLOG: An Introduction to Speculative Decoding for Reducing Latency in AI Inference
- [2025/09/11] BLOG: How Quantization Aware Training Enables Low-Precision Accuracy Recovery
- [2025/08/29] BLOG: Fine-Tuning gpt-oss for Accuracy and Performance with Quantization Aware Training
- [2025/08/01] BLOG: Optimizing LLMs for Performance and Accuracy with Post-Training Quantization
- [2025/06/24] BLOG: Introducing NVFP4 for Efficient and Accurate Low-Precision Inference
- [2025/05/14] NVIDIA TensorRT Unlocks FP4 Image Generation for NVIDIA Blackwell GeForce RTX 50 Series GPUs
- [2025/04/21] Adobe 使用 Model-Optimizer + TensorRT 优化部署,使 diffusion 延迟降低 60%、总体拥有成本降低 40%
- [2025/04/05] NVIDIA Accelerates Inference on Meta Llama 4 Scout and Maverick。了解如何量化 Llama4 以加速部署,请参见此处
- [2025/03/18] World's Fastest DeepSeek-R1 Inference with Blackwell FP4 & Increasing Image Generation Efficiency on Blackwell
- [2025/02/25] Model Optimizer 量化的 NVFP4 模型已在 Hugging Face 上开放下载:DeepSeek-R1-FP4、Llama-3.3-70B-Instruct-FP4、Llama-3.1-405B-Instruct-FP4
- [2025/01/28] Model Optimizer 新增对 NVFP4 的支持。NVFP4 PTQ 示例见此处。
- [2025/01/28] Model Optimizer 现已开源!
- [2024/10/23] Model Optimizer 量化的 FP8 Llama-3.1 Instruct 模型已在 Hugging Face 上开放下载:8B、70B、405B。
- [2024/09/10] Post-Training Quantization of LLMs with NVIDIA NeMo and Model Optimizer。
- [2024/08/28] Boosting Llama 3.1 405B Performance up to 44% with Model Optimizer on NVIDIA H200 GPUs
- [2024/08/28] Up to 1.9X Higher Llama 3.1 Performance with Medusa
- [2024/08/15] 近期版本的新特性:Cache Diffusion、与 NVIDIA NeMo 配合的 QLoRA 工作流等。详情见我们的博客。
- [2024/06/03] Model Optimizer 现已提供实验性功能,可部署到 vLLM,这是我们支持主流部署框架工作的一部分。工作流见此处
- [2024/05/08] Announcement: Model Optimizer Now Formally Available to Further Accelerate GenAI Inference Performance
- [2024/03/27] Model Optimizer supercharges TensorRT-LLM to set MLPerf LLM inference records
- [2024/03/18] GTC Session: Optimize Generative AI Inference with Quantization in TensorRT-LLM and TensorRT
- [2024/03/07] Model Optimizer's 8-bit Post-Training Quantization enables TensorRT to accelerate Stable Diffusion to nearly 2x faster
- [2024/02/01] Speed up inference with Model Optimizer quantization techniques in TRT-LLM
安装
如需通过 pip 从 PyPI 安装 Model Optimizer 的稳定发行版:
pip install -U nvidia-modelopt[all]
Model Optimizer 会下载并安装额外的第三方开源软件项目。使用前请审阅这些开源项目的许可条款。
如需以可编辑模式从源码安装(包含全部开发依赖),或使用最新功能,请运行:
# Clone the Model Optimizer repository
git clone git@github.com:NVIDIA/Model-Optimizer.git
cd Model-Optimizer

pip install -e .[dev]
你也可以直接使用已预装 Model Optimizer 的 NVIDIA 容器镜像:
nvcr.io/nvidia/pytorch:<version>-py3nvcr.io/nvidia/nemo:<version>nvcr.io/nvidia/tensorrt-llm/release:<version>
在拉取和使用这些容器镜像之前,请先审阅各自对应的许可条款。 请务必按上文所述将 Model Optimizer 升级到最新版本。 如需更精细地控制所安装的依赖,或想了解其他 docker 镜像与环境变量配置方式,请访问我们的安装指南。
技术
| 技术 | 说明 | 示例 | 文档 |
|---|---|---|---|
| Post Training Quantization | 将模型体积压缩 2 倍至 4 倍,在保持模型质量的同时加速推理! | [HF LLMs / VLMs] [Megatron-Bridge LLMs / VLMs] [Diffusers] [ONNX] [Windows] | [docs] |
| Quantization Aware Training / Distillation | 仅需少量训练步骤,即可进一步精修量化模型的精度! | [Hugging Face] [Megatron-Bridge] | [docs] |
| Pruning | 移除冗余权重,减少模型参数量或内存占用并加速推理! | [General] [Megatron-Bridge] | |
| Distillation | 让小模型学会像大模型一样工作,从而缩减部署模型体积! | [Hugging Face] [Megatron-Bridge] [Megatron-LM] | [docs] |
| Speculative Decoding | 训练 draft 模块,在推理过程中预测额外的 token! | [Hugging Face] [Megatron-LM] | [docs] |
| Sparsity | 仅存储非零参数值及其位置,高效压缩模型 | [Hugging Face] | [docs] |
预量化 Checkpoint
- 可直接部署的 checkpoint [🤗 Hugging Face - Nvidia Model Optimizer Collection]
- 可部署于 TensorRT-LLM、vLLM 和 SGLang
- 更多模型即将推出!
资源
- 📅 Roadmap
- 📖 Documentation
- 🎯 Benchmarks
- 💡 Release Notes
- 🐛 提交 bug
- ✨ 提交功能需求
模型支持矩阵
| 模型类型 | 支持矩阵 |
|---|---|
| LLM / VLM 量化 | 查看支持矩阵 |
| Diffusers 量化 | 查看支持矩阵 |
| ONNX 量化 | 查看支持矩阵 |
| Windows 量化 | 查看支持矩阵 |
| 量化感知训练 | 查看支持矩阵 |
| 剪枝 | 查看支持矩阵 |
| 蒸馏 | 查看支持矩阵 |
| 投机解码 | 查看支持矩阵 |
弃用政策
Model Optimizer 采用结构化的方式来管理已弃用的功能:
- 沟通告知: 弃用通知会记录在 Changelog 中。被弃用的条目会在源码中包含说明弃用时间的语句,并在使用时发出运行时警告。
- 迁移期: 由于 Model Optimizer 仍处于 1.0 之前,我们在弃用后提供 1 个版本(约 1 个月)的迁移期。在此期间,被弃用的功能仍可继续使用,但会发出警告。
- 范围: 该政策同时涵盖完全弃用(整个 API 被移除)和部分弃用(移除特定参数而方法保留)。
- 移除: 迁移期结束后,被弃用的元素将按照语义化版本规范移除;由于 Model Optimizer 仍处于 0.x 阶段,次要版本更新中可能包含破坏性变更。
引用
如果你在研究中使用了 NVIDIA Model Optimizer,请按如下方式引用:
@misc{nvidia-modelopt,
  author       = {{NVIDIA Corporation}},
  title        = {{NVIDIA Model Optimizer}},
  howpublished = {\url{https://github.com/NVIDIA/Model-Optimizer}},
  year         = {2024--2026},
  note         = {GitHub repository}
}
贡献
Model Optimizer 现已开源!我们欢迎任何反馈、功能需求与 PR。 关于如何为本项目做贡献的详细信息,请阅读我们的贡献指南。
AI Agents
ModelOpt 的 agent skills 可以直接从本仓库安装,并在任意工作区中使用。
Claude Code
claude plugin marketplace add https://github.com/NVIDIA/Model-Optimizer.git
claude plugin install modelopt@modelopt
Codex
codex plugin marketplace add https://github.com/NVIDIA/Model-Optimizer.git
然后打开 /plugins,选择 modelopt marketplace,并安装 modelopt。
贡献者也可以直接在本地代码检出中使用这些 skills。参见
agent 工具说明。
主要贡献者
祝优化愉快!