tilelang
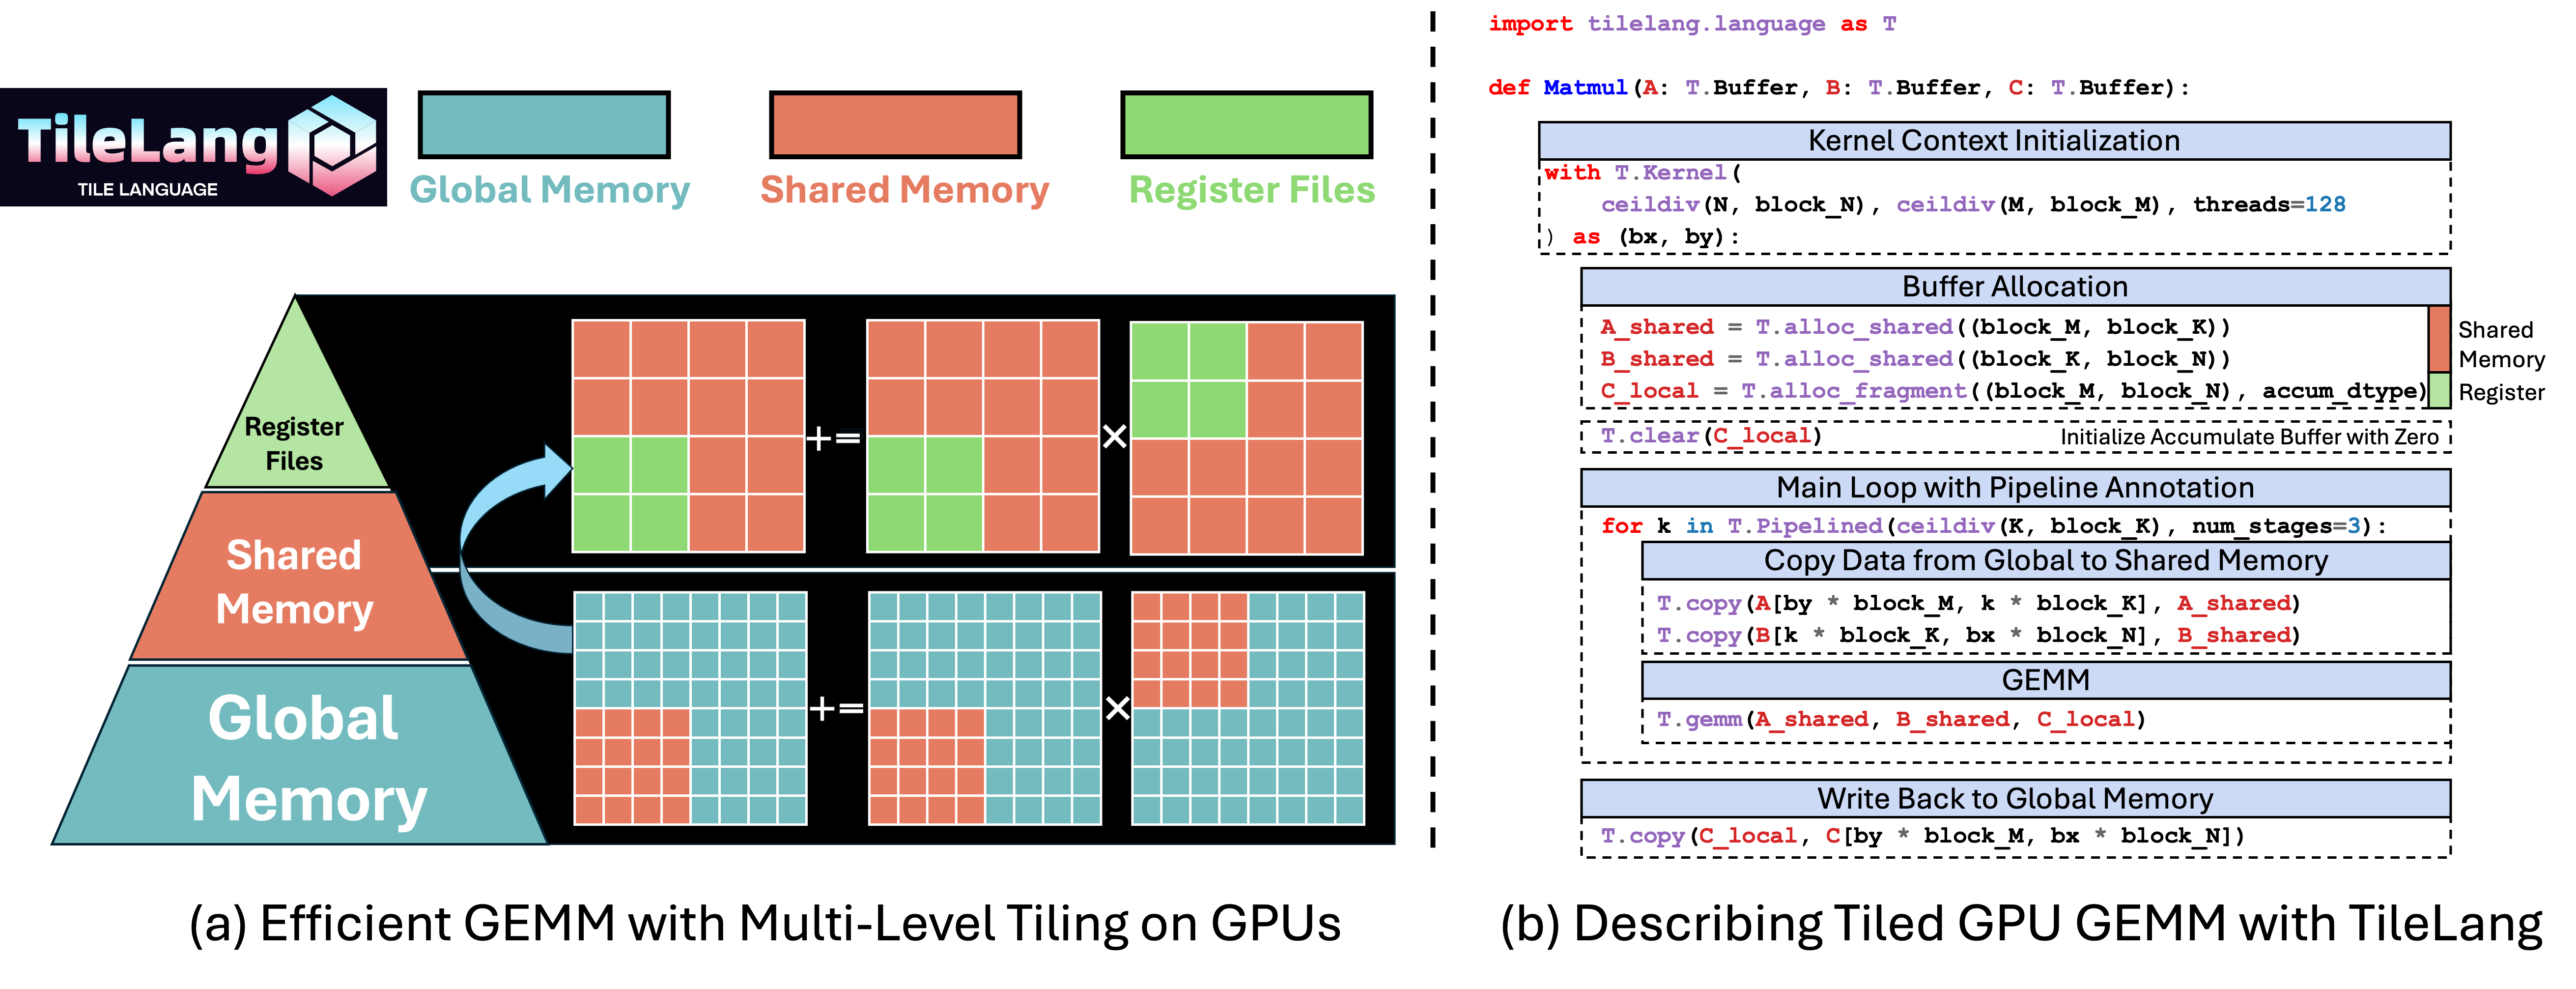
基于 TVM 的 tile 级 DSL,用 Python 语法编写 GEMM、FlashAttention、MLA 等高性能 kernel,编译器自动完成流水线调度、warp specialization 与多后端代码生成。覆盖 NVIDIA CUDA(SM70–SM120)、AMD ROCm、Apple Metal、昇腾 950 及 LLVM CPU 等后端,并附带 DeepSeek V3.2/V4 等热门算子示例与 IR 调试工具,适合做推理优化的团队替代手写 CUDA。
README
Tile Language


文档 · 安装 · 示例 · 发布版本 · 贡献指南 · TileLang (Ascend 950)
Tile Language(tile-lang)是一门简洁的领域特定语言(DSL),旨在简化高性能 GPU/CPU/NPU kernel(例如 GEMM、Dequant GEMM、FlashAttention、LinearAttention)的开发。它采用 Python 风格的语法,并以 TVM 之上的编译器基础设施为底层支撑,让开发者能够专注于开发效率,同时不必牺牲实现最优性能所需的底层优化。
最新动态
- 2026-09-30 — Ascend 950 后端: TileLang 现已正式支持华为 Ascend 950 NPU,具备原生代码生成、自动调度与同步、SIMD/SIMT 向量编程等能力。可查看 Ascend 上的 GEMM、FlashAttention 等示例。
- 2026-08-04 — TileLang LSP 开源: 发布了 TileLang 的 Language Server Protocol 实现,支持为 buffer 形状、dtype、scope 和推断出的 layout 提供 inlay hints,并提供 hover 详情与精确诊断。
- 2026-08-03 — TileLang v0.1.13: 带来了多后端语言 dialect、编译器诊断中的源码位置信息、新的 CUDA 与 Metal 硬件路径,以及大量正确性修复。该版本移除了若干历史 API;升级前请阅读兼容性说明。
- 2026-07-30 — SM120 NVF4 block-scaled MMA: 为
T.mma_gemm_blockscaled增加了面向 Blackwell 的优化路径,并附带对应的 SM120 示例。 - 2026-07-28 — Metal 4 cooperative-tensor GEMM: 为 Apple M5 增加了 cooperative-tensor
T.gemm支持,同时对不支持的 shape 和系统保留 simdgroup 回退路径。
2026
- 2026-07-28 — 感知源码的编译器诊断: 将 Python 源码位置信息传递到 TIRX,并在编译器报错中呈现。
- 2026-07-24 — 多后端语言 dialect: 围绕共享语义重组语言层,并提供静态的 CUDA、ROCm 和 Metal dialect。
- 2026-07-23 — 面向 dLLM 的 block-causal attention: 为 diffusion language model 增加了定长与变长的 block-causal attention 示例。
- 2026-07-22 — IR Lower Trace: 引入调试工具,用于查看每个编译器 pass 以及最终代码生成阶段的 IR 变化。
- 2026-07-22 — DeepSeek V3.2 sparse MLA 反向: 根据 head-block 大小自适应选择 launch 宽度。
- 2026-07-21 — DeepSeek V3.2 top-k 优化: 改进了 sparse-attention top-k 选择器的访存模式,在报告基准中带来约 1.9× 的性能提升。
- 2026-07-16 — 编译器 pass 耗时统计: 增加编译器 pass 的 profiling 能力,并可配置报告阈值。
- 2026-07-12 — IKET profiler 集成: 增加 CUDA timeline 插桩与 profiling 支持。
- 2026-07-08 — TileLang v0.1.12: 新增 LLVM 后端、tile scheduler、backend registry、pass visualizer,并扩展了 Blackwell 支持。
- 2026-07-06 — Pass Visualizer: 引入结构树浏览器,用于查看编译器变换。
- 2026-06-26 — 跨主机 CUDA 二进制缓存: 使编译出的 CUDA 二进制文件可在兼容的主机之间复用。
- 2026-06-24 — Tile scheduler: 为 kernel 开发者引入 persistent tile-scheduling 原语。
- 2026-06-24 — Backend CodeGen registry: 将 device 与 host CodeGen 的派发迁移到 backend registry 之后。
- 2026-06-18 — LLVM 后端: 增加通过 LLVM 进行 CPU lowering 与执行的能力。
- 2026-06-18 — 任意 layout 的 TMA lowering: 支持对 swizzled 共享内存 layout 进行 TMA 传输。
- 2026-06-16 — Pass Diff: 增加编译器 pass 的 IR 对比,便于调试 lowering 变更。
- 2026-06-08 — TileLang v0.1.11: 扩展了 scan、pipeline、backend、CUDA、ROCm 和 Metal 相关功能。
- 2026-05-25 — Scan 算子: 引入 tile 级 scan 原语。
- 2026-05-25 — TileLang v0.1.10: 扩展 AMD 与 Blackwell 支持,新增初步的 Metal GEMM,改进 Windows 打包,并扩展 autotuning。
- 2026-05-24 — CDNA4 MXFP4: 为 AMD gfx950 增加 FP4 E2M1 matrix-core 支持。
- 2026-05-22 — Metal simdgroup GEMM: 使用
simdgroup_matrixMMA 增加首个 MetalT.gemm路径。 - 2026-05-20 — Cluster copies: 引入
T.copy_cluster,支持 TMA multicast 与 SM-to-SM cluster 传输。 - 2026-05-20 — TMA gather/scatter: 增加
tile::gather4和tile::scatter4支持。 - 2026-05-20 — 原生 SM75 MMA GEMM: 为 Turing GPU 增加 FP16、INT8 和 INT4 tensor-core 路径。
- 2026-05-20 — TIRX 迁移: 将 TileLang IR 的使用迁移到 TVM 的 TIRX 表示。
- 2026-05-11 — 并行 autotuning: 增加流水化编译、分组编译与多 GPU 基准测试。
- 2026-05-07 — DeepSeek V4 算子: 为 DeepSeek V4 工作负载增加 TileLang 示例。
- 2026-05-06 — Windows 支持: 增加完整的 Windows 构建与运行时支持,并包含跨平台修复。
- 2026-04-28 — MXFP8 grouped GEMM: 在 Blackwell 上增加支持转置 B 的 block-scaled grouped GEMM 示例。
- 2026-04-25 — HISA sparse-attention 索引器: 增加分层 sparse-attention 索引示例。
- 2026-04-24 — Blackwell MXFP8 block-scaled GEMM: 在 SM100 上增加 MXFP8 block-scaled 矩阵乘法。
- 2026-04-22 — TileLang v0.1.9: 交付 CuTe DSL GEMM V2、Metal 代码生成改进,以及无需 host 工具链的构建支持。
- 2026-04-22 — RDNA3/RDNA3.5 WMMA: 为 AMD gfx11 GPU 增加 WMMA lowering。
- 2026-04-20 — INT4
T.gemm: 在 CUDA GEMM 路径中增加 INT4 矩阵乘法。 - 2026-04-17 — CUDA 源码 kernel: 引入
T.CUDASourceCodeKernel,用于嵌入自定义 CUDA 源码。 - 2026-04-15 — AutoDD 冻结区域: 增加
__freeze__标注,在自动 delta debugging 过程中保留指定代码。 - 2026-03-27 — TMA stores: 为
T.tma_copy增加 store 支持。 - 2026-03-24 — 双 SM Blackwell kernel: 增加 two-SM TMA、TMEM 与 TCGEN5 MMA 支持。
- 2026-03-23 — AMD RDNA4: 升级 ROCm 路径并增加 RDNA4 GPU 支持。
- 2026-03-22 — SM100 上的 FlashAttention: 增加 Blackwell FlashAttention 示例。
- 2026-03-18 — 生产者-消费者 warp 特化: 增加自动 warp-specialized pipeline 与
T.tma_copyAPI。 - 2026-03-12 — Eager 模式 autotuning: 使 autotuner 支持 eager JIT kernel。
- 2026-03-10 — CPU
T.gemm: 为 CPU 目标增加矩阵乘法支持。 - 2026-03-05 — IR dump 配置: 增加用于 dump 中间 IR 的 TileLang pass 配置。
- 2026-02-28 — CUDA cluster 原语: 增加 cluster 启动、查询、同步与 barrier 操作。
- 2026-02-28 — TCGEN5 MMA tensor-shared 路径: 增加 tensor-memory/shared-memory 的 Blackwell GEMM 路径。
- 2026-02-24 — 无需 host 工具链的构建: 在具备受支持产物的情况下,可无需 host C/C++ 工具链进行安装。
- 2026-02-23 — CuTe DSL GEMM V2: 为 CuTe DSL 后端增加 SM90 和 SM100 GEMM V2 支持。
- 2026-02-16 — TileLang v0.1.8: 发布动态 pipeline 改进、日志文档、更丰富的 layout 表示,以及 AMD 修复。
- 2026-02-14 — 跨 CUDA 版本的 release wheel: 将多个 CUDA 版本统一到单个 wheel 中。
- 2026-02-14 — 分层归约: 增加分层与 warp 级归约 intrinsic。
- 2026-02-09 — CUDA 运行时 stub: 增加惰性加载的 CUDART 与 NVRTC stub,以支持 CUDA 11、12、13 兼容的 wheel。
- 2026-02-08 — layout 可视化改进: 改进 TileLang layout 的渲染与查看。
- 2026-02-02 — TileLang Puzzles: 发布十道难度递进的练习,用于交互式学习 TileLang。
2025
- 2025-12-18 — CuTe DSL 后端: 增加通过 NVIDIA CUTLASS CuTe DSL 进行编译的能力;后续工作见 issue #1454。
- 2025-12-17 — Z3 集成: 将基于 SMT 的符号推理集成进 TVM 算术分析器。
- 2025-10-31 — Apache TVM FFI 迁移: 将运行时接口迁移到
apache-tvm-ffi,以降低 host 侧开销。 - 2025-10-30 — TileLang v0.1.6.post2: 发布最后一个兼容 Python 3.8 的 TileLang 版本。
- 2025-10-07 — Apple Metal 后端: 为 Apple 芯片引入 Metal device 支持。
- 2025-09-29 — 华为 Ascend 适配器: 在外部 TileLang Ascend 项目中发布了 AscendC 与 Ascend NPU IR 后端工作。
- 2025-07-04 — 2:4 稀疏 tensor core: 引入
T.gemm_sp,用于结构化稀疏矩阵乘法。 - 2025-06-05 — NVRTC 执行后端: 增加 NVRTC 路径,以缩短生成 CUDA 模板的编译时间。
- 2025-04-14 — AMD MI300X 上的 FlashMLA: 发布优化后的 AMD 实现及配套文档。
- 2025-03-03 — H100 上的 MLA decoding: 发布简洁的 TileLang 实现、基准测试与优化讲解。
- 2025-02-15 — WebGPU 代码生成: 增加最初的 WebGPU 后端。
- 2025-02-12 — TileLang v0.1.0: 发布首个 v0.1 公开版本。
- 2025-02-10 — 调试与 layout 工具: 增加
T.print与 fragment-layout 可视化工作流。 - 2025-01-20 — TileLang 开源: 项目正式公开发布。
完整的变更日志与兼容性说明请参见 所有 release。
平台与后端支持
TileLang 正在演进为一个多后端编译器(TileLang-X),其核心是模块化的后端抽象。设计细节请参见后端架构;在将 TileLang 移植到新后端时,也可以让 coding agent 使用后端集成 skill。
当前支持的后端如下。Primary 指 TileLang 的核心后端,Supported 与 Experimental 后端在主仓库中实现。Ecosystem 适配器位于独立仓库中,不包含在 TileLang 的 release wheel 内,且可能遵循独立的兼容节奏。预编译 wheel 可用于 Linux x86-64/AArch64、Windows x86-64 和 macOS arm64。
TileLang 使用 Target 对象来表示编译目标。默认的 auto target 会检测 CUDA、HIP、Metal 和 Ascend 设备;在面向其他后端或架构编译时,请显式选择 target。target 语法、架构选项以及各后端的具体说明请参见 target 指南,安装方式与已验证设备的信息请参见对应的适配器仓库。
| 后端 | Target | 平台与硬件 | 支持级别 | 说明 |
|---|---|---|---|---|
| NVIDIA CUDA | cuda |
Linux x86-64/AArch64、Windows x86-64;覆盖 SM70 至 SM120 的代码路径 | Primary | 提供 release wheel 与 CI 覆盖;TMA、WGMMA 和 TMEM 特性需要对应的 GPU 架构。 |
| AMD ROCm/HIP | hip |
Linux;CDNA 与 RDNA GPU,包括 gfx942/gfx950 路径 | Supported | 已包含在 Linux wheel 中;需要 ROCm 运行时。CI 运行在自托管的 gfx942(MI300X)runner 上;尚未覆盖 gfx950。 |
| Huawei Ascend 950 | ascend |
Linux;Ascend 950 NPU | Supported | 使用 USE_ASCEND=ON 从源码构建;需要 CANN 与 torch_npu。参见 Ascend 指南。 |
| Apple Metal | metal |
Apple 芯片上的 macOS | Supported | 提供 release wheel 与 CI 覆盖;在受支持的 M5 系统上可使用 Metal 4 cooperative tensor。 |
| LLVM CPU | llvm |
主机 CPU | Experimental | 使用 USE_LLVM=ON 从源码构建;需要 LLVM 15 或更高版本。 |
| NVIDIA CuTe DSL | cutedsl |
NVIDIA GPU | Experimental | 需要 nvidia-cutlass-dsl。 |
| WebGPU | webgpu |
WebGPU 运行时 | Experimental | 代码生成与运行时集成仍在演进中。 |
| Huawei Ascend A2/A3 | ascendc / pto / npuir |
Ascend A2 与 A3 | Ecosystem | 在 tilelang-ascend 和基于 MLIR 的 tilelang-mlir-ascend 中开发。 |
| MetaX MACA | maca |
MetaX C500 与 C600 | Ecosystem | 在 tilelang-metax 中开发;需要 MACA 软件栈。 |
| Moore Threads MUSA | musa |
S5000、S4000 与 M1000 | Ecosystem | 在 tilelang-musa 中开发并独立发布。 |
| HYGON | hcu |
Linux;BW1000、BW1100、BW150 与 K100_AI | Ecosystem | 在 tilelang-hygon 中开发;需要 DTK 软件栈。 |
| Sunrise-AI TANG | tang |
Sunrise S2 与 S3 | Ecosystem | 在 tilelang-sunrise 中开发。需要 TANG 软件栈。 |
安装
从 PyPI 安装最新的稳定版本:
pip install tilelang
验证安装:
python -c "import tilelang; print(tilelang.__version__)"
Nightly wheel 可在下一个稳定版本发布前提供较新的特性和修复:
pip install tilelang --find-links https://tile-ai.github.io/whl/nightly
在 AMD GPU 上,同样的 Linux wheel 可直接使用:先安装 ROCm 版本的 PyTorch(例如 pip install torch --index-url https://download.pytorch.org/whl/rocm7.0),然后执行 pip install tilelang。运行时需要宿主机安装 ROCm;参见安装指南中的 ROCm 说明。
Nightly 构建的稳定性可能不如正式发布版本。如需源码构建、可编辑安装、Docker、ROCm 环境配置、pip 提供的 CUDA 工具链,或自定义的 TVM checkout,请遵循完整的安装指南。
快速开始
下面的示例定义、编译、运行并验证了一个 FP16 GEMM kernel,采用 FP32 累加并融合 ReLU epilogue。它使用 PyTorch CUDA tensor;在 ROCm 系统上 PyTorch 使用相同的 cuda device 名称。TileLang 会根据当前环境自动选择 target。
import torch
import tilelang
import tilelang.language as T


@tilelang.jit
def matmul_relu(A, B, block_M: int = 128, block_N: int = 128, block_K: int = 32):
    M, N, K = T.const("M, N, K")
    A: T.Tensor((M, K), T.float16)
    B: T.Tensor((K, N), T.float16)
    C = T.empty((M, N), T.float16)

    with T.Kernel(T.ceildiv(N, block_N), T.ceildiv(M, block_M), threads=128) as (bx, by):
        A_shared = T.alloc_shared((block_M, block_K), T.float16)
        B_shared = T.alloc_shared((block_K, block_N), T.float16)
        C_local = T.alloc_fragment((block_M, block_N), T.float32)

        T.clear(C_local)
        for k in T.Pipelined(T.ceildiv(K, block_K), num