UniMate
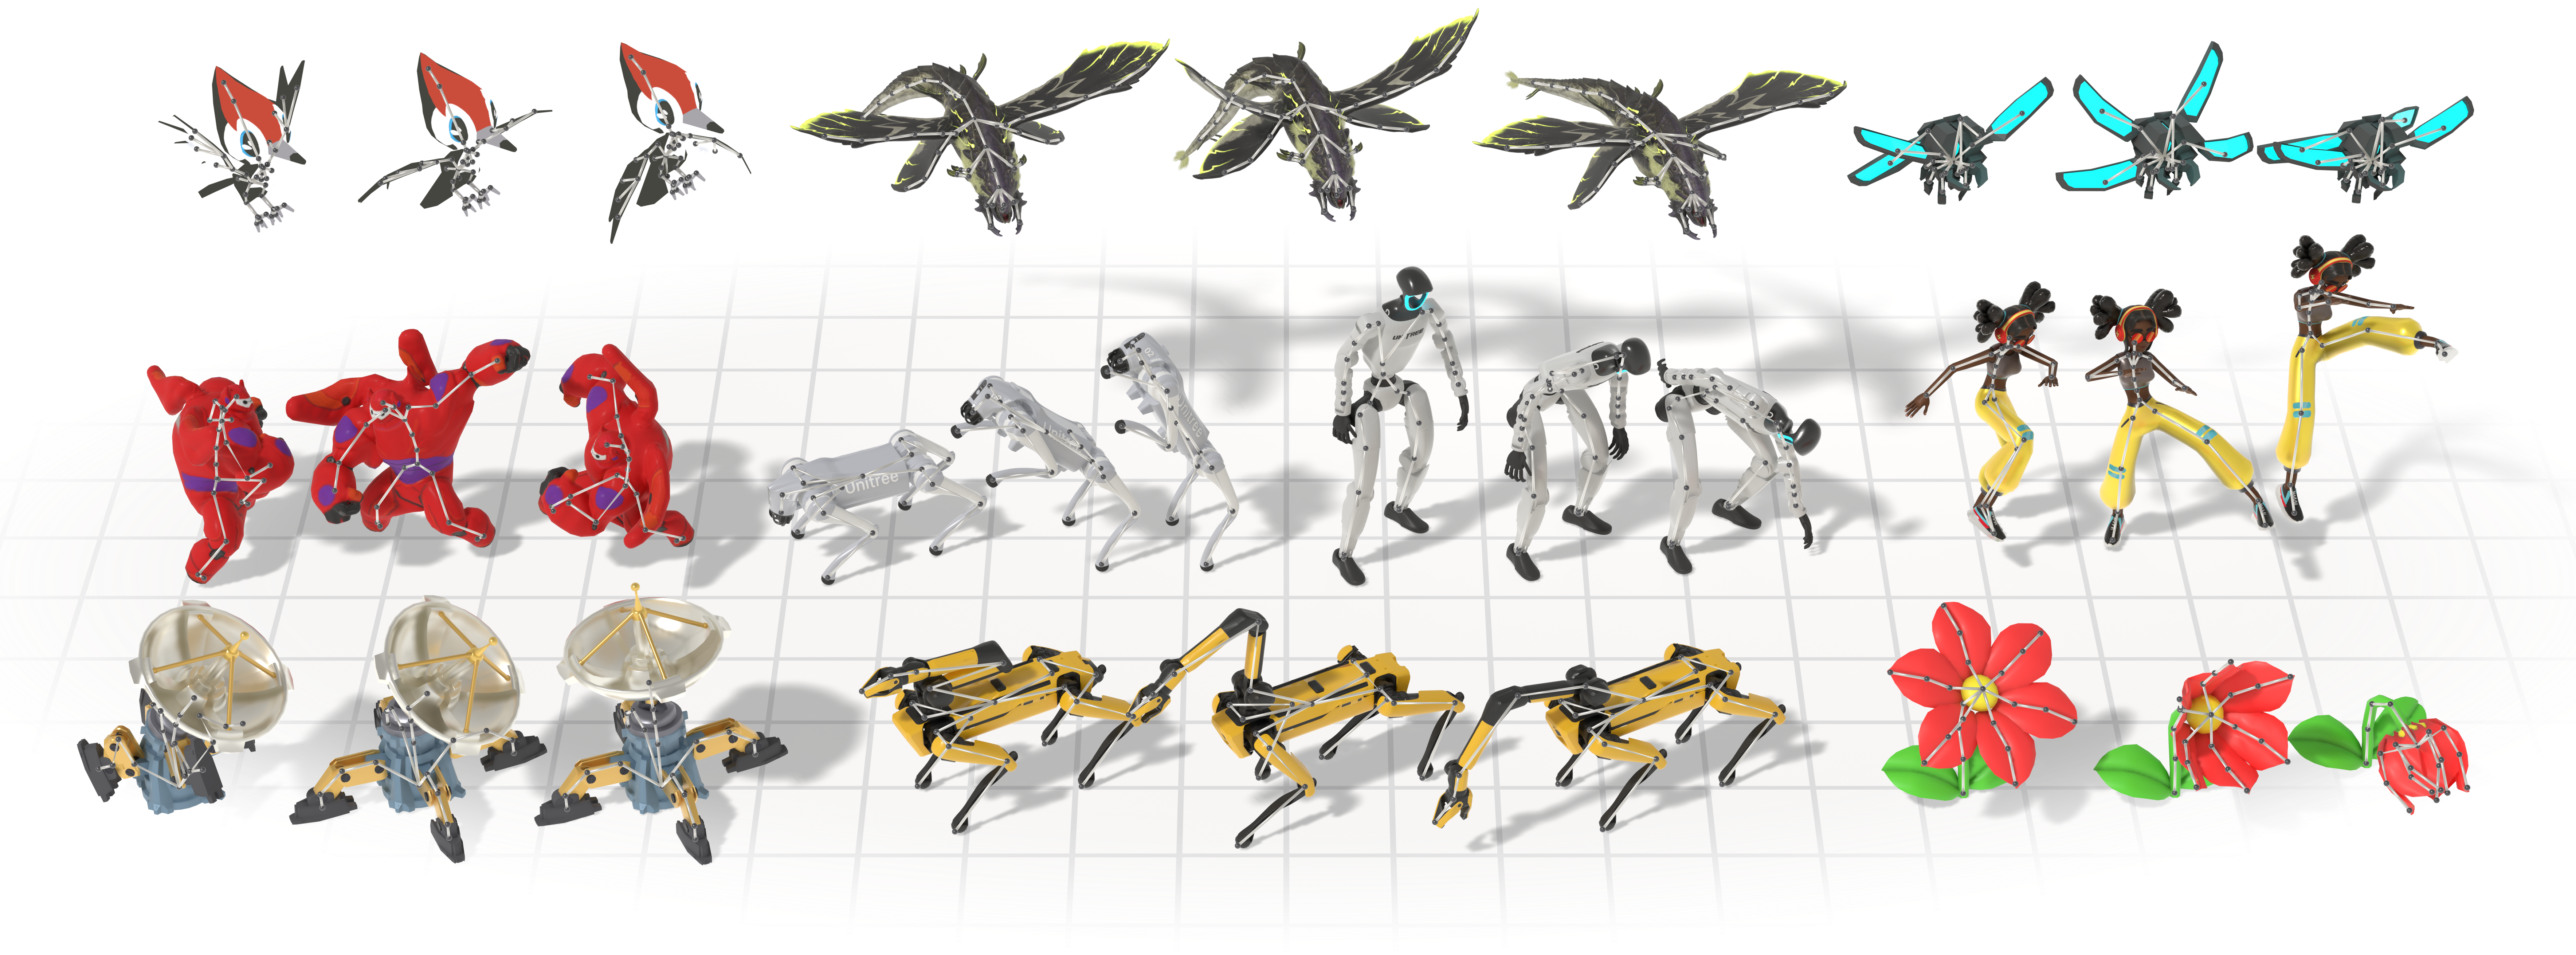
统一骨骼动画生成模型,输入绑定好的 3D 资产加文本提示,即可为任意骨架(双足、四足、鸟、蛇、虫、机械体等)生成动作,无需逐骨架重训或测试时优化。用 flow matching 训练,代码、权重和 13k 条 UniML3D 文本-动作数据集已开源,同一模型还能做关键帧插值、文本引导编辑与长动作拼接。作者注明仍是早期工作,不少动作和骨架会失败;数据受 Mixamo、Objaverse 及 Truebones 商业许可约束。
README
UniMate
一个统一模型,驱动多样化骨骼动画
Linzhan Mou · Jiahui Lei · Zhiyang Dou · Chenyue Cai · Chaoyue Song · Adam Finkelstein · Szymon Rusinkiewicz
Princeton · UC Berkeley · MIT · NTU
🔥 最新动态
- [2026-09-27] 预览版 checkpoint 已在 HuggingFace 发布;新的 checkpoint 也会同步到该处。📦
- [2026-09-06] 训练与推理代码已发布。🚀
- [2026-08-30] UniML3D 数据集及其数据处理流程已发布。🚀
- [2026-08-01] 我们的交互式 Demo已上线 —— 可用 3D 方式浏览我们的动画结果。🎮
- [2026-07-18] UniMate 被 SIGGRAPH Asia 2026 录用!🎉
[TODO] 我们将在本周内发布面向新(分布外)rig 的官方预处理流程。
🛠️ 环境配置
所有组件共用同一个 conda 环境,配置见 requirements.txt:
conda create -n unimate python=3.10 -y
conda activate unimate
pip install "setuptools<81"
pip install -r requirements.txt --no-build-isolation
📊 数据集与数据处理
我们提出 UniML3D,这是一个包含 13,006 条文本配对运动序列的大规模数据集,覆盖多样化的骨骼拓扑 —— 双足、四足、鸟类、水生、昆虫类、蛇形以及铰接刚体对象 —— 全部被统一规范化。
原始源资产可在 Hugging Face Hub 上获取(归集于 UniMate):Mixamo-Animations-Characters、Objaverse-XL-Rigged-Animated 以及 Truebones-ZOO-Annotations(仅包含 prompt、metadata 与渲染结果)。Truebones ZOO 的动物运动本身是商业资产包,其许可证不允许再分发 —— 请直接从 Truebones 购买该资产包;我们的流程会按原样读取标准的 Truebone_Z-OO 文件夹结构。
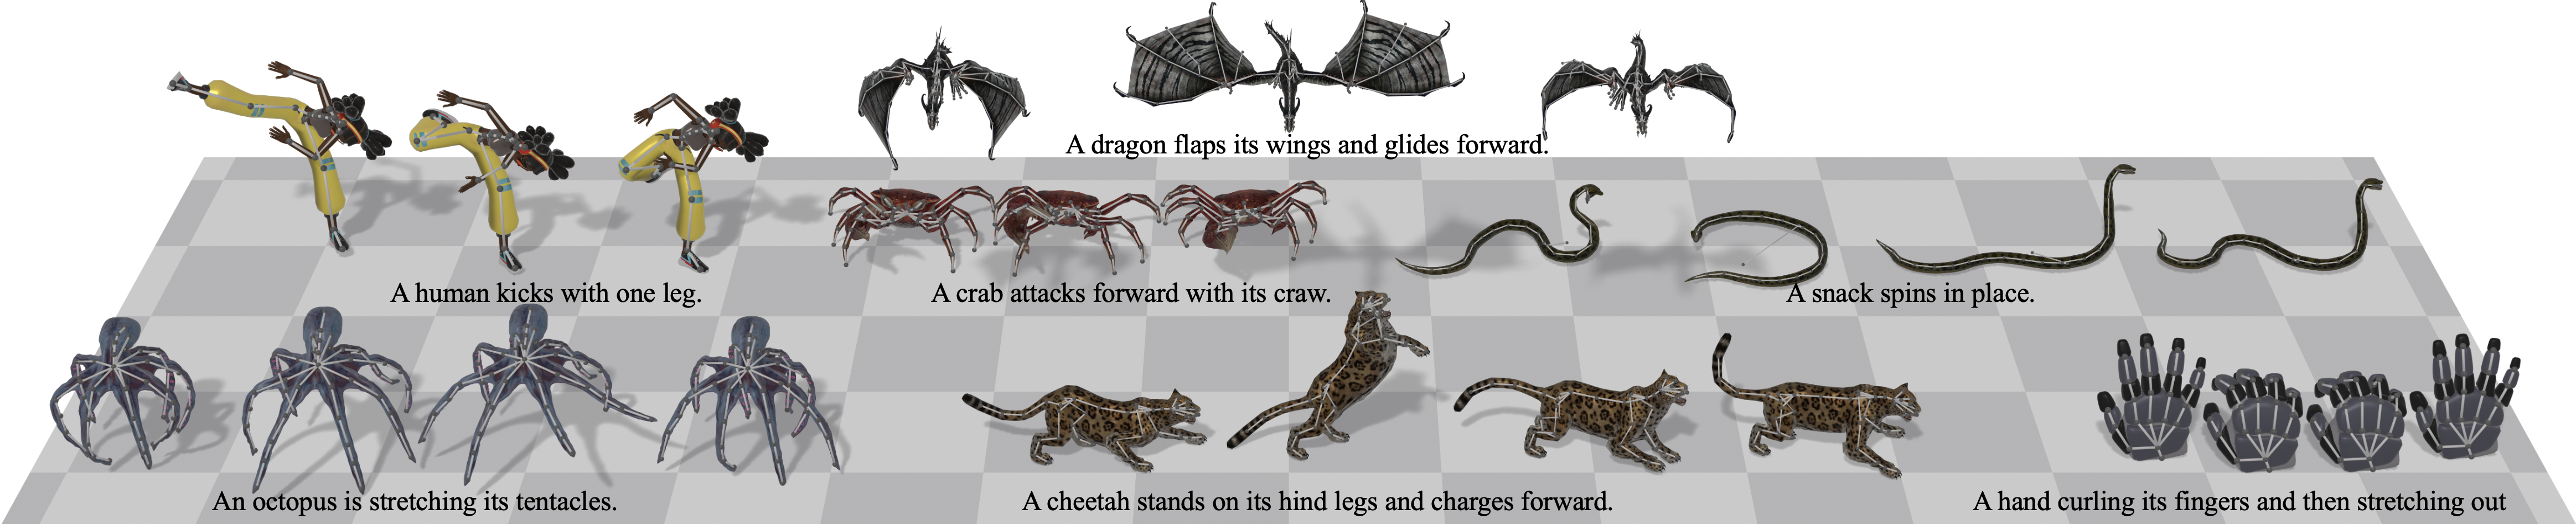
完整的数据处理流程(将原始资产转换为 UniML3D:下载 → 导出 → 渲染 → 生成 caption → 关节标注 → 特征提取 → 动画)请参见 data_process/README.md。
🏋️ 训练
训练会读取位于 dataset/features/<dataset>/ 下的规范化片段,这些片段由数据处理流程的第 4 阶段生成。
训练运行由 configs/ 中的 JSON 文件配置。
{dataset}_{frames}frames_{attention}_{text_cond}.json共 8 个配置:4 种数据组合 × 2 种模型变体,均为 60 帧。
| 前缀 | 训练数据 |
|---|---|
uniml3d_* |
完整 UniML3D 数据集(Truebones + Mixamo + Objaverse) |
truebones_* / mixamo_* / objaverse_* |
单一数据源 |
| 长度 | dataset.max_motion_length |
|---|---|
60frames |
每个片段 60 帧 |
| 后缀 | model.attention x model.text_cond |
|---|---|
_graph_adaln |
graph x adaln —— attention 被拆分为空间(逐帧)与时间(逐关节)两条通路,并带有图距离、边类型与深度 bias;caption 通过 adaLN modulation 注入 |
_full_cross_attn |
full x cross_attn —— 在展平的 joint x time token 上做一次 attention;caption 作为 cross-attention 的 key/value 进入每个 block |
这两个维度相互独立,四种组合均已实现,因此只要在配置中设置,full x adaln 与 graph x cross_attn 也能运行;随仓库提供的两两配对是论文中所比较的那两种。
不跨配置共享的参数:training.batch_size、training.num_steps、model.num_layers 与 dataset.max_joints 会针对每种数据组合单独调优(显存占用随 batch × frames × joints 增长;深度随数据规模增长:单一 Truebones / Mixamo 数据源用 6 层,Objaverse 用 8 层,完整混合数据用 10 层)。dataset.max_joints 对于 truebones_* / mixamo_* 为 100,对于 objaverse_* / uniml3d_* 为 60;dataset.min_joints 在所有配置中均为 5。二者共同限定了单次运行所能接受的骨骼尺寸(超出范围的对象类型会被丢弃),并通过最终保留的数据决定了关节轴 padding 的宽度。Mixamo 只有单一骨骼,因此其配置还关闭了对象类型平衡(单一类型下该操作无实际效果),并且出于选择也关闭了拓扑增强。其他所有设置均相同。
使用 🤗 Accelerate 启动。单 GPU:
accelerate launch -m unimate.training.train --config configs/uniml3d_60frames_graph_adaln.json
单机多 GPU(例如 8 块 GPU):
accelerate launch --num_processes 8 -m unimate.training.train --config configs/uniml3d_60frames_graph_adaln.json
scripts/run_train.sh <config> [-- extra args] 封装了上述单 GPU 命令:会激活 conda 环境、选择空闲显存最多的 GPU,并将 -- 之后的参数转发给训练模块。
--output_dir、--batch_size、--num_workers 与 --resume <checkpoint.pt> 可在命令行覆盖配置。resume 会恢复模型、EMA、optimizer、LR-scheduler 与 step 计数器,因此训练会从中断处精确继续。
每次运行写入 outputs/<experiment name>/:
| 路径 | 内容 |
|---|---|
config.json |
解析后的配置,包括自动计算得到的 max_joints / max_depth;推理时会读取它来重建模型 |
dataset_stats.npy |
归一化统计量,推理时复用 |
checkpoints/checkpoint_step_*.pt |
模型、EMA、optimizer 与 LR-scheduler 状态,每 training.save_interval 步保存一次 |
debug/ |
可视化样例,在训练开始前以及每次保存 checkpoint 时渲染(使用 EMA 权重、sampling.cfg_scale) |
logs/ |
TensorBoard 标量(tensorboard --logdir outputs/<experiment name>/logs) |
当设置 training.balanced 时,片段由幂律平衡采样器抽取 —— 含 n 条片段的类型按 n^(1-sampler_alpha) 的比例被采样,因此在默认 sampler_alpha = 0.5 下,拥有 100 条片段的物种被看到的频率是仅有 1 条片段物种的十倍,而不是一百倍 —— 随后在训练时动态增强 —— 增加关节、移除叶子关节、链式池化以及逐骨骼长度扰动(dataset.use_*_aug)—— 从而让模型见到比数据中实际存在的更多拓扑。每个片段在关节轴上 padding 到 max_joints,在时间轴上 padding 到 max_motion_length,并同时携带 mask;所有 padding 内容都不会参与 attention 或 loss。
训练采用 flow matching(training.diff_model = "flow"):网络在 masked L2 loss 下预测噪声与数据之间线性插值的速度,另加两个基于重建出的干净运动计算的辅助项 —— 测地旋转损失(training.lambda_geo)与速度平滑损失(training.lambda_smooth)。条件以概率 model.cond_mask_prob 被丢弃,使同一份权重同时服务于条件与无条件两条分支,供采样时 classifier-free guidance 插值使用。优化器为 AdamW,配合 cosine 调度与 warmup,梯度在 training.max_grad_norm 处裁剪,并保留一份权重的 EMA 副本(training.use_ema)—— 推理默认加载的就是该副本。
文本编码器(默认 google/flan-t5-base)在首次使用时从 Hugging Face Hub 拉取。每次运行都会加载它一次,用于 embedding 所有 caption 与关节名称;把 embedding 预先计算好并放在特征旁边,就能让它完全脱离训练运行:
python -m unimate.tools.precompute_text_emb --config configs/uniml3d_60frames_graph_adaln.json
这会把 caption_emb_cache.npz 与 joint_emb_cache.npz 写入配置用到的每个 dataset/features/<dataset>/。caption 按 token 缓存(cross_attn 关注该序列;adaln 对其做 mean-pool),关节名称各缓存为一个池化向量,以第 3 阶段产出的清洗后关节词表为键 —— 正是这种统一命名,让同一解剖关节在不同 rig 之间获得相同的 embedding。在重新生成 caption 或关节名称后请重新运行它:缓存未命中的内容仍会在加载时编码,因此过期的缓存只影响速度,不影响正确性。
Objaverse-XL 中有相当一部分 rig 和片段是有缺陷的:静止姿态平躺、旋转或上下颠倒,以及将若干不相关动作拼接在一起的片段。在这些数据上训练可能导致运行不稳定或崩溃,而训练 loss 中孤立的尖峰通常是有缺陷数据的症状,而非优化问题。
若要定位问题,可先在仅 Mixamo 与 Truebones 上训练 —— 在某个配置的副本中把 dataset.dataset_list 设为 ["truebones", "mixamo"]。如果该运行正常,则问题出在 Objaverse 一侧。接下来,可人工或通过自动流程检查 dataset/features/objaverse/videos/ 下可疑对象类型的骨骼预览视频,并把有问题的 rig 与片段加入第 4 阶段的跳过列表,该列表由 tools/patch_annotations.py 维护。
📌 说明
处理后的 UniML3D 数据集正在准备开放发布。其 caption 已为本次发布重新处理,因此未必与项目主页或论文中展示的 prompt 一致。已发布 caption 的风格可参见 Truebones · Mixamo · Objaverse。新 prompt 以 "An object" 开头,以便跨对象泛化。
UniMate 是面向任意骨骼的 text-to-animation 的早期一步,许多运动与骨骼仍然失败。我们相信扩大训练数据规模 —— 从 agent 中蒸馏,或从视频中生成 —— 是弥合这一差距的有前景方向。如果你遇到失败案例,请提 issue 或联系我们;它们能帮助我们改进。
🎬 推理
给定一个已绑定骨骼的 3D 资产与一段文本 prompt,UniMate 能实时为任意骨骼生成铰接运动 —— 无需针对每种骨骼重新训练,也无需测试时优化。
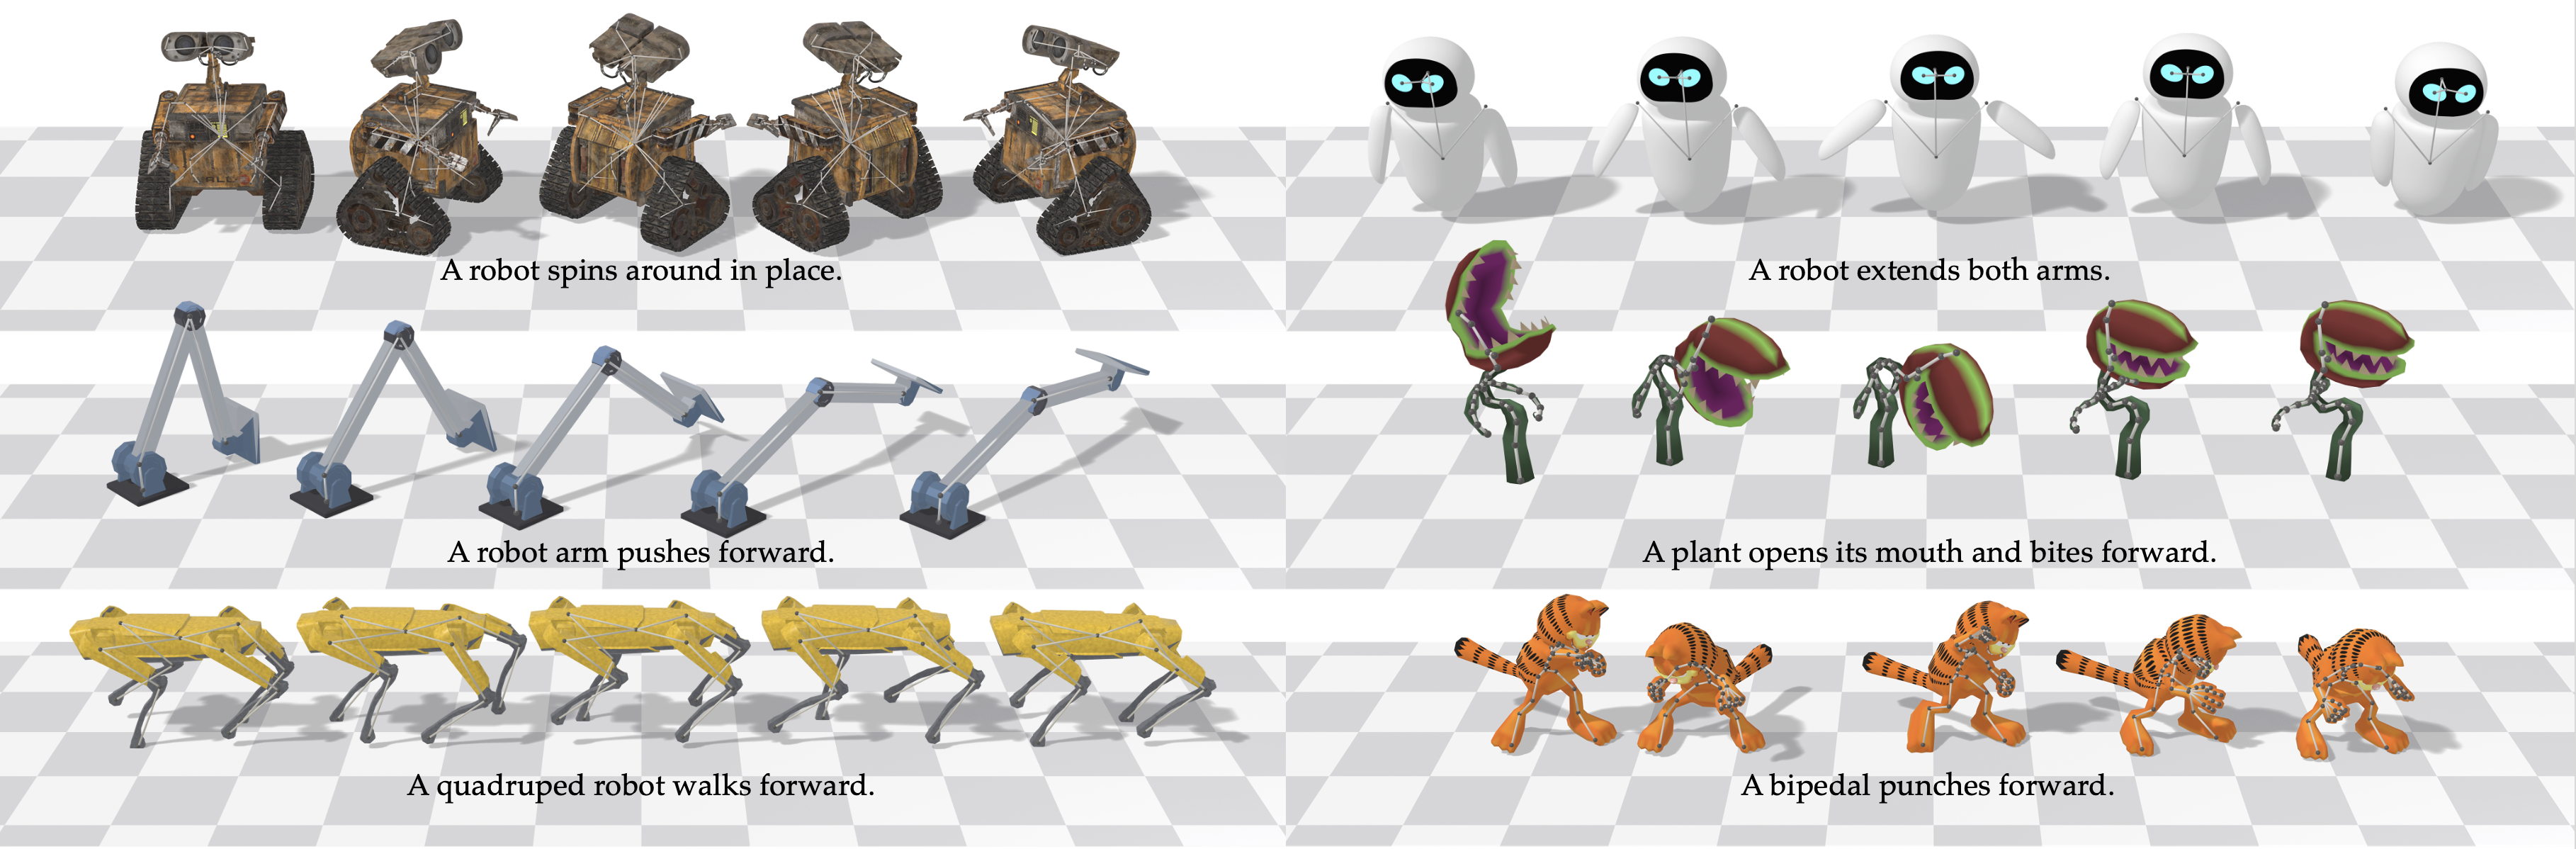
采样从某次训练运行的输出目录开始(config.json、dataset_stats.npy、checkpoints/)—— 发布的 checkpoint 采用相同的目录结构。目标骨骼 —— T-pose 与拓扑条件 —— 取自数据集,因此模型训练所用的 dataset/features/<dataset>/ 目录必须存在。
python -m unimate.inference.sample \
    --exp_dir outputs/uniml3d_60frames_graph_adaln \
    --test_cases_json test_cases.json \
    --num_repetitions 3
测试用例是一个 JSON map,从 <object_type>-<case_id> 映射到 prompt。object_type 必须存在于数据集中;case_id 是自由形式的标签,用于命名输出文件:
{
  "Dog-walk": "a dog walks forward at a steady pace",
  "Dragon-takeoff": "a dragon flaps its wings and takes off"
}
--test_cases_json 本身是可选的:不提供时,数据集 eval split 中的每个片段都会被枚举为一个测试用例(若无 eval split,则回退到 train 中唯一的 (object_type, caption) 组合)。--test_cases_txt(每行一个 object_type)用于驱动无条件采样,这要求 --cfg_scale 1.0。
| 参数 | 作用 |
|---|---|
--cfg_scale |
Classifier-free guidance 的缩放系数(>= 1.0);默认取该次运行配置中保存的值 |
--model_path |
指定某个 checkpoint;默认为最新一步 |
--output_dir |
默认为 <exp_dir>/samples |
--num_repetitions |
每个测试用例生成的样本数 |
--batch_size |
分块推理的 batch 大小;无论有多少用例,都会限制显存占用 |
--seed |
固定采样噪声 |
--only_save_motion |
跳过 MP4 渲染,仅写出 .npy 特征 |
--save_ric |
在 FK 渲染之外额外保存 RIC 恢复的渲染结果 |
每次运行写入:
| 路径 | 内容 |
|---|---|
motions/<case_id>-rep_<r>-<i>.npy |
生成的运动特征 (T, J, 12),每次重复一个文件 |
animations/<case_id>-rep_<r>-sample<i>_fk.mp4 |
每个样本的骨骼渲染(使用 --save_ric 时为 _ric.mp4 变体) |
animations/<object_type>_tpos.png |
作为条件的 T-pose |
captions.json |
每个保存的 .npy 所用的 prompt |
scripts/run_sample_motion_text.sh <exp_dir> [test_cases_json] [cfg_scale] 会运行上述命令,并激活 conda 环境、选择空闲显存最多的 GPU,输出目录名取自测试用例文件名。用 -h 可查看其选项。
要用生成的运动驱动原始 mesh,请把 .npy 文件交给数据流程的第 5 阶段,它会导出动画 GLB + FBX:
bash scripts/run_animate_motion.sh objaverse \
    outputs/uniml3d_60frames_graph_adaln/samples/motions/Dog-walk-rep_0-0.npy \
    outputs/animated
它可接受多个文件或一个目录,默认从 dataset/features/<dataset>/cond.npy 读取 rig。
🎨 应用
同一个训练好的模型无需额外训练即可完成另外三项任务。每一项都是替换式采样:运动的一部分被固定为已知信号,flow ODE 在每一步只对其余部分去噪,因此约束是精确成立的,而非通过损失来鼓励。
运动中间帧插值(Motion in-betweening)
将选定关键帧固定在其 ground truth 上,生成它们之间的过渡。
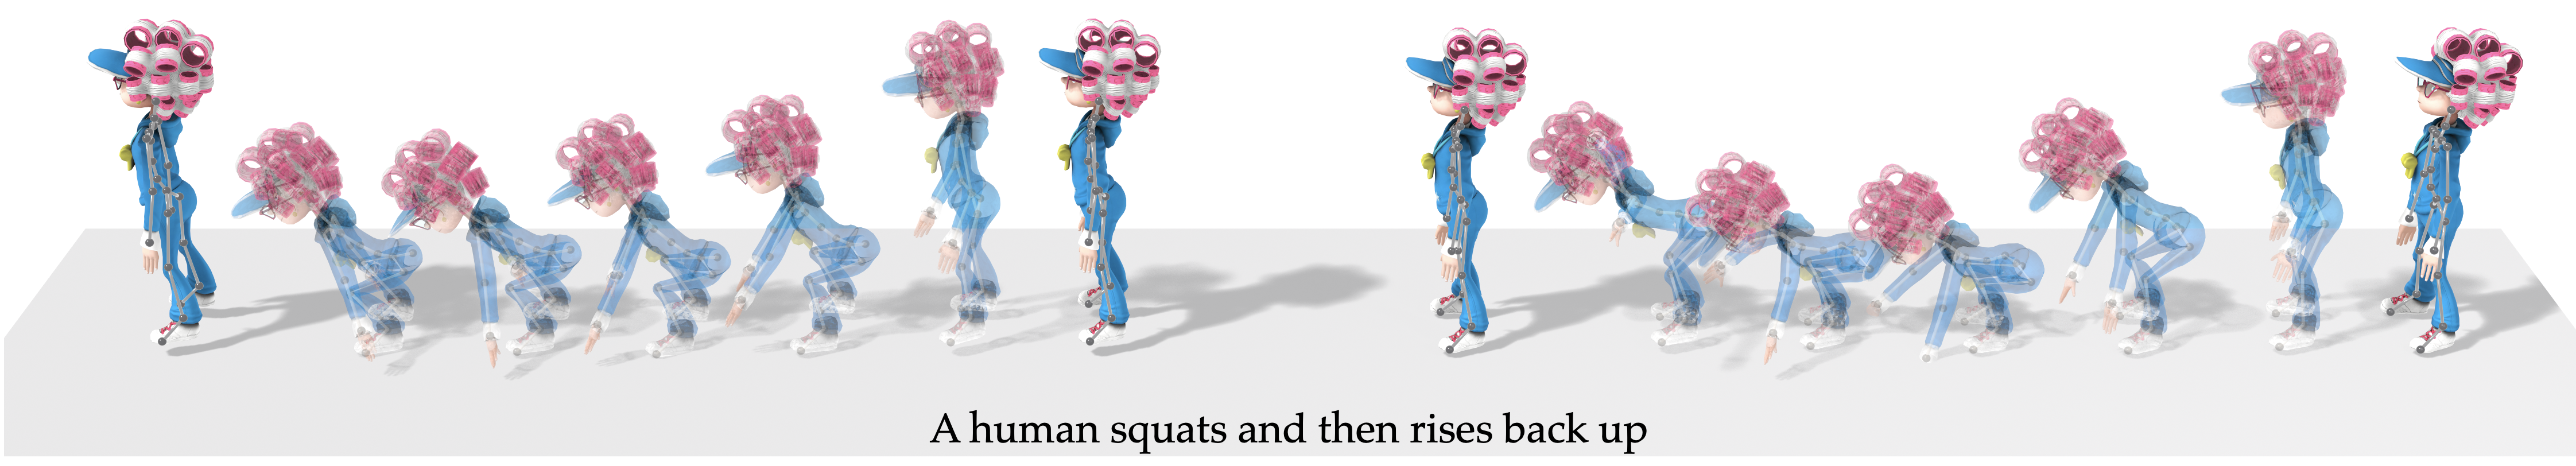 如何运行
--keep_frames 接受带符号的索引(负数从生成窗口末尾往前计),因此 "0,-1" 会补全某个片段首帧与末帧姿态之间的一切。
{ "mixamo-Squat-000": "A human squats and then rises back up" }
KEEP_FRAMES="0,-1" bash scripts/run_sample_motion_inbetween.sh \
    outputs/uniml3d_60frames_graph_adaln cases.json
文本引导的运动编辑
在每一帧上把选定关节保持在其 ground-truth 运动上,并在新的 prompt 下重新生成其余部分 —— 保留该保留的,重新动画化其余的。
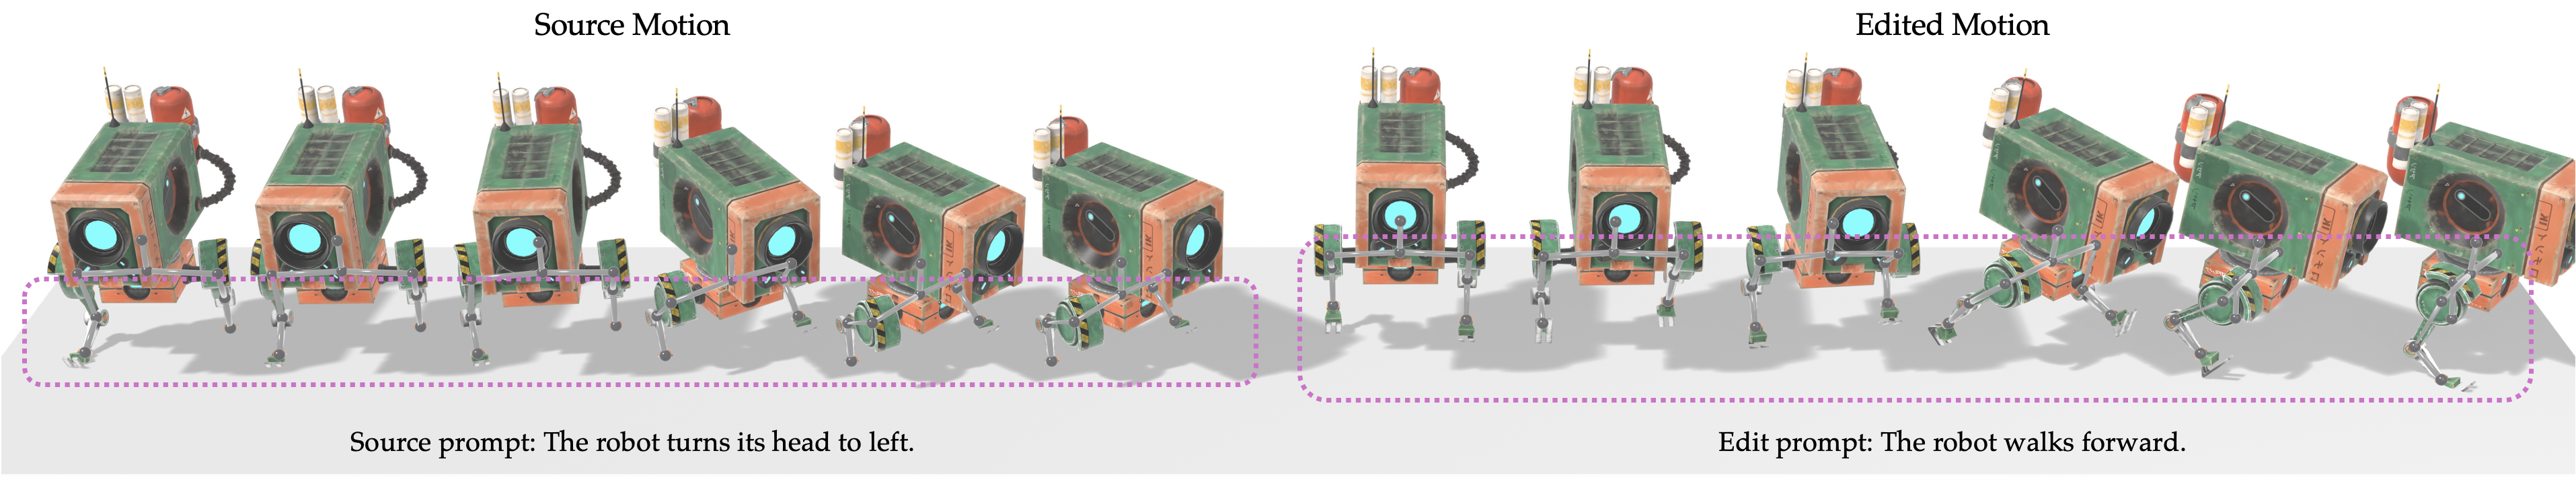 如何运行
--keep_joints 会以大小写不敏感的方式匹配 rig 自身的骨骼名称或清洗后的词表。
{ "<objaverse_uid>-turn-head-000": "The robot walks forward." }
KEEP_JOINTS="Hips,Spine,Neck,Head" bash scripts/run_sample_motion_edit.sh \
    outputs/uniml3d_60frames_graph_adaln cases.json
运动扩展
把若干 prompt 串联成一段长运动。第一段自由生成;之后每一段都将其开头若干帧固定到上一段的尾部,并在接缝处拼接。
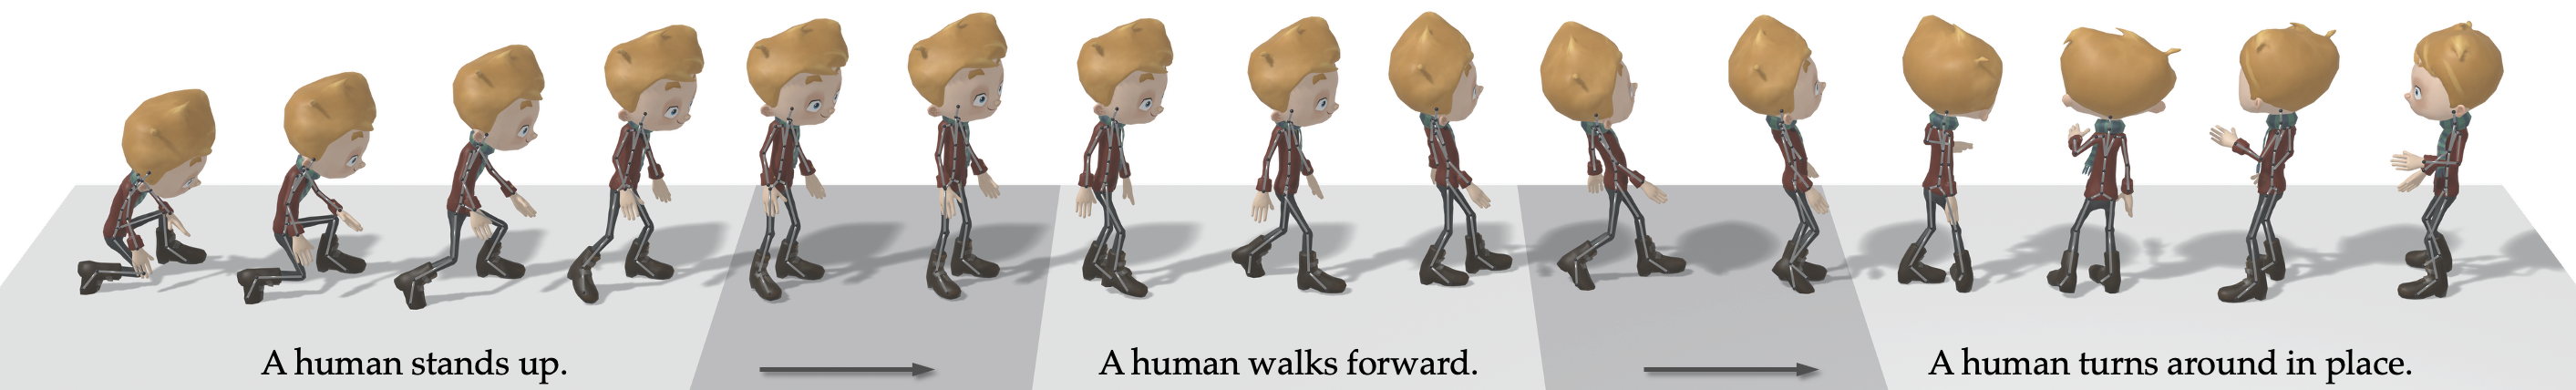 如何运行
测试用例的取值变为 prompt 的列表,每段一个;--expand_overlap 设置相邻段共享多少帧。
{ "mixamo-sequence": ["A human stands up.", "A human walks forward.", "A human turns around in place."] }
EXPAND_OVERLAP=10 bash scripts/run_sample_motion_expand.sh \
    outputs/uniml3d_60frames_graph_adaln cases.json
每种模式都写入 --output_dir 下各自的子目录(inbetween/、motion_edit/、motion_expand/),并附带一个小 JSON,记录产生该结果的约束;每种模式在 scripts/ 中都有一个 wrapper —— 用 -h 运行任一个即可查看完整选项列表。
In-betweening 与编辑是对真实片段做 clamp,因此其测试用例键必须是 <object_type>-<clip_id>,指向数据集确实拥有的片段;该片段的运动会以 <case_id>-gt_rep_<r>-<i>.npy 保存在结果旁边,便于并排比较。--gt_start_frame 用于指定使用片段的哪个窗口,而非随机窗口。编辑会同时将样本与 GT 裁剪到片段的真实长度,而 in-betweening 会生成完整窗口、只裁剪 GT —— 因此请在第 0 帧上对齐二者,而不要假定长度相等。三种模式都要求 --cfg_scale > 1.0,且彼此互斥。
📝 引用
如果你在研究中觉得 UniMate 有用,请考虑引用我们的工作:
@article{mou2026unimate,
  title   = {UniMate: One Unified Model to Animate Diverse Skeletons},
  author  = {Mou, Linzhan and Lei, Jiahui and Dou, Zhiyang and Cai, Chenyue and Song, Chaoyue and Finkelstein, Adam and Rusinkiewicz, Szymon},
  journal = {arXiv preprint arXiv:2609.05415},
  year    = {2026}
}
⚖️ 许可证
本仓库中的代码以 MIT License 发布。
数据集仍受其原始来源许可证的约束:Mixamo 资产受 Adobe 的 Mixamo 使用条款约束,Objaverse-XL 资产受各原始对象所附许可证约束,Truebones ZOO 运动受 Truebones 商业许可证约束。使用数据前请审阅并遵守相应来源的许可证。
🤝 致谢
我们感谢 AnyTop 的作者开源其代码库,本仓库的部分内容建立在其之上。