Meta 发布 Memory Mosaics 论文,或颠覆 Transformer 架构
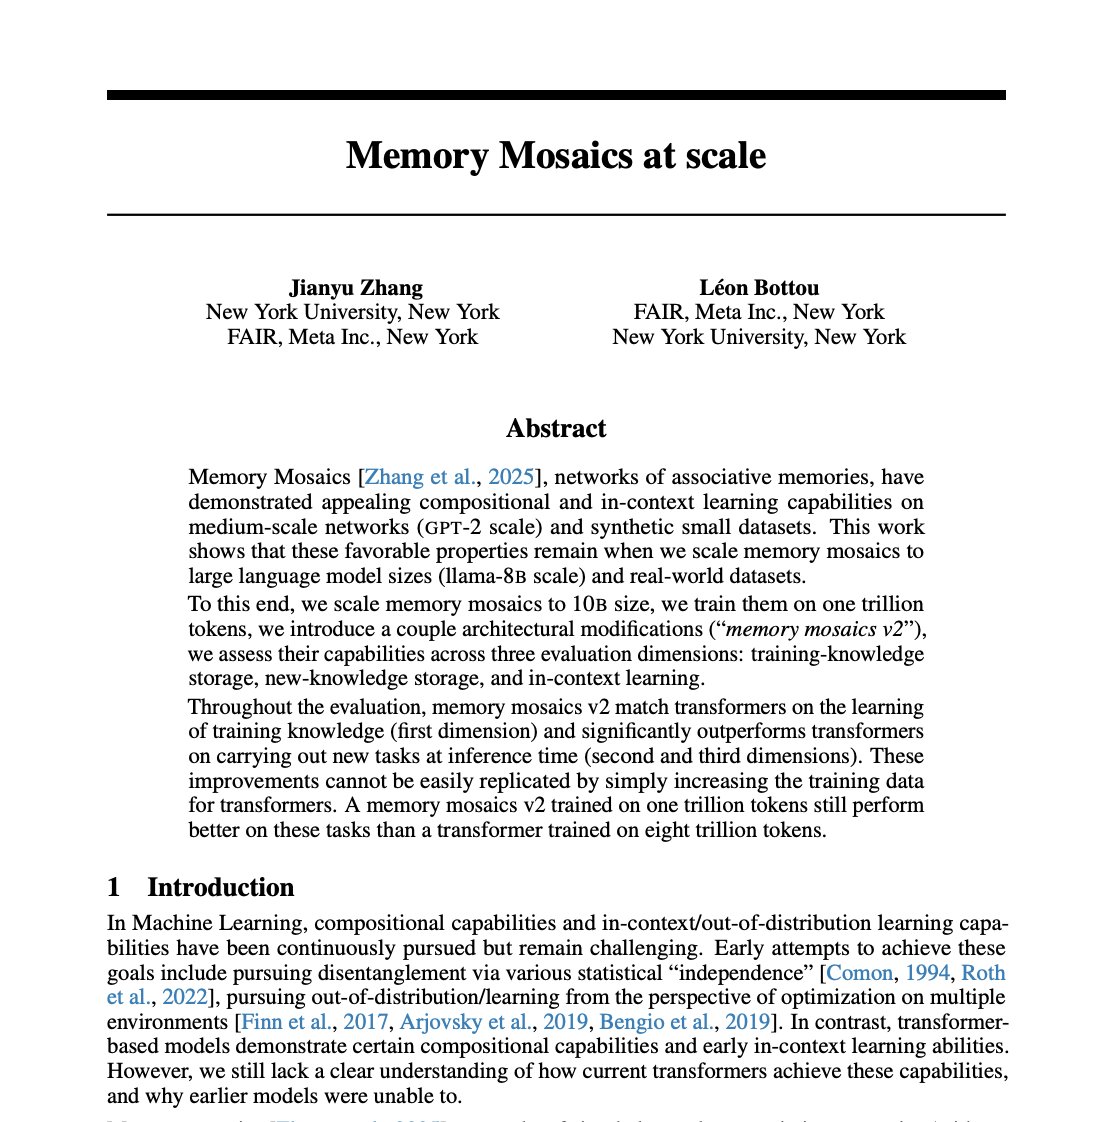
转发 @CrazyShyyt:Meta 发表了一篇可能终结 Transformer 时代的论文。
过去七年里,所有主流 AI——ChatGPT、Claude、Gemini——都建立在完全相同的架构之上。
Transformer。
但 Transformer 有一个巨大且代价高昂的缺陷。
为了变得更聪明,它们依赖无休止的、暴力式的训练数据供给。而为了记住长上下文,其计算成本会急剧膨胀。
我们曾以为唯一的出路是更大的 GPU 和无尽的数据中心。
但 Meta 证明我们错了。
他们发表了《Memory Mosaics at scale》,彻底改写了 AI 处理信息的方式。
Meta 没有采用标准的注意力机制,而是构建了一个联想记忆网络。
它的工作方式不太像一台不停运算序列方程的计算机,而更像一个存储并选择性检索特定键值对的设备。
结果令人震惊。
一个仅用 1 万亿 token 训练的 Memory Mosaics 模型,完全超越了一个用 8 万亿 token 训练的传统 Transformer。
好好想想这一点。
它击败了一个用 8 倍数据训练的模型。
它还展现出更优的上下文学习能力,以及仅用极少量样本就能解决全新任务的能力。
它能自动将复杂问题自然地拆解为更小、独立的子任务。