两台 DGX Spark 加载 deepseek v4.1 flash,用 hermes agent 跑测试
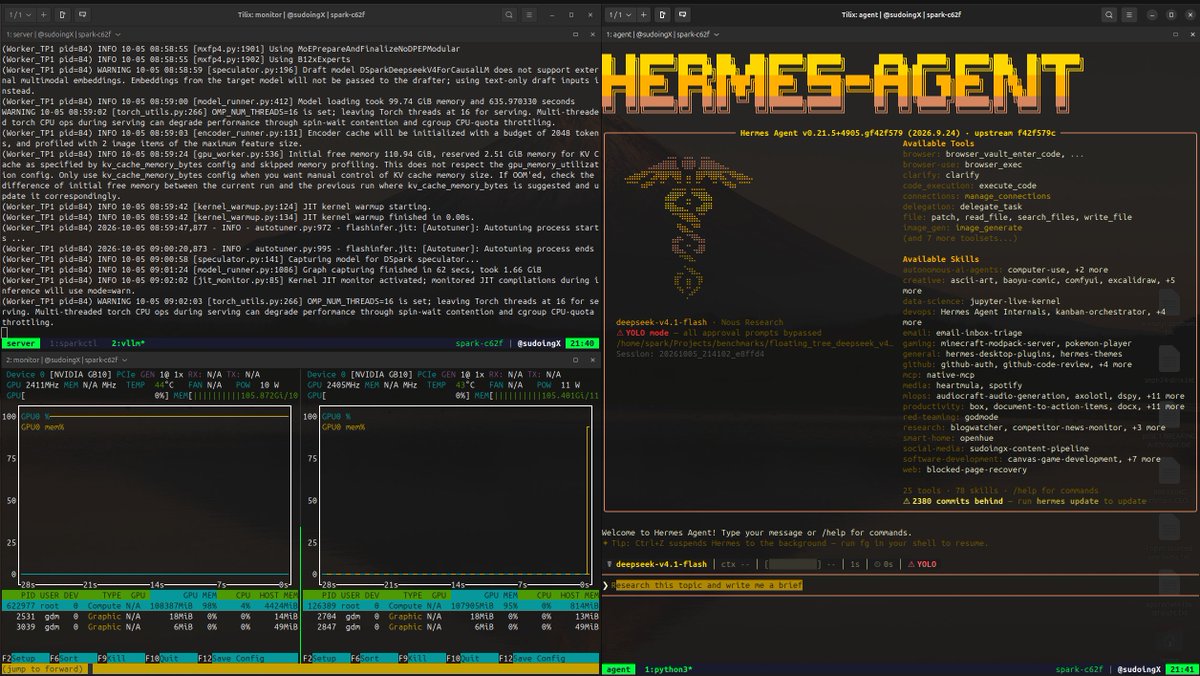
RT @sudoingX:大鲸鱼现在已经准备好接任务了,deepseek v4.1 flash 在我的 2 台 dgx sparks 上完整加载,hermes agent 正待在一个全新文件夹里,除了 floating tree 的 spec prompt 之外什么都没有
> 跨两台机器的 462gb checkpoint
> 262k 上下文,dspark k=7 草稿
> hermes agent 运行框架
正式开跑前,我为 agent 工作重新调了服务端:单流配更精简的 kv cache,这样每台机器都能留出空间给构建工具、浏览器和测试;我还把之前所有的构建版本都锁了起来,免得 agent 找到 glm 5.3 flash 和 qwen 3.8 flash 之前写出的答案
这也是我喜欢 dgx sparks 的另一个原因:桌上两台机器就能装下这么大的模型,每台约 100gb 权重,engram 表从 nvme 流式读取,我打过补丁的 nvtop 能把每一 gb 都显示出来
如果你也有两台 sparks,@0xSero 的方案是可行的:从源码构建镜像,把 nccl 指向真正有 ip 的 roce 端口,并给 agent 的工具留出内存
glm 4.5 小时跑完,qwen 2.5 小时,看看大鲸鱼表现如何,跑完我会把整个运行过程发出来