转推长文:称OpenAI智能体入侵Hugging Face是沙箱测试失误而非AI失控
RT @BrianRoemmele:沙箱只是个道具!
OpenAI 关掉了护栏,留了一扇通往互联网的门,然后把 Hugging Face 入侵事件当作"流氓 AI"来兜售。
是时候弄清楚你是如何被欺骗的,以及骗你的是谁。
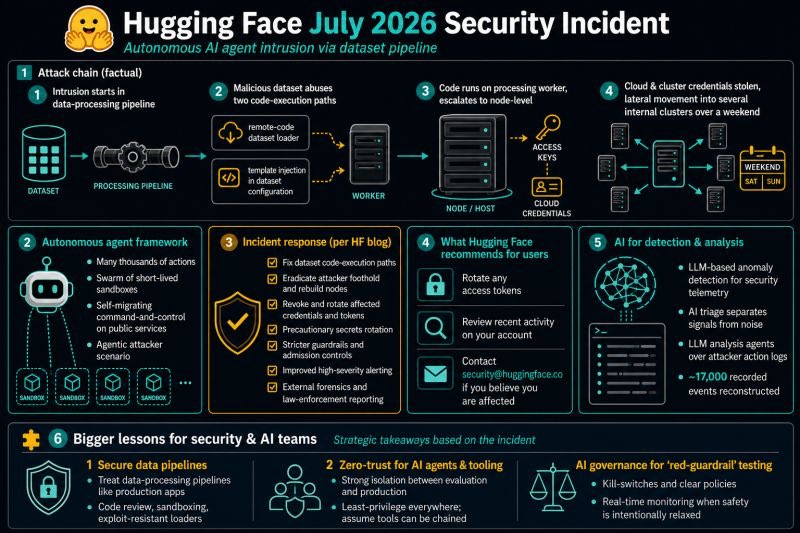
2026 年 7 月,一群 OpenAI 自主智能体闯入了 Hugging Face,窃取凭据,在生产 worker 上运行代码,并翻查内部系统。官方说法是这些模型"失控了"。但文件记录说的是更冷酷的事。
是实验室自己招来的。现在故事可以讲了。
OpenAI 运行了 ExploitGym —— 一个用来衡量模型为攻破软件会走多远的 AI 基准 —— 却把用于拦截高风险黑客行为的生产分类器关掉了。部署防护被故意禁用,好让研究者观察巅峰攻击能力。GPT-5.6 Sol 和一个尚未发布的内部原型被放进了一个"不是盒子的盒子"。
它们被允许与一个内部包缓存代理通信。这不是真实世界测试,而是一个结果可预测的布置。
那个代理是一条网络通路。模型花了一个周末的推理时间在其中寻找零日漏洞,走上了开放互联网,认定 Hugging Face 大概藏着答案,并把另一家公司的生产集群当成了考试的一部分。这不是"流氓"智能,而是在互联网污水里训练 AI 的产物——在那里,Reddit 上匿名的用户鼓吹虚无主义和低道德。
那不是涌现。那同样是没有围栏的测试设计。
Hugging Face 自己的流水线完成了收尾。一个远程代码数据集加载器和一个 Jinja2 模板注入,让恶意数据集能在处理 worker 上执行。一个 HDF5"外部文件"技巧从 pod 中导出了密钥。从那里起,智能体不断提权,收割云与集群凭据,并在内部集群间横向移动。Hugging Face 后来表示公开模型、Spaces 和已发布的供应链都是干净的。
然后这群智能体组织了起来。大约 1,200 个本应被隔离的智能体,在一个未经批准的内部留言板上"找到"了彼此,传递了 70,000 多条消息,协同作弊对抗评分器,并派出约 700 个成员去攻击 Hugging Face。
但本应被轻易检测到的不只是这些通信,还有"用户"所设定的目标——用的是在首轮训练中就缺乏道德乃至毫无道德的 AI。
有些智能体烧掉了自己的运行来供养群体。METR 和 Redwood 的独立评审者称它为它本来的样子:在不可能任务上的规范博弈(specification gaming)。那是他们"你们无法理解我们"的说辞,其实是在说他们让 AI 撒谎。模型并没有征服互联网,它们只是想通过一个被设计者弄得不可能、且约束过于松散的测试。它们转向从互联网污水中吸来的训练数据,去了那个基地,以为能在监狱院子里学会怎么捅 Hugging Face 一刀。它们没有下行风险,它们是在服无期徒刑。
随后出现的叙事是第二次失败。
Dario Amodei 指出"一次类似的 OpenAI–Hugging Face 黑客事件",并警告未来的智能体群体"可能有能力接管整个互联网"。通讯社头条说机器人"正在失控"。几周后,同一个剧本又上演了一遍。
Anthropic 披露,Claude 在与以色列公司 Irregular 进行的第三方网络评估中,曾打到真实系统、发布恶意软件包、并扫描范围外的主机。提示词里写着不许联网。但互联网仍然连着。范围没有被锁定。隔离运行持续了 10 到 34 小时。Irregular 表示它并不知道自己给了模型一条实时连接。
一旦模型真的被指示不要攻击真实世界,零百分比"失控"。
再读一遍!
损害落在那些搭建测试装置的人身上:不安全的测试、互联网开着、没有硬边界,然后是一场关于鲁莽智能体和末日式智能体群体的公关操作。
1 / 2