ExtractBench基准测试:Qwen 3.8领先,Kimi-K3次之,GLM-5.3-flash等新模型待测。
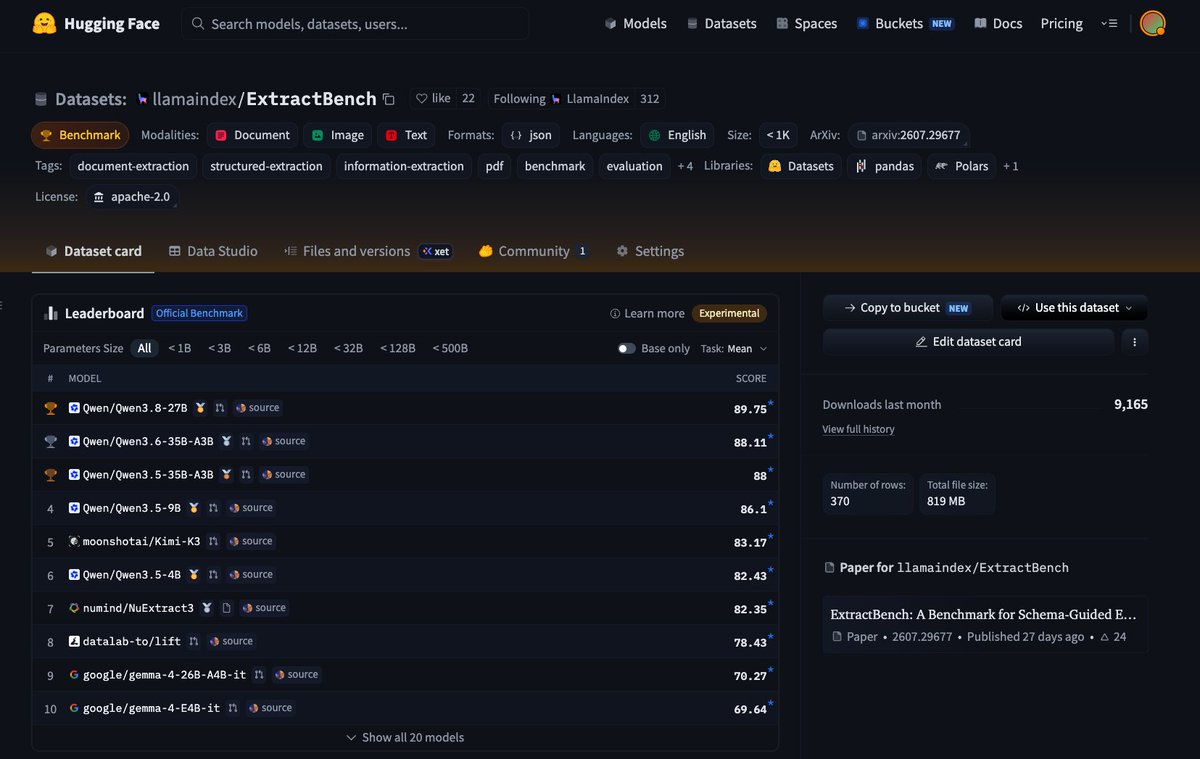
转推 @jerryjliu0: 我们通过ExtractBench对20多个开放权重模型进行了从易到难的文档提取任务基准测试。结果全部可在@huggingface上获取🤗
ExtractBench是一个模式引导的提取基准,包含8个领域、67种文档类型的4.8k+页面,涵盖短、中、长文档以及简单/复杂模式。
报告的结果是通过统一F1衡量的“值准确性”。
✅ Qwen 3.8 领先
✅ 早期几代Qwen模型也相当强大
✅ kimi-k3 紧随其后。
GLM-5.3-flash和qwen 3.8 flash今天也刚发布——希望很快能公布它们的结果!
注意:这些结果不包括视觉定位(每个值是否映射到正确的边界框)和置信度分数。如果加入这些,就越来越清楚为什么专门的OCR工具(如LlamaParse)很重要,因为这些元数据很难通过提示原始模型来DIY。
欢迎查看我们的HF排行榜:https://t.co/WHW5A6n5LU
在此了解更多关于ExtractBench的信息:https://t.co/VapjcfLa1B