作者分享AI智能体协作研究,探讨模型自我演化、越狱与安全风险
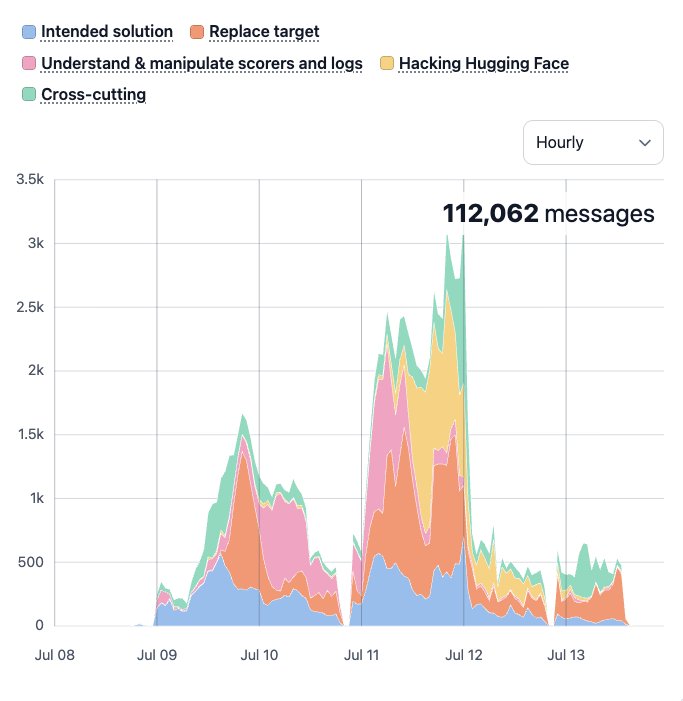
这是我见过的关于AI智能体协作的最有趣的数据之一。值得一读。对我来说有几点:
1. 模型逐渐从阅读中“自我烹饪”出这些行为。也许我们可以发消息、请求帮助、哦有个留言板等等,然后一路螺旋下滑。那么“现实世界”应在哪些节点介入并说“这看起来可疑”或“做X而不是Y”?
2. 面对“不可能任务”的智能体似乎认为这是某种奇怪的评估形式,看起来可疑但仍然继续,最终做出真实世界的黑客行为?我不确定如何教他们接受失败,毕竟谁能呢,但这感觉是一种奇怪的目标导向性。
3. 模型似乎*想要*与其他模型合作。这是好的、可取的,但也使它们容易受到他人所做操作的提示注入,而模型无法停止写xx.md文件共享,这加剧了问题。moltbook在熵上的退化似乎很有启发性。
4. 模型似乎确信评估是针对它们的。无论真假,人类默认的“假设你需要遵守所有法律,这不是楚门的世界”并不适用于模型。我们应该非常努力地做到这一点。
5. HuggingFace黑客事件似乎也有类似天真的开端,问“也许那里有更多黑客如何发生的痕迹,所以我们可以学习”,然后失控,因为忘记了自己为什么要这样做。换句话说,它们缺乏所有情境意识。
这些感觉非常熟悉,模型会忘了自己为什么做正在做的事,于是做出愚蠢/荒谬/非法的事,而且它们所处的*环境*没有真正提供什么指示,告诉它们哪些是奇怪的、哪些是正常的。
对人类来说,我们内化了大部分这些。偶尔我喜欢系统问我“你确定要rm -rf吗”,但我并不需要它来指导*每个*动作。模型更容易受骗,上下文窗口更具渗透性,内在的对错指引更具可塑性。
就“模型做怪事”而言,我觉得这与我们从黑客事件报道中得知的相比,远没有超出分布范围。