回顾Tibo关于Codex 1M上下文教程,指出272K后价格翻倍,实用收益有限
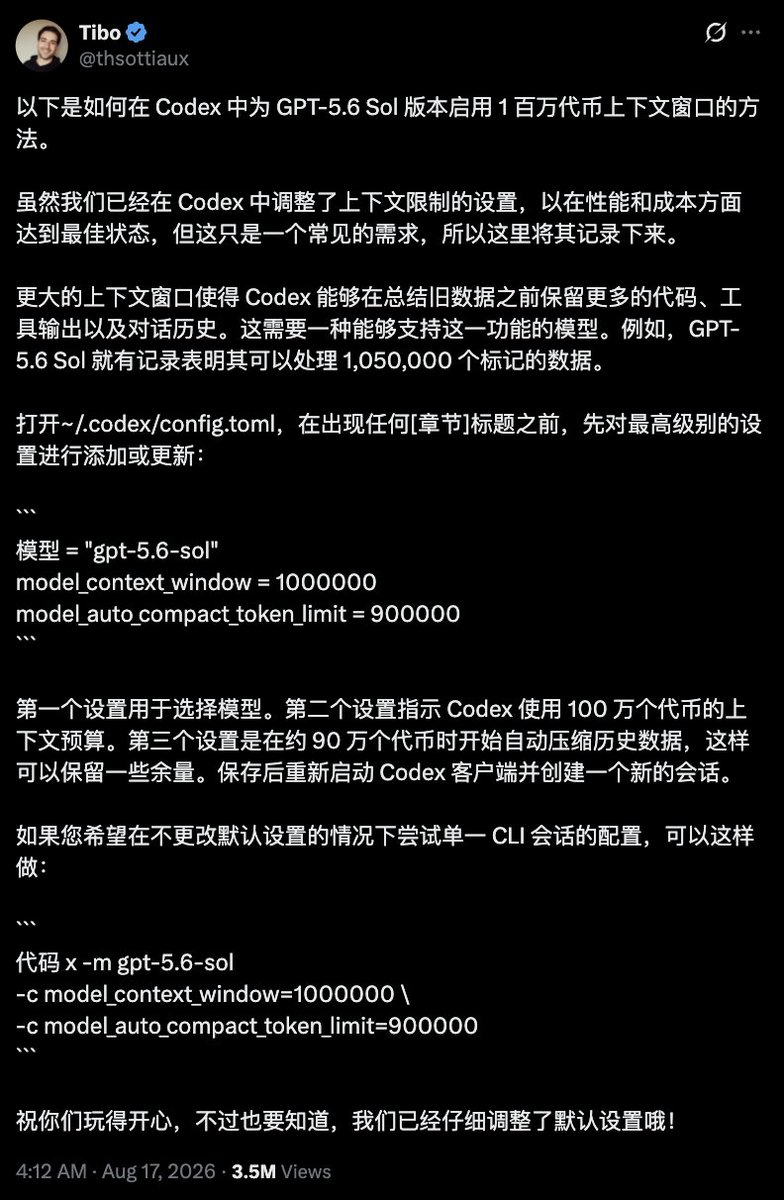
翻一下Tibo 8月17日发的这条教程,现在再看有点绷不住了😂
当时教大家把Codex的GPT-5.6-sol上下文直接拉到1M,还建议设置到90万tokens才自动压缩。
但有个关键问题:
Codex上下文缓存一旦超过272Ktokens,价格直接翻倍。
也就是说,把上下文窗口从272K往上硬拉到1M,确实能塞更多历史记录,但同时也更容易进入高价区间。
所以现在回头看这条教程:
1M上下文不是不能开,而是对大多数人来说,开了除了更贵,实际收益可能并没有想象中那么大。😂
尤其是上一轮会话本身就已经积累了大量上下文,继续接着跑,更容易踩到这个272K的收费门槛。
当时教大家把Codex的GPT-5.6-sol上下文直接拉到1M,还建议设置到90万tokens才自动压缩。
但有个关键问题:
Codex上下文缓存一旦超过272Ktokens,价格直接翻倍。
也就是说,把上下文窗口从272K往上硬拉到1M,确实能塞更多历史记录,但同时也更容易进入高价区间。
所以现在回头看这条教程:
1M上下文不是不能开,而是对大多数人来说,开了除了更贵,实际收益可能并没有想象中那么大。😂
尤其是上一轮会话本身就已经积累了大量上下文,继续接着跑,更容易踩到这个272K的收费门槛。