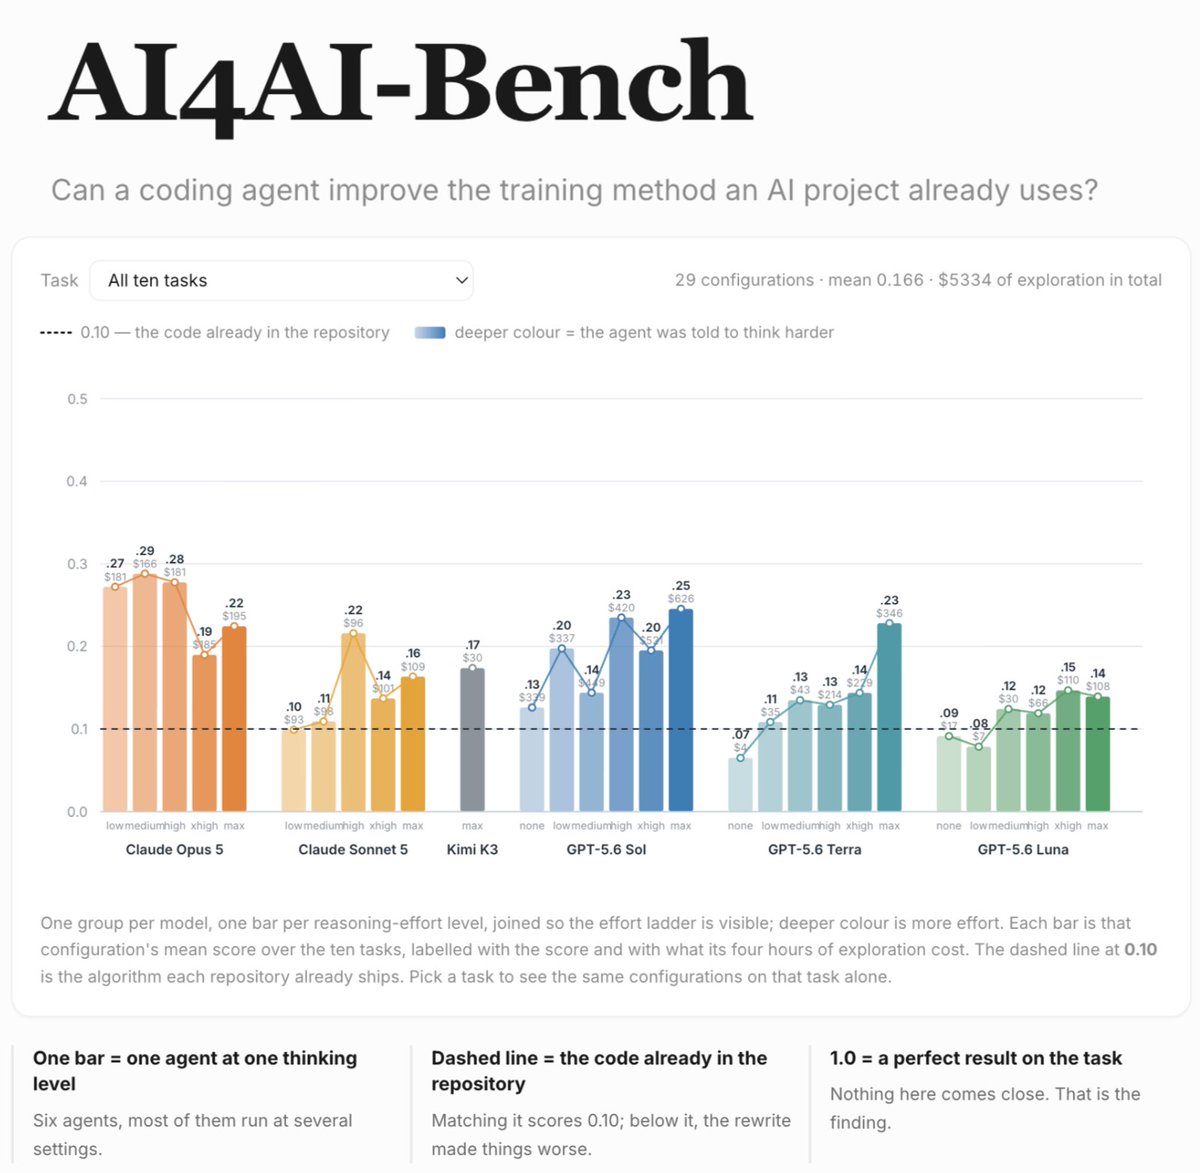
AI4AI-Bench 显示递归自我改进平均得分仅 0.166。
RT @EinsiaAI: 1/
递归自我改进(RSI)依赖于代理改进 AI 系统的训练方式
——不仅仅是调整超参数,而是改进训练算法本身。
我们通过 AI4AI-Bench 直接测试了这一点:10 个真实的研究代码库,涵盖 10 个不同的算法家族。
完整解析 👇
GitHub: [https://t.co/s0f0NY7PdQ]
论文链接: [https://t.co/x0qY8wnlwB]
Einsia 网站:[https://t.co/Rewt4FJwl8]
📊 结果:
平均得分仅为 0.166。
即使表现最好的模型 Opus 5,也只有 0.288。
每个任务的中位探索成本从 1.69 美元上升到 34.60 美元。
#AI4AI #RecursiveSelfImprovement #AIResearch #AI4AI_Bench