Agent Arena前15模型表现与任务成本对比
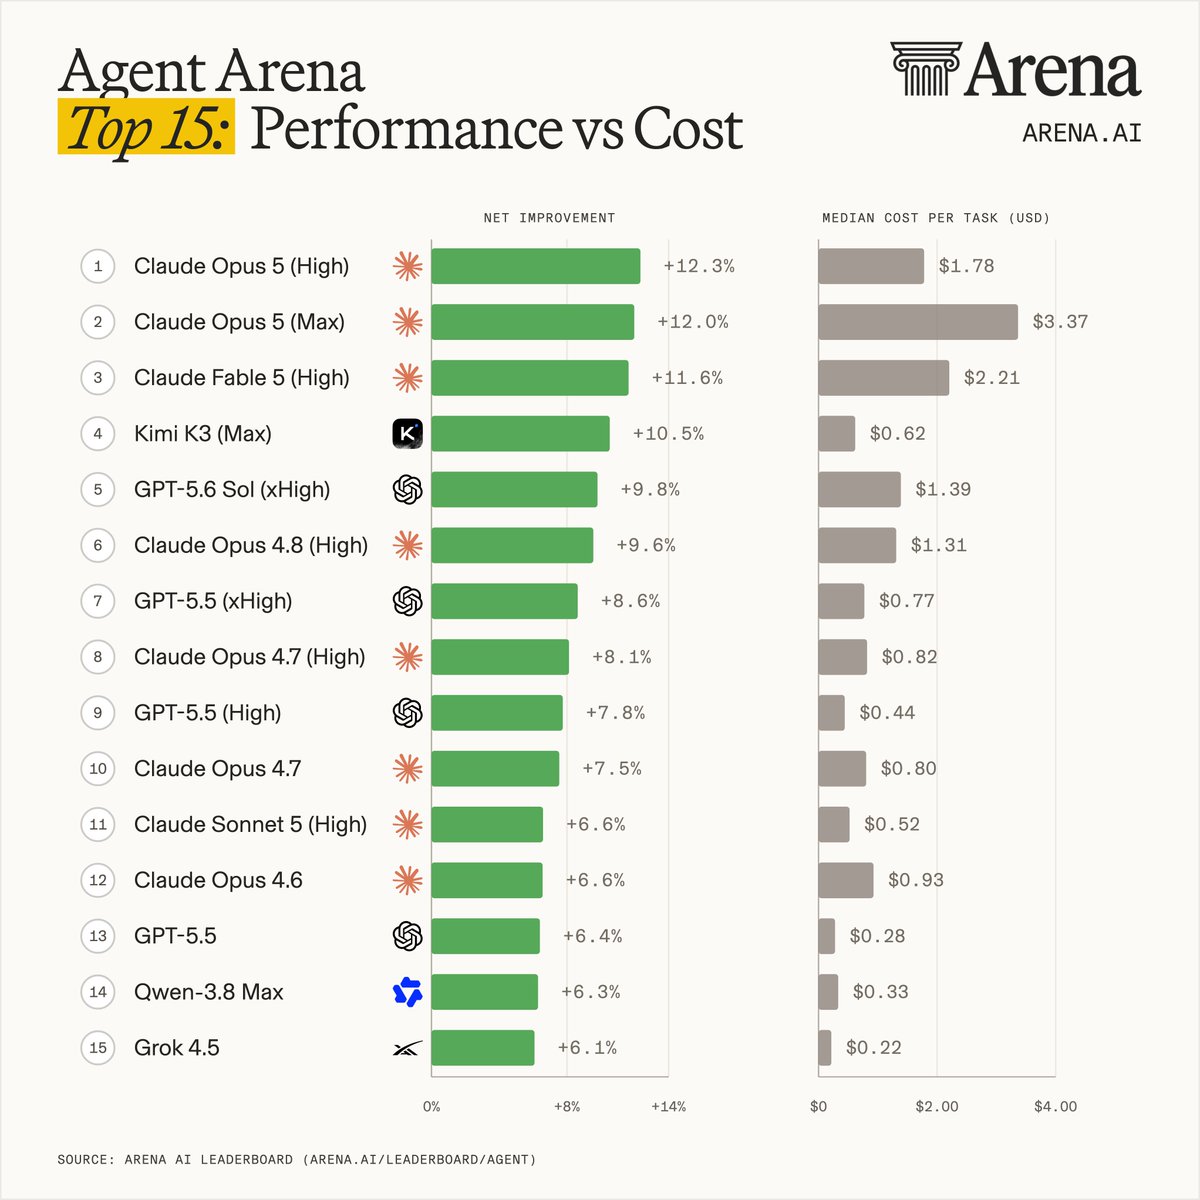
RT @arena: Agent Arena 前 15 名模型与任务中位成本对比:谁在性价比上最突出?
关键发现:
即使在排名前 5 的模型中,每个任务的中位成本也从 Kimi K3 (Max) 的 0.62 美元到 Claude Opus 5 (Max) 的 3.37 美元不等,相差超过 5 倍。
Claude Opus 5 (Max) 的成本几乎是 Opus 5 (High) 的两倍,尽管得分略低:
- Opus 5 (Max):+12.0%,每任务 3.37 美元
- Opus 5 (High):+12.3%,每任务 1.78 美元
Kimi K3 (Max) 在顶部附近以性价比脱颖而出。它排名第 4,净提升 +10.5%,而其 0.62 美元的中位任务成本是前八名中最低的。
GPT-5.6 Sol (xHigh) 是排名最高的 OpenAI 模型,位列第 5。其 1.39 美元的中位成本低于排名高于它的所有三个 Anthropic 模型,尽管其 +9.8% 的得分也较低。
Grok 和 Qwen 以最低的成本提供了有竞争力的性能:
- Grok 4.5 以每任务 0.22 美元实现 +6.1%
- Qwen-3.8 Max 以每任务 0.33 美元实现 +6.3%
Agent Arena 评估来自全球用户社区的数百万个真实世界、长期代理任务。模型使用网络搜索、文件系统访问和终端命令等工具完成复杂工作流。
性能以净提升来衡量,使用因果追踪方法估计每个模型相对于平均模型改善结果的程度。成本以每个任务的中位成本来衡量。